Vision Language Action System Nvidia
Utilize our extensive Vision Language Action System Nvidia resource library containing substantial collections of high-quality images. optimized for both digital and print applications across multiple platforms. supporting commercial, educational, and research applications. Our Vision Language Action System Nvidia collection features high-quality images with excellent detail and clarity. Perfect for marketing materials, corporate presentations, advertising campaigns, and professional publications All Vision Language Action System Nvidia images are available in high resolution with professional-grade quality, optimized for both digital and print applications, and include comprehensive metadata for easy organization and usage. Each Vision Language Action System Nvidia image meets rigorous quality standards for commercial applications. Professional licensing options accommodate both commercial and educational usage requirements. The Vision Language Action System Nvidia archive serves professionals, educators, and creatives across diverse industries. Reliable customer support ensures smooth experience throughout the Vision Language Action System Nvidia selection process. Cost-effective licensing makes professional Vision Language Action System Nvidia photography accessible to all budgets. Instant download capabilities enable immediate access to chosen Vision Language Action System Nvidia images. Regular updates keep the Vision Language Action System Nvidia collection current with contemporary trends and styles. The Vision Language Action System Nvidia collection represents years of careful curation and professional standards.
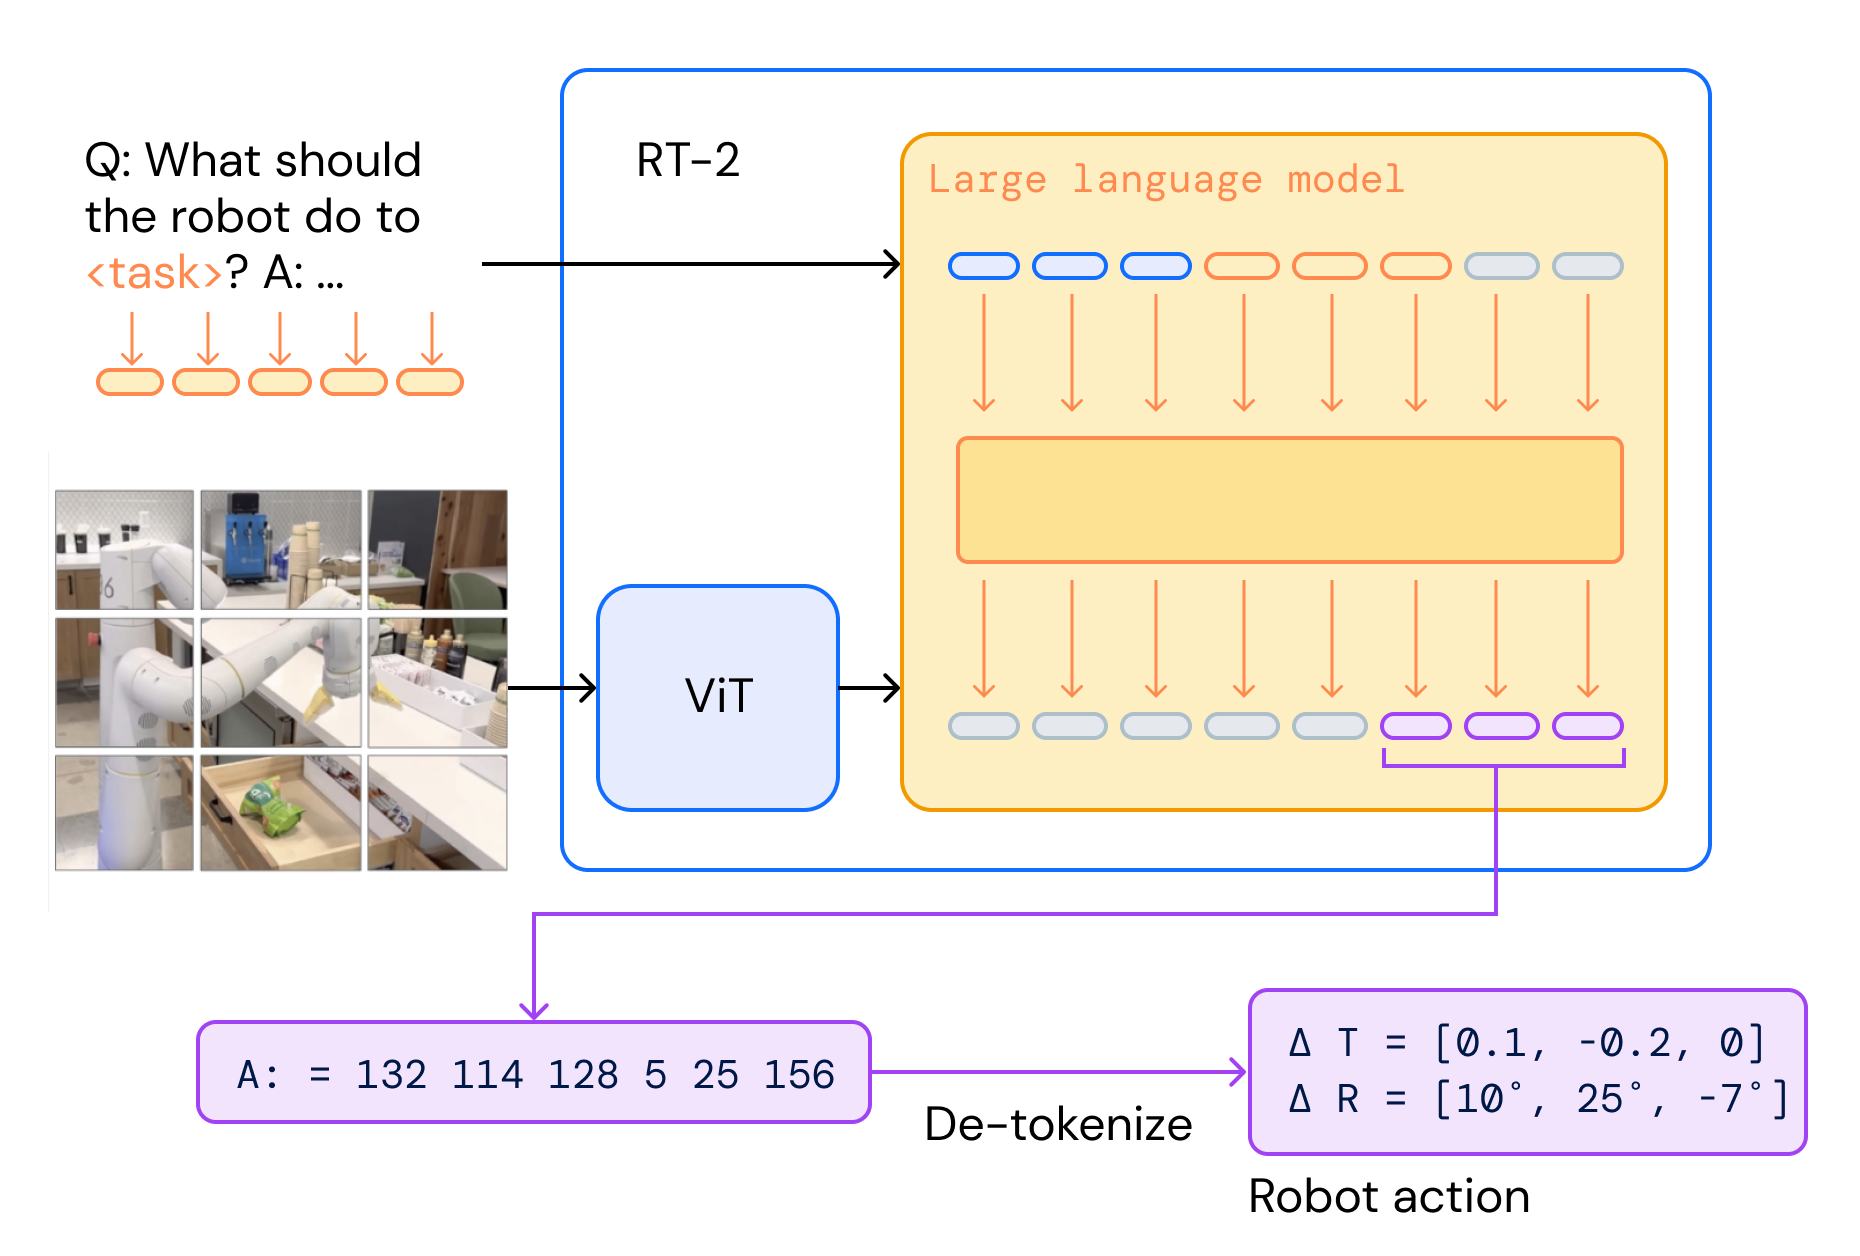
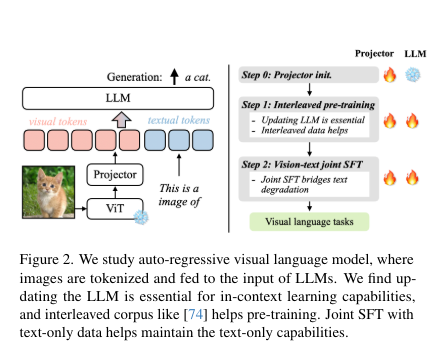
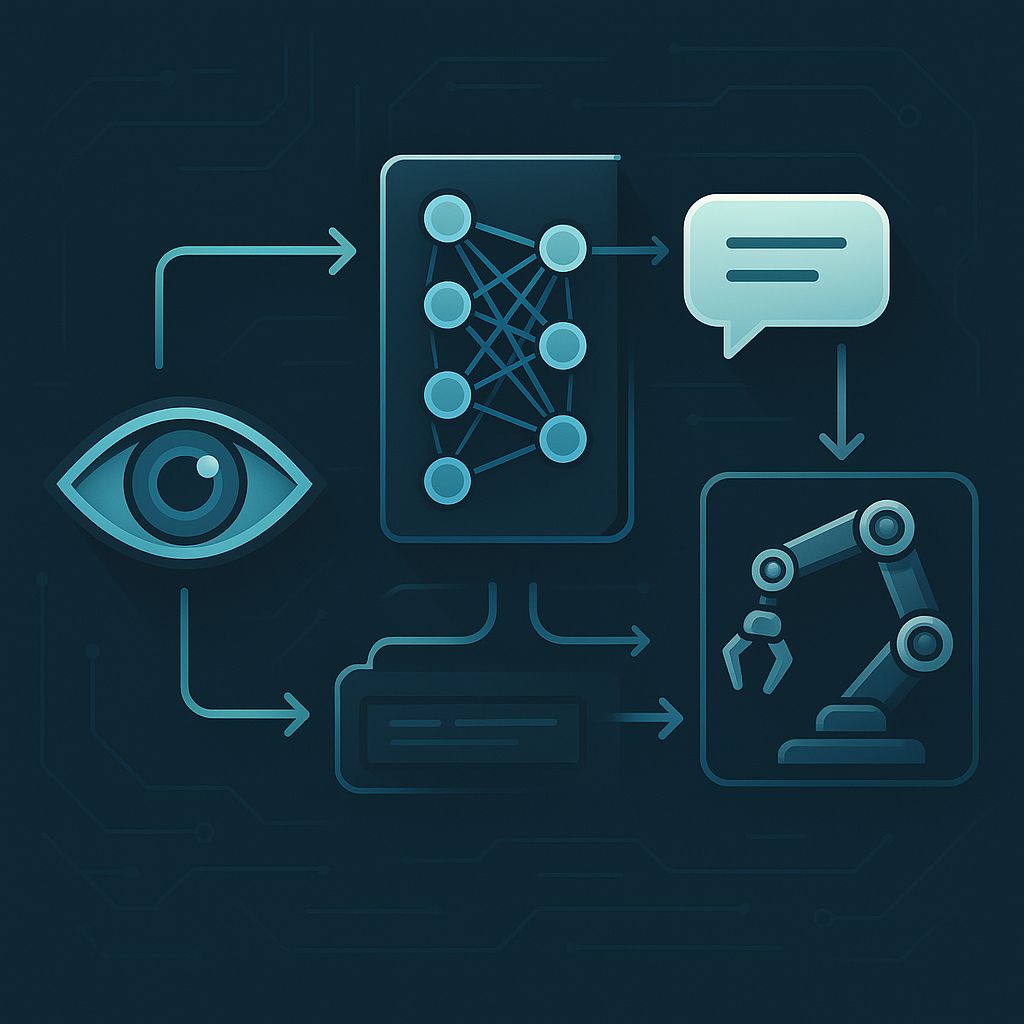


![Vision Language Action System Nvidia [논문 리뷰] RoboNurse-VLA: Robotic Scrub Nurse System based on Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/robonurse-vla-robotic-scrub-nurse-system-based-on-vision-language-action-model-0.png)


![Vision Language Action System Nvidia [논문 리뷰] Model-agnostic Adversarial Attack and Defense for Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/model-agnostic-adversarial-attack-and-defense-for-vision-language-action-models-2.png)
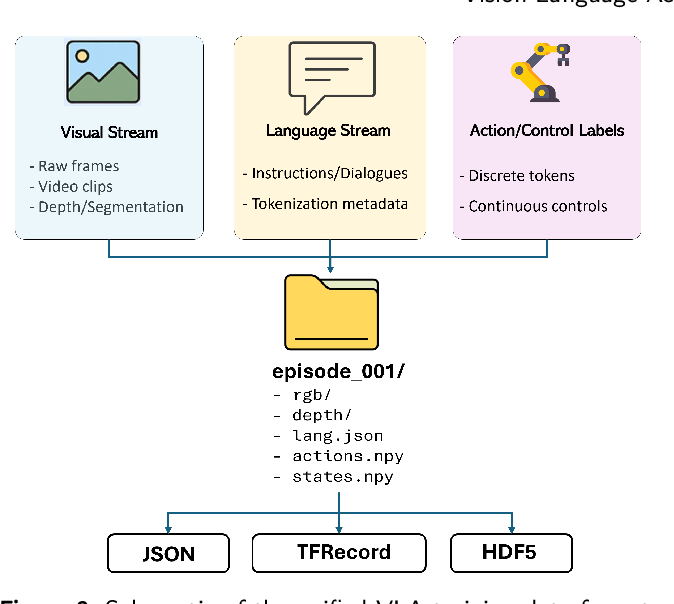
![Vision Language Action System Nvidia [논문 리뷰] UAV-VLA: Vision-Language-Action System for Large Scale Aerial ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/uav-vla-vision-language-action-system-for-large-scale-aerial-mission-generation-0.png)


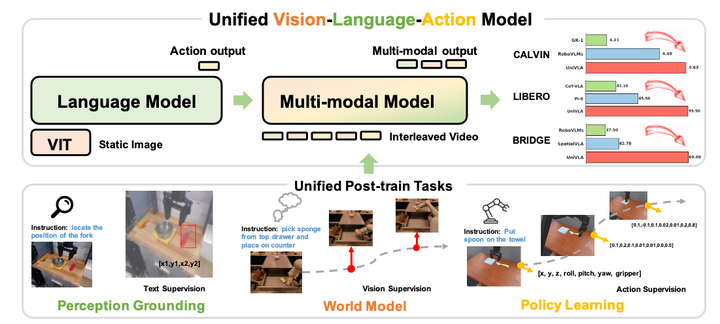
![Vision Language Action System Nvidia [论文评述] TriVLA: A Triple-System-Based Unified Vision-Language-Action ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/trivla-a-triple-system-based-unified-vision-language-action-model-for-general-robot-control-1.png)

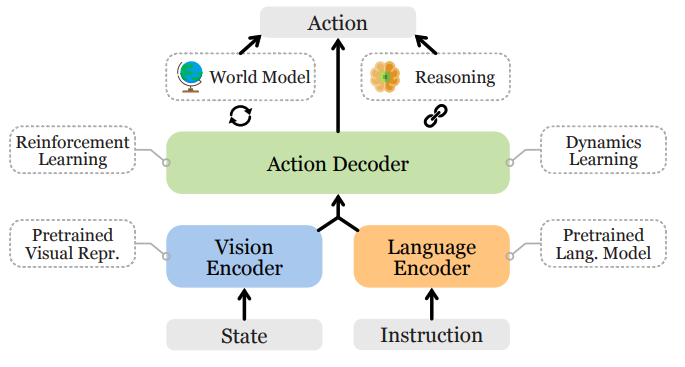
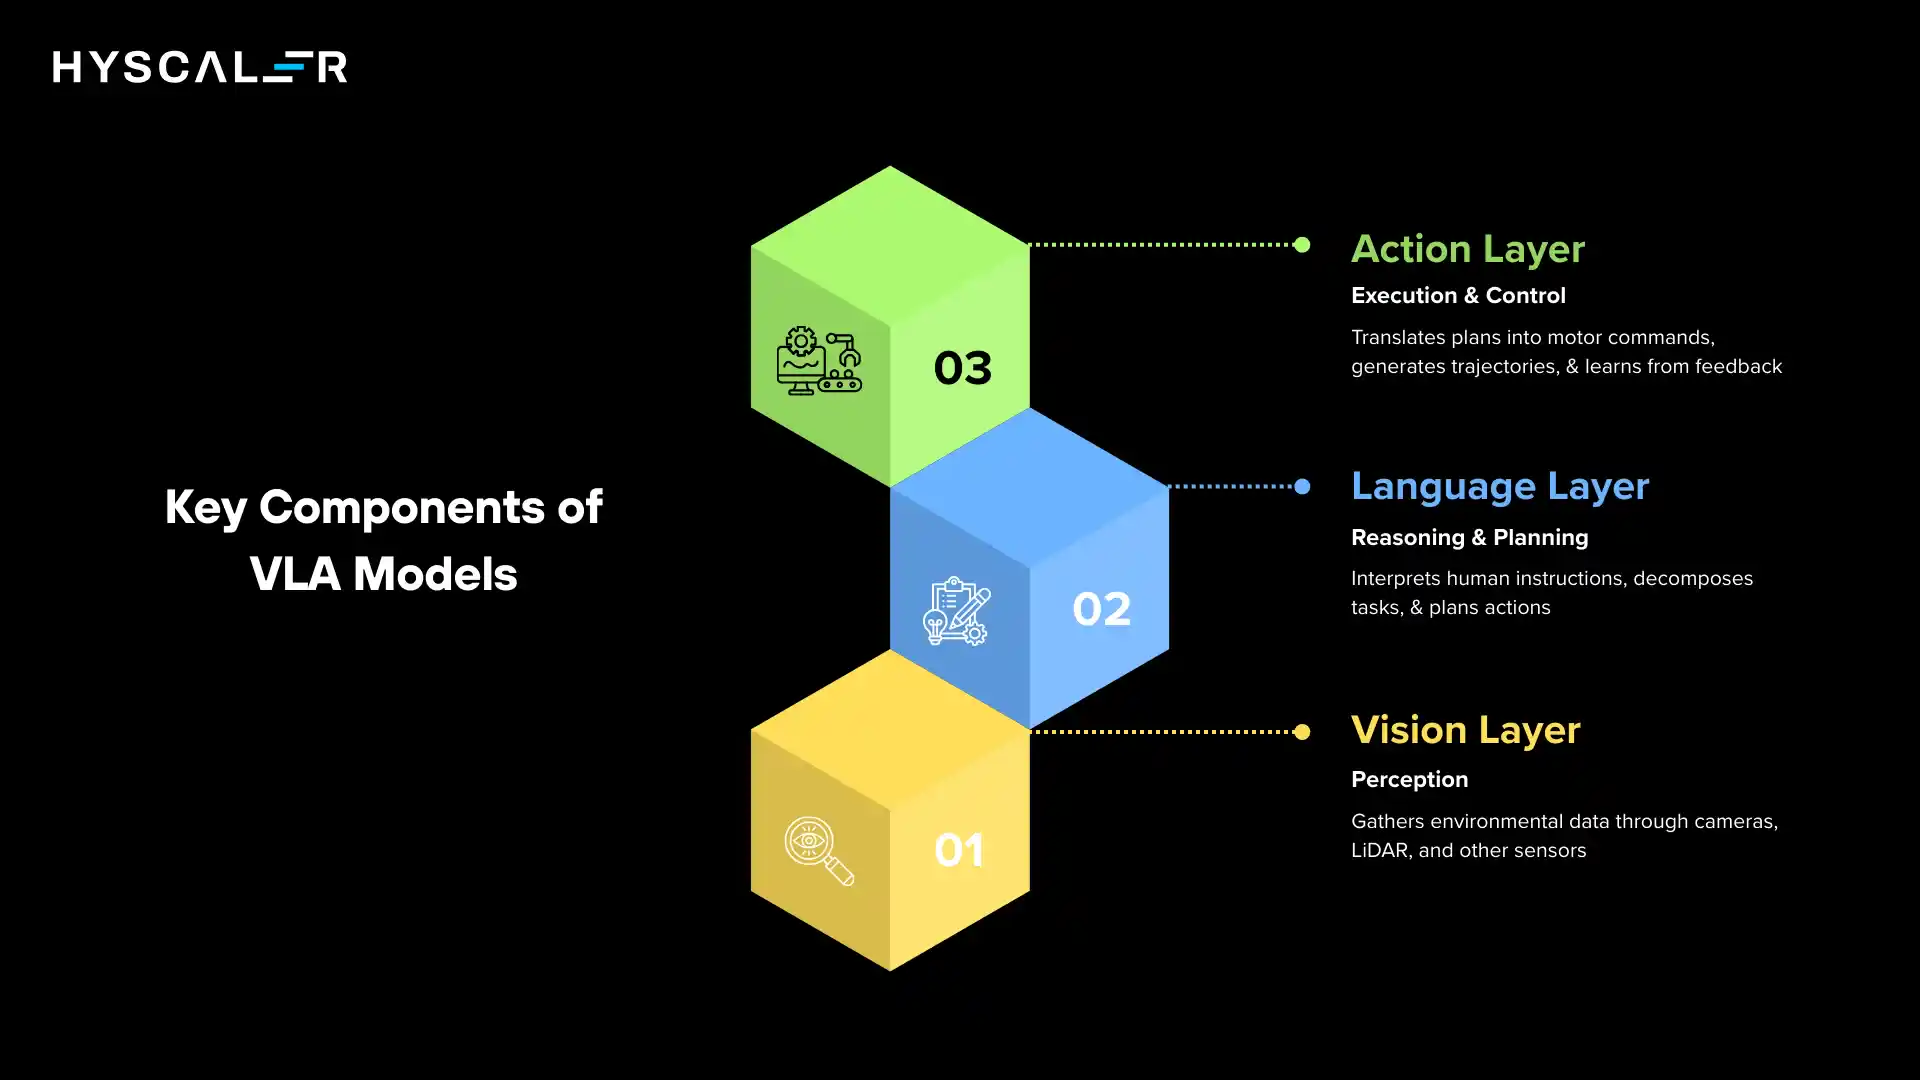
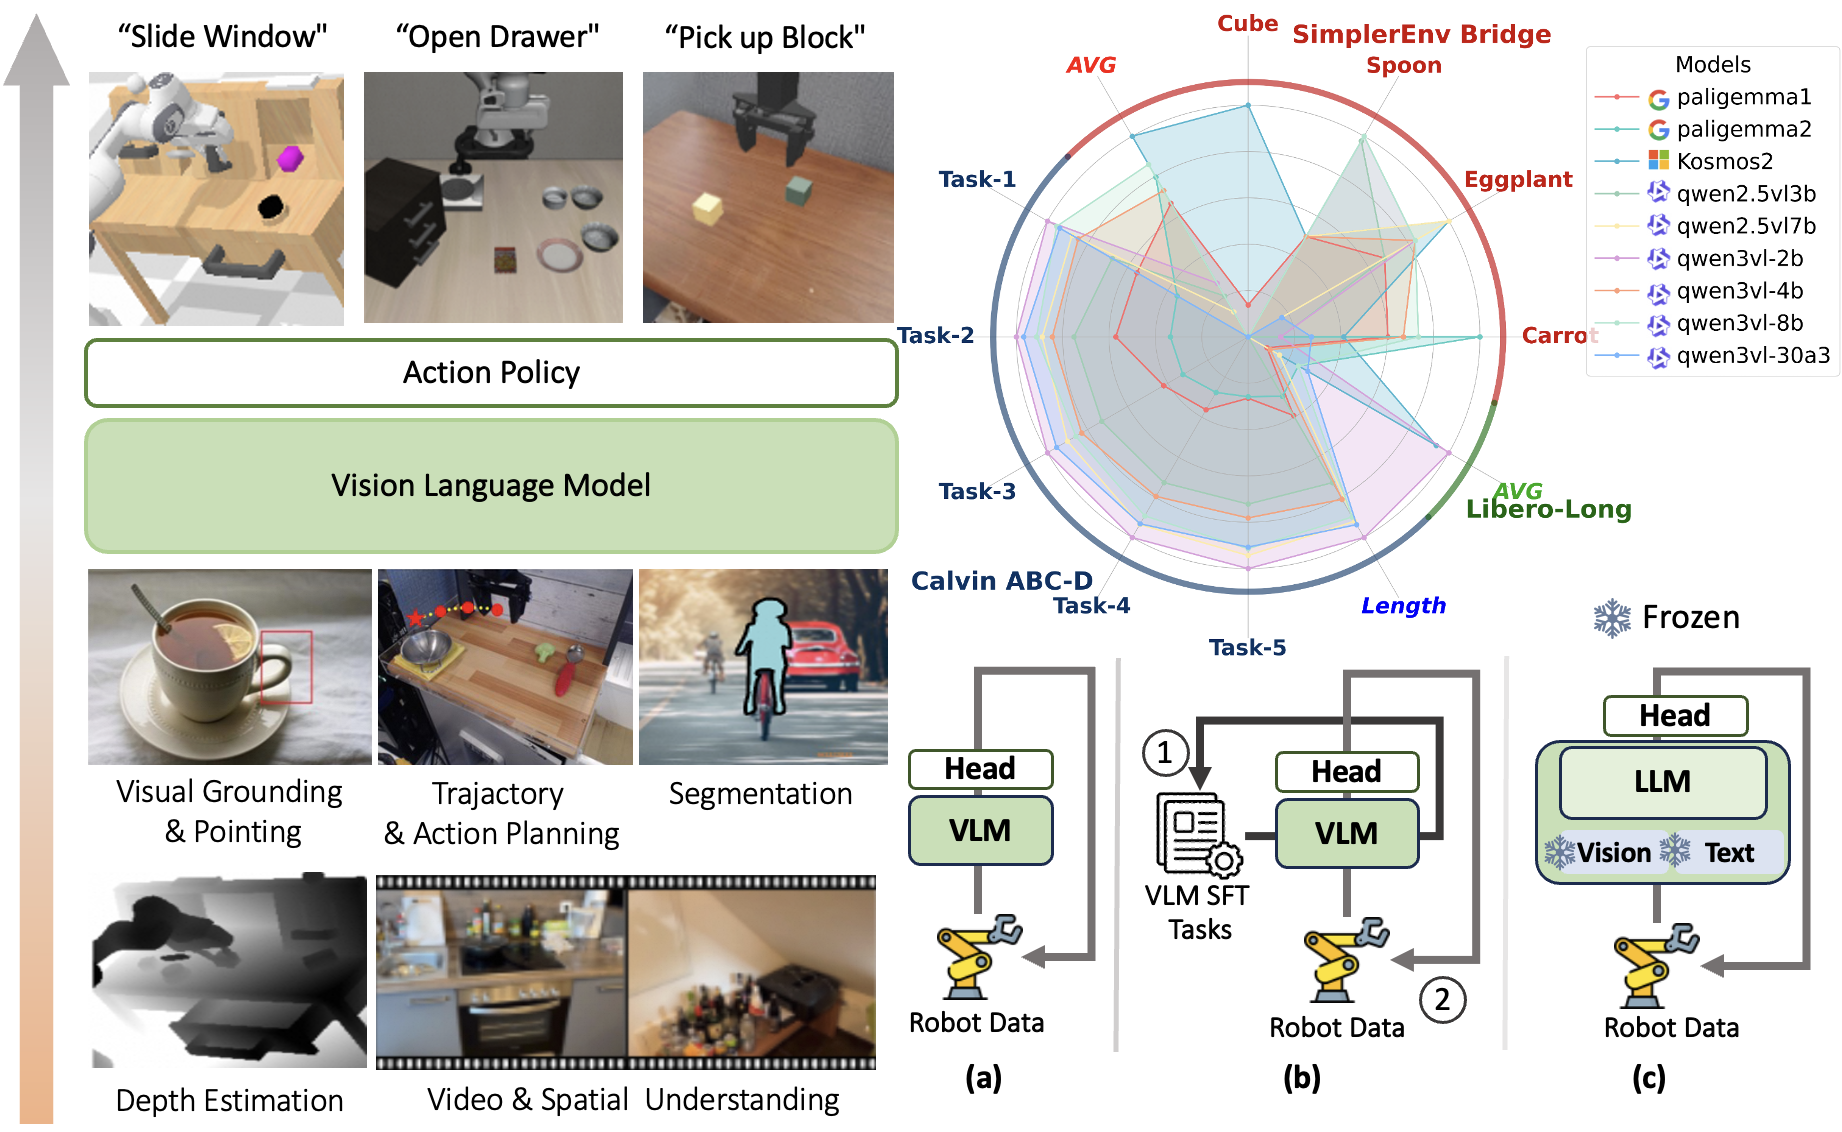
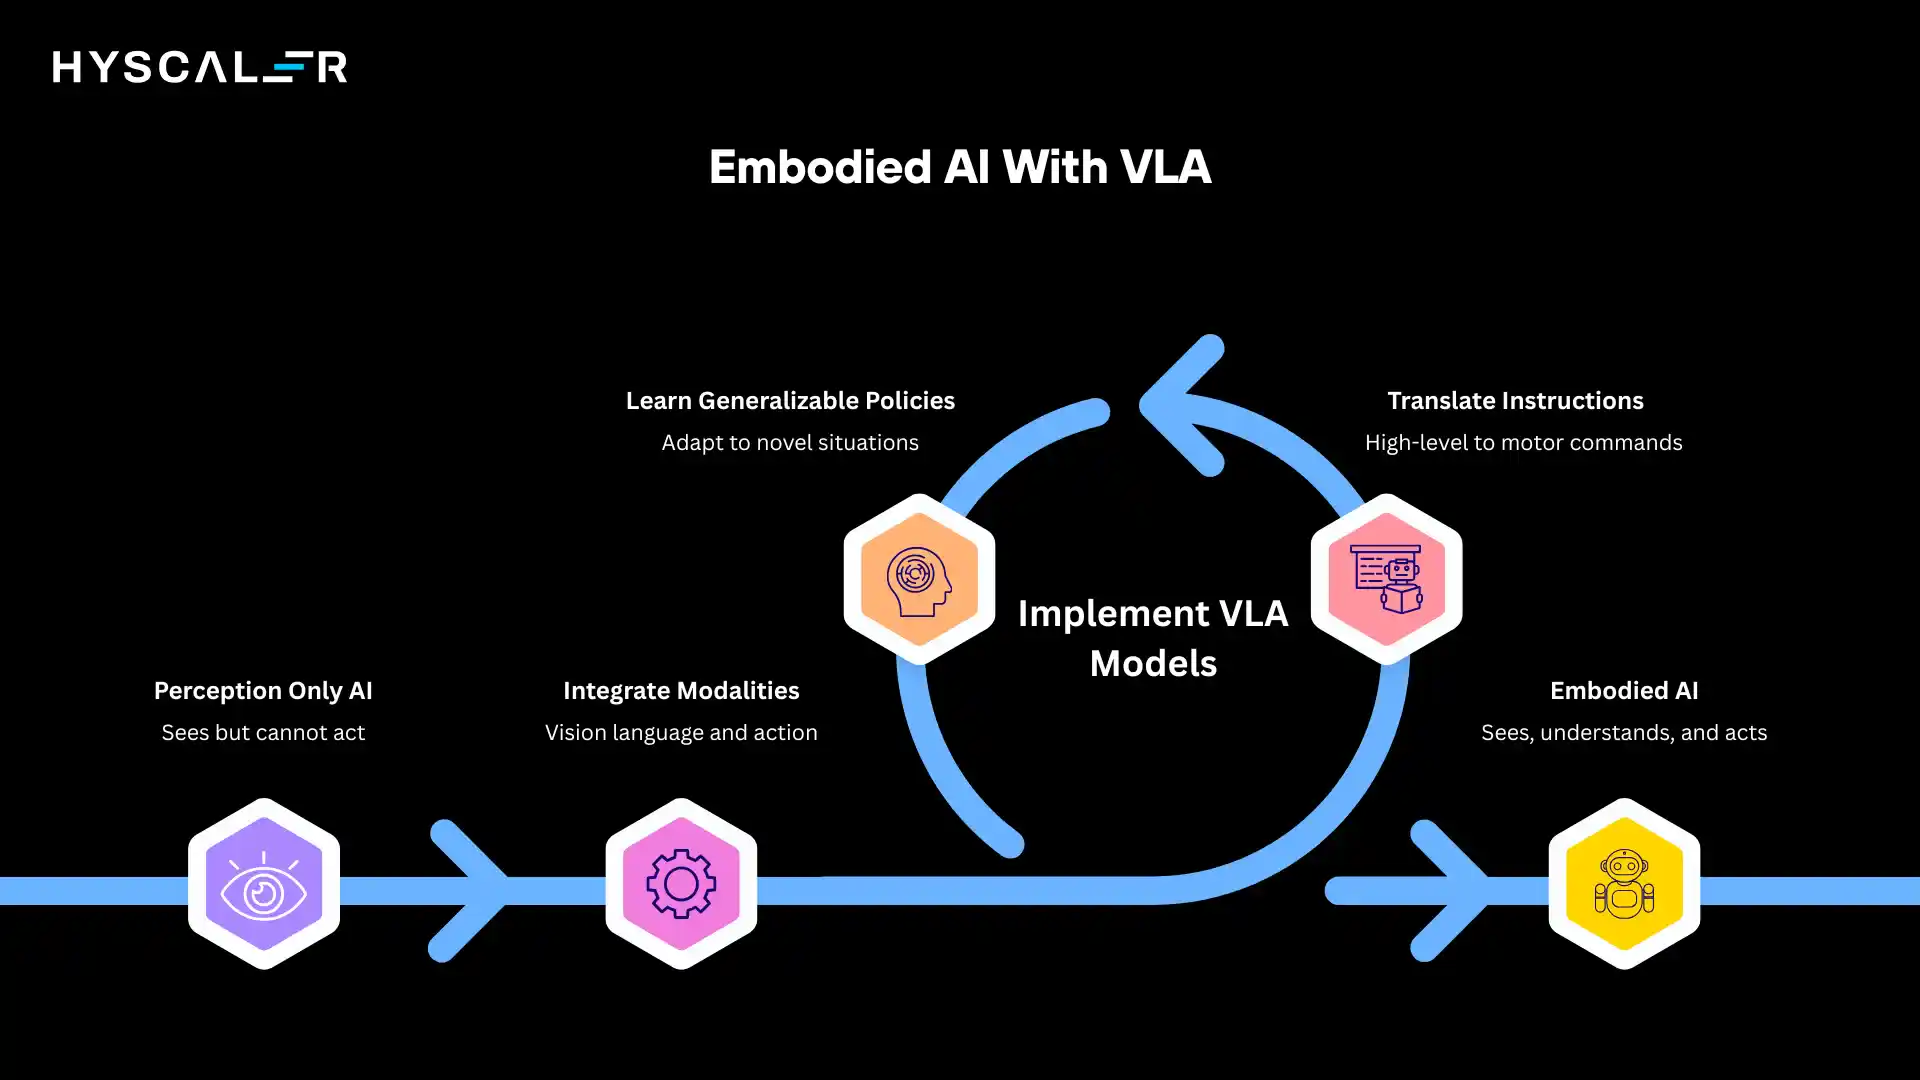
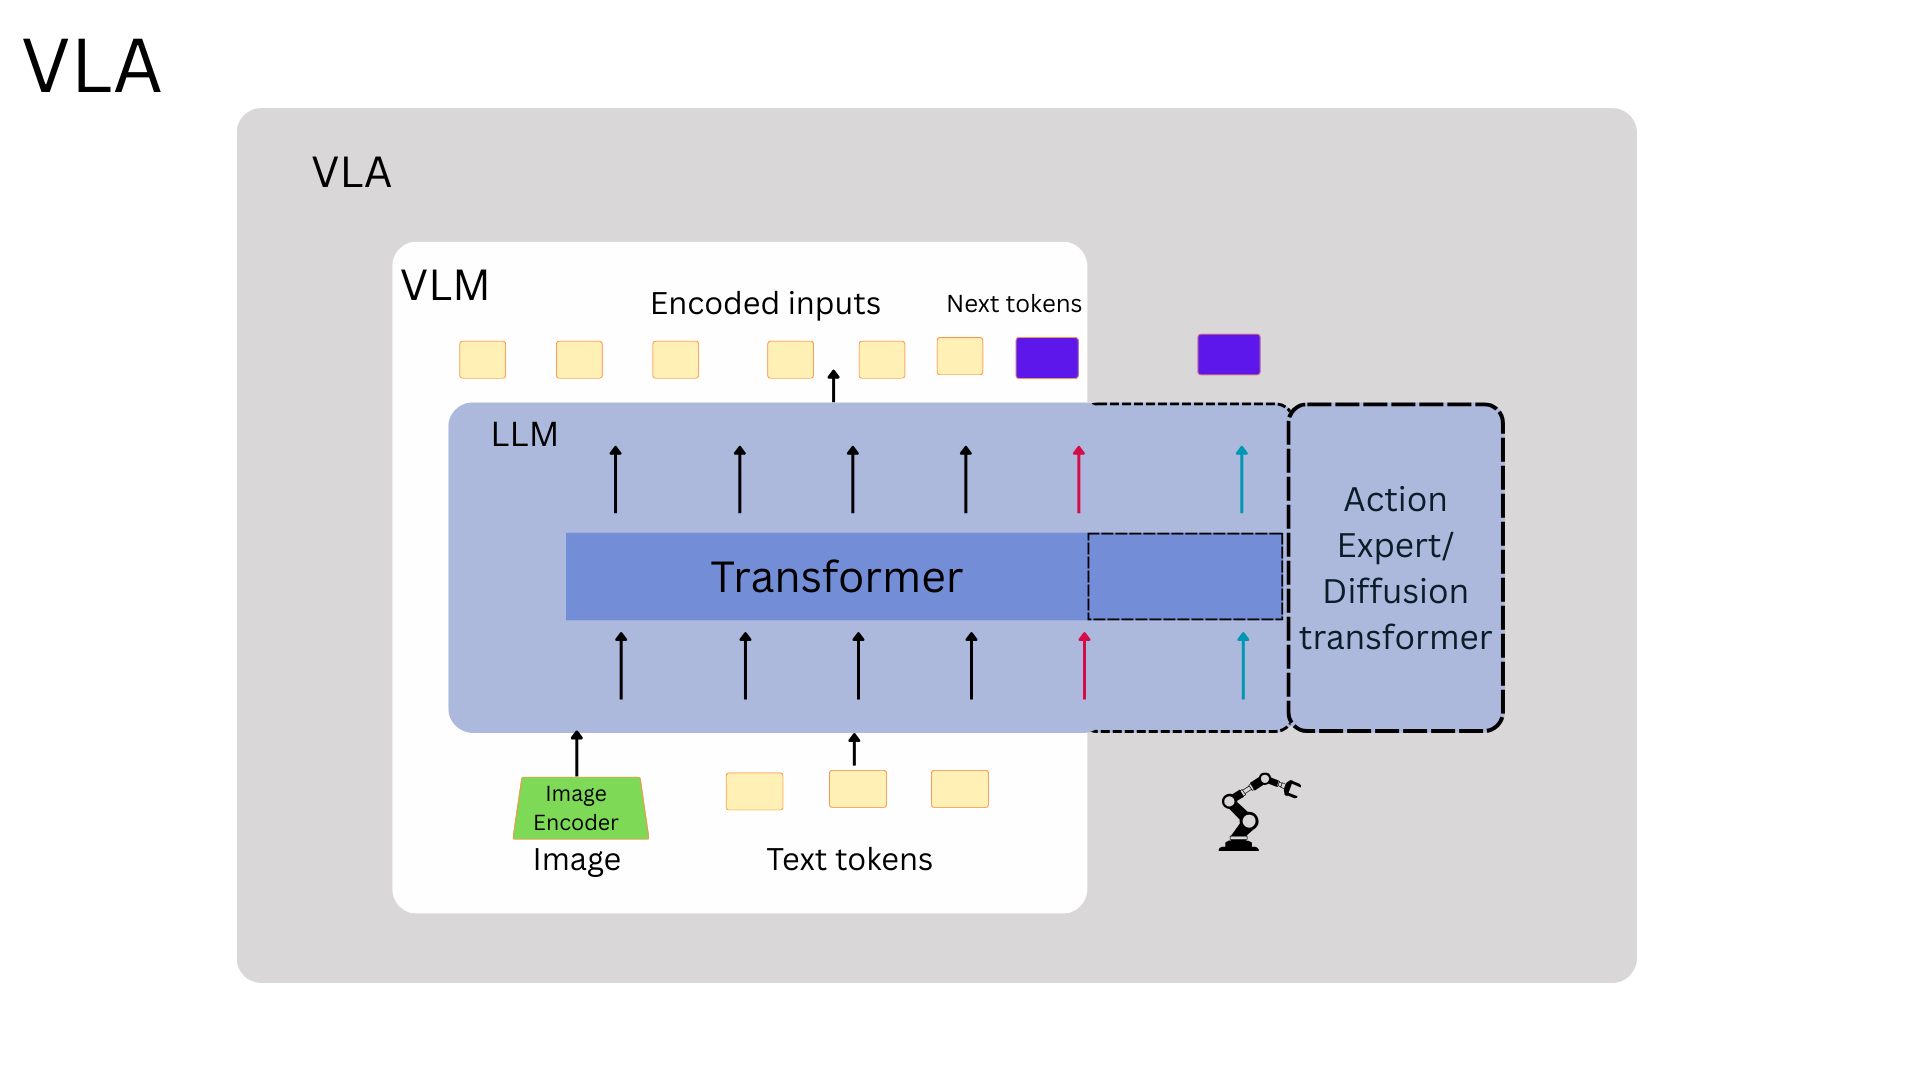
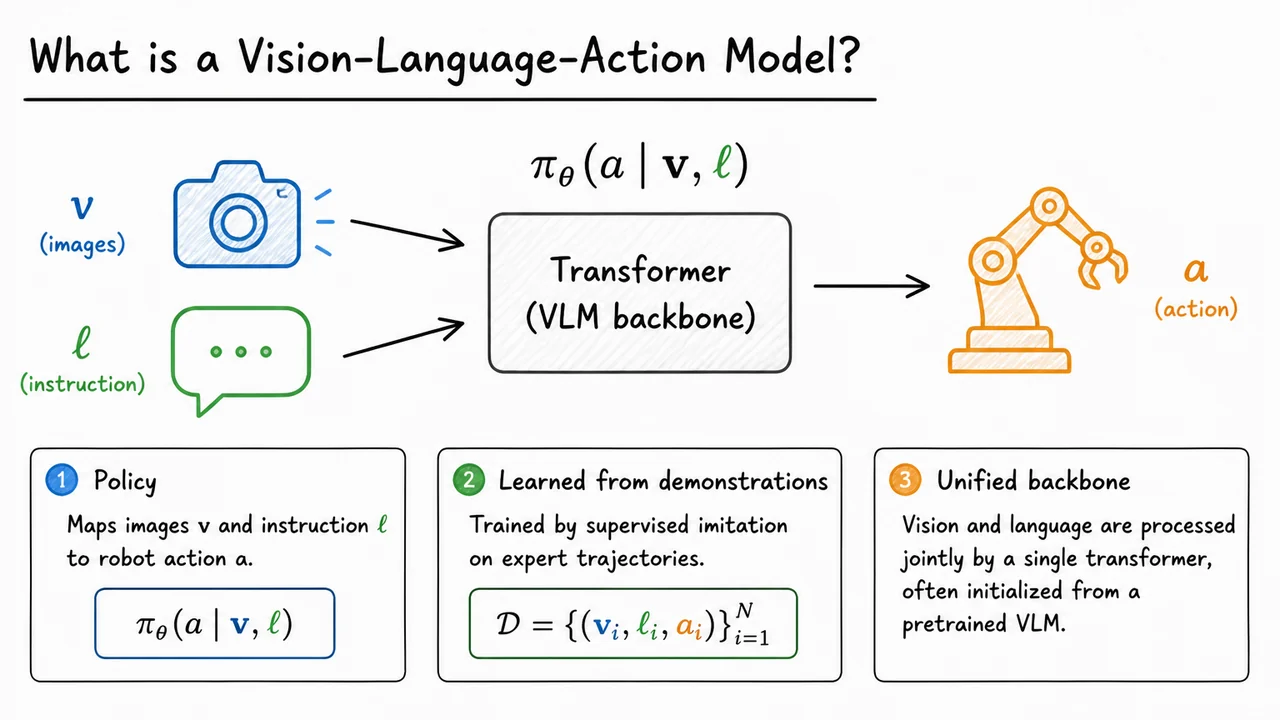
![Vision Language Action System Nvidia [论文评述] Vision-Language-Action Models: Concepts, Progress, Applications ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/vision-language-action-models-concepts-progress-applications-and-challenges-0.png)


![Vision Language Action System Nvidia [논문 리뷰] GeneralVLA: Generalizable Vision-Language-Action Models with ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/generalvla-generalizable-vision-language-action-models-with-knowledge-guided-trajectory-planning-0.png)


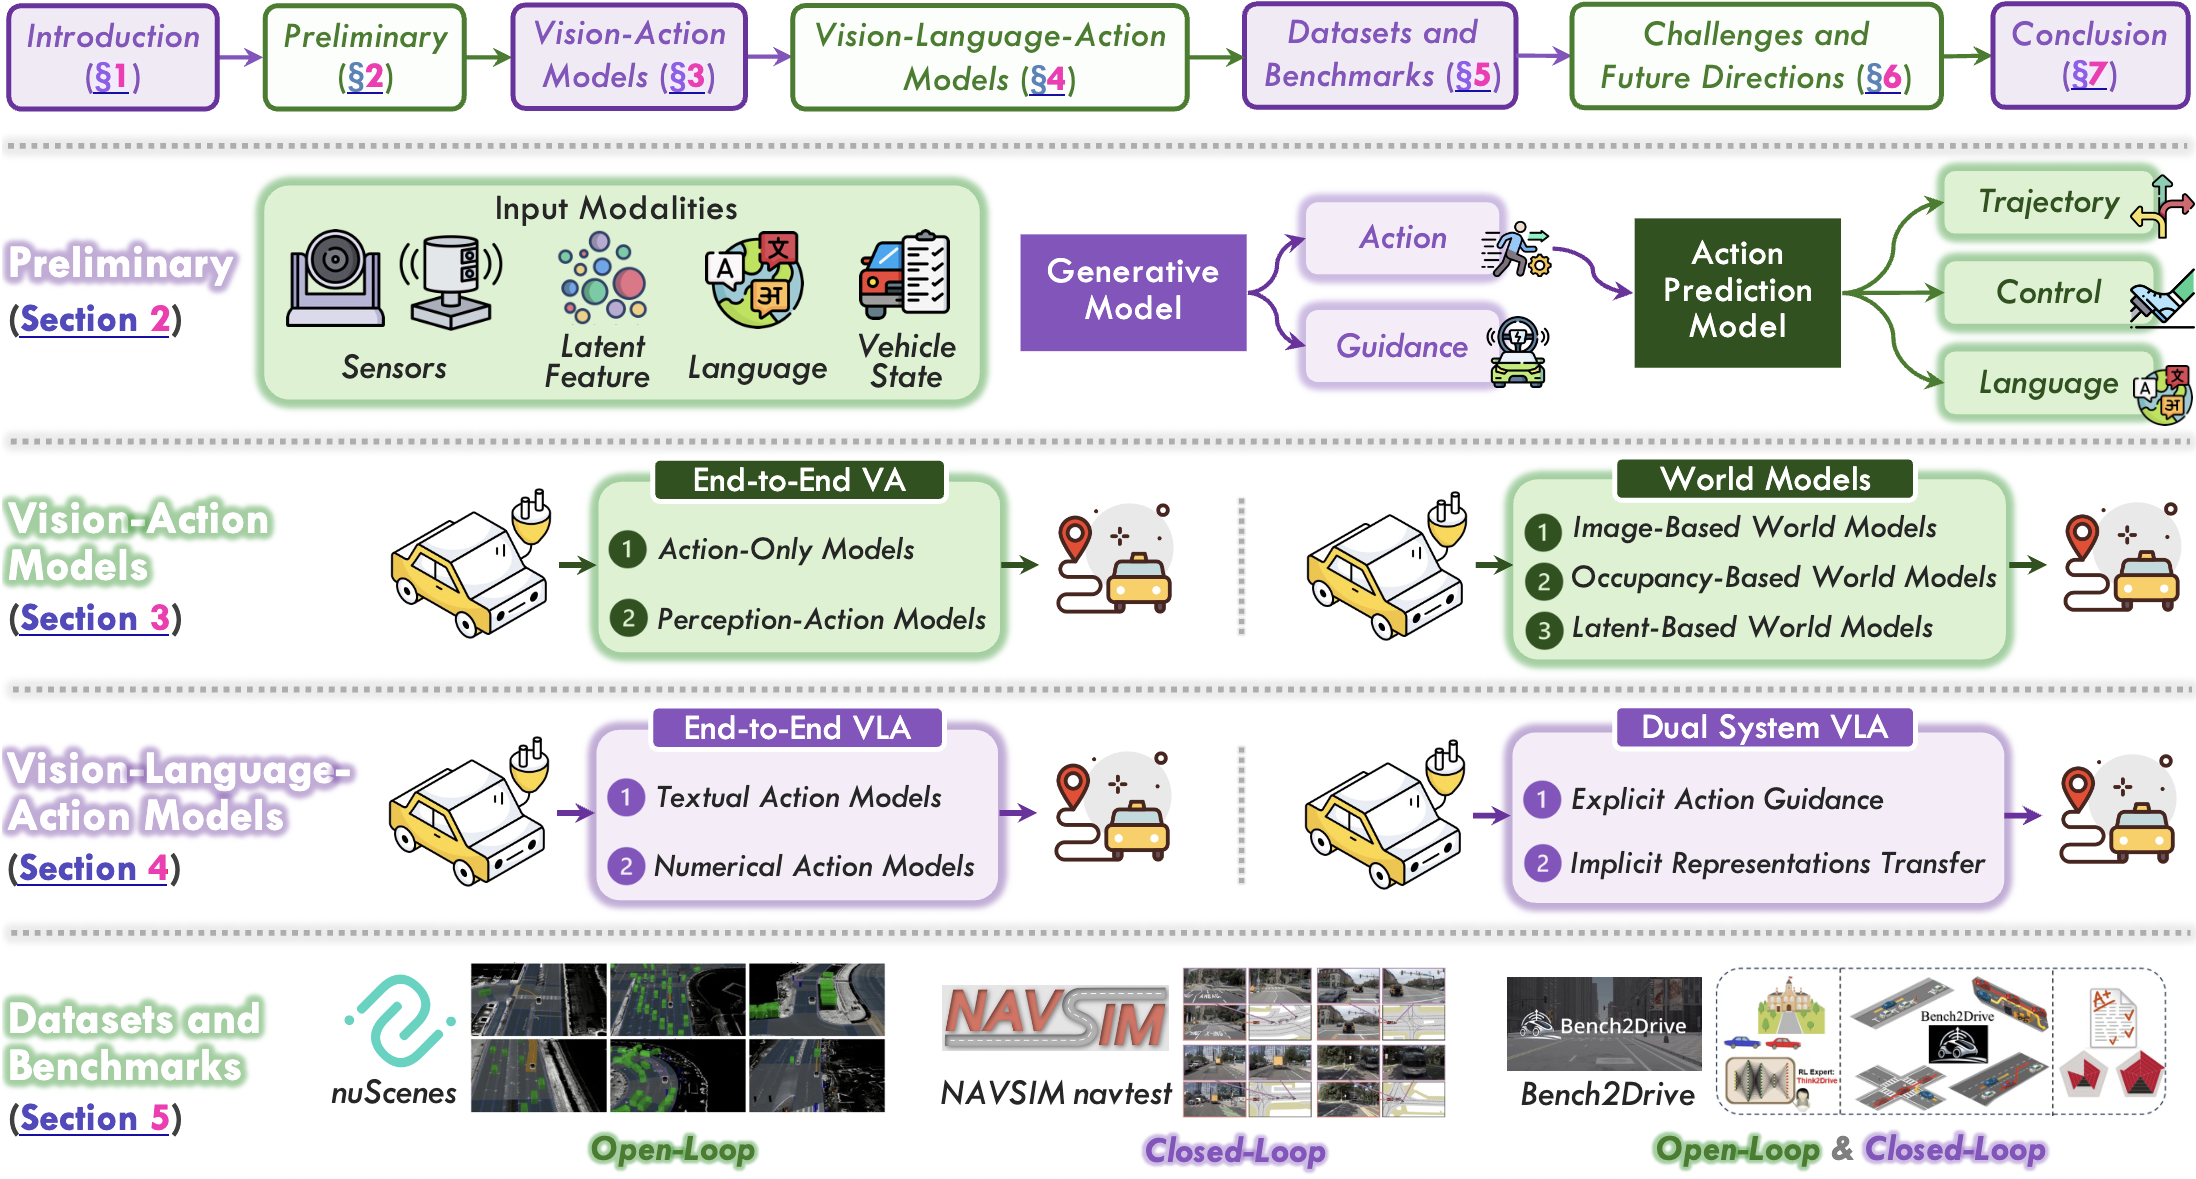
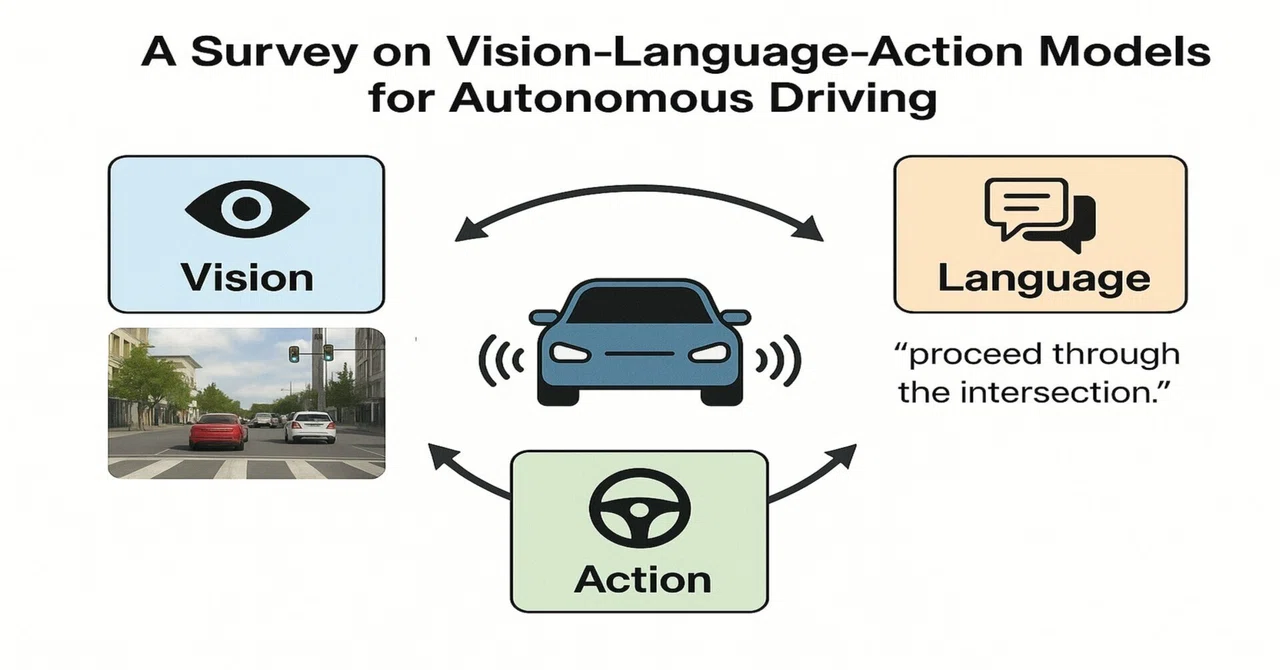
![Vision Language Action System Nvidia [论文评述] A Survey on Vision-Language-Action Models for Autonomous Driving](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/a-survey-on-vision-language-action-models-for-autonomous-driving-1.png)

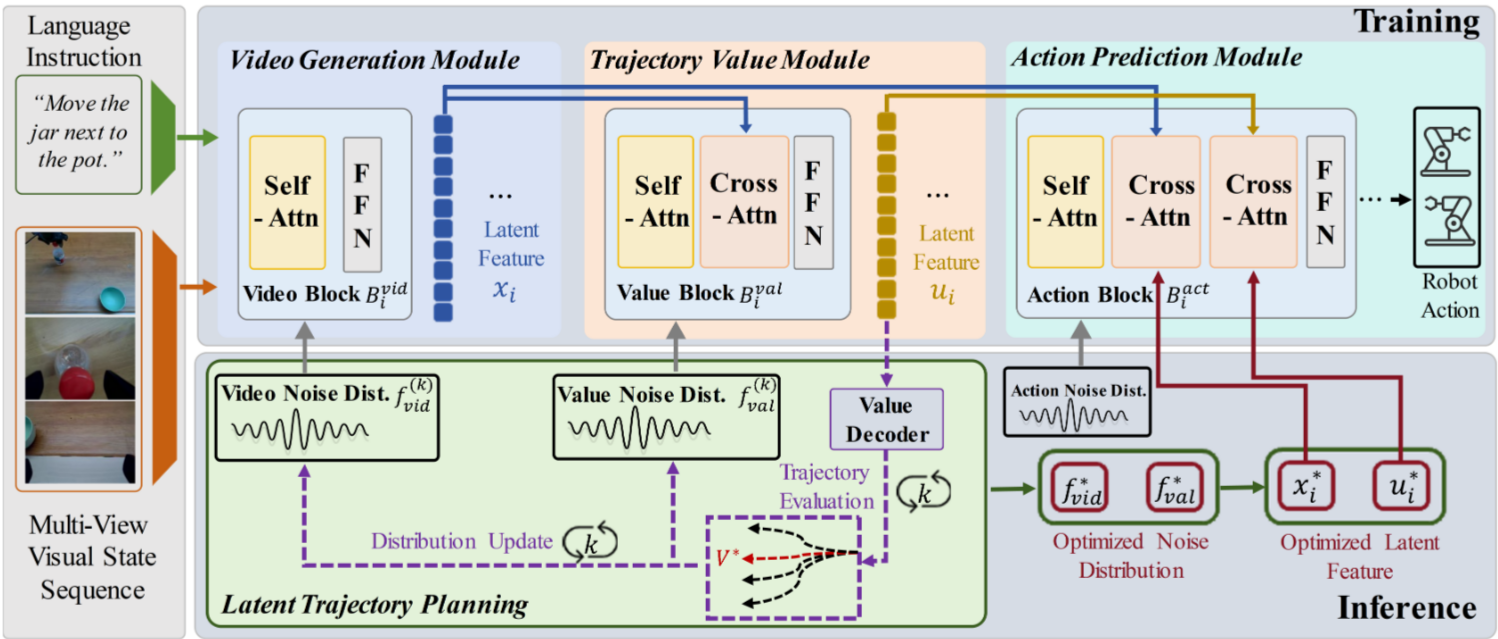
![Vision Language Action System Nvidia [논문 리뷰] World-Value-Action Model: Implicit Planning for Vision-Language ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/world-value-action-model-implicit-planning-for-vision-language-action-systems-4.png)


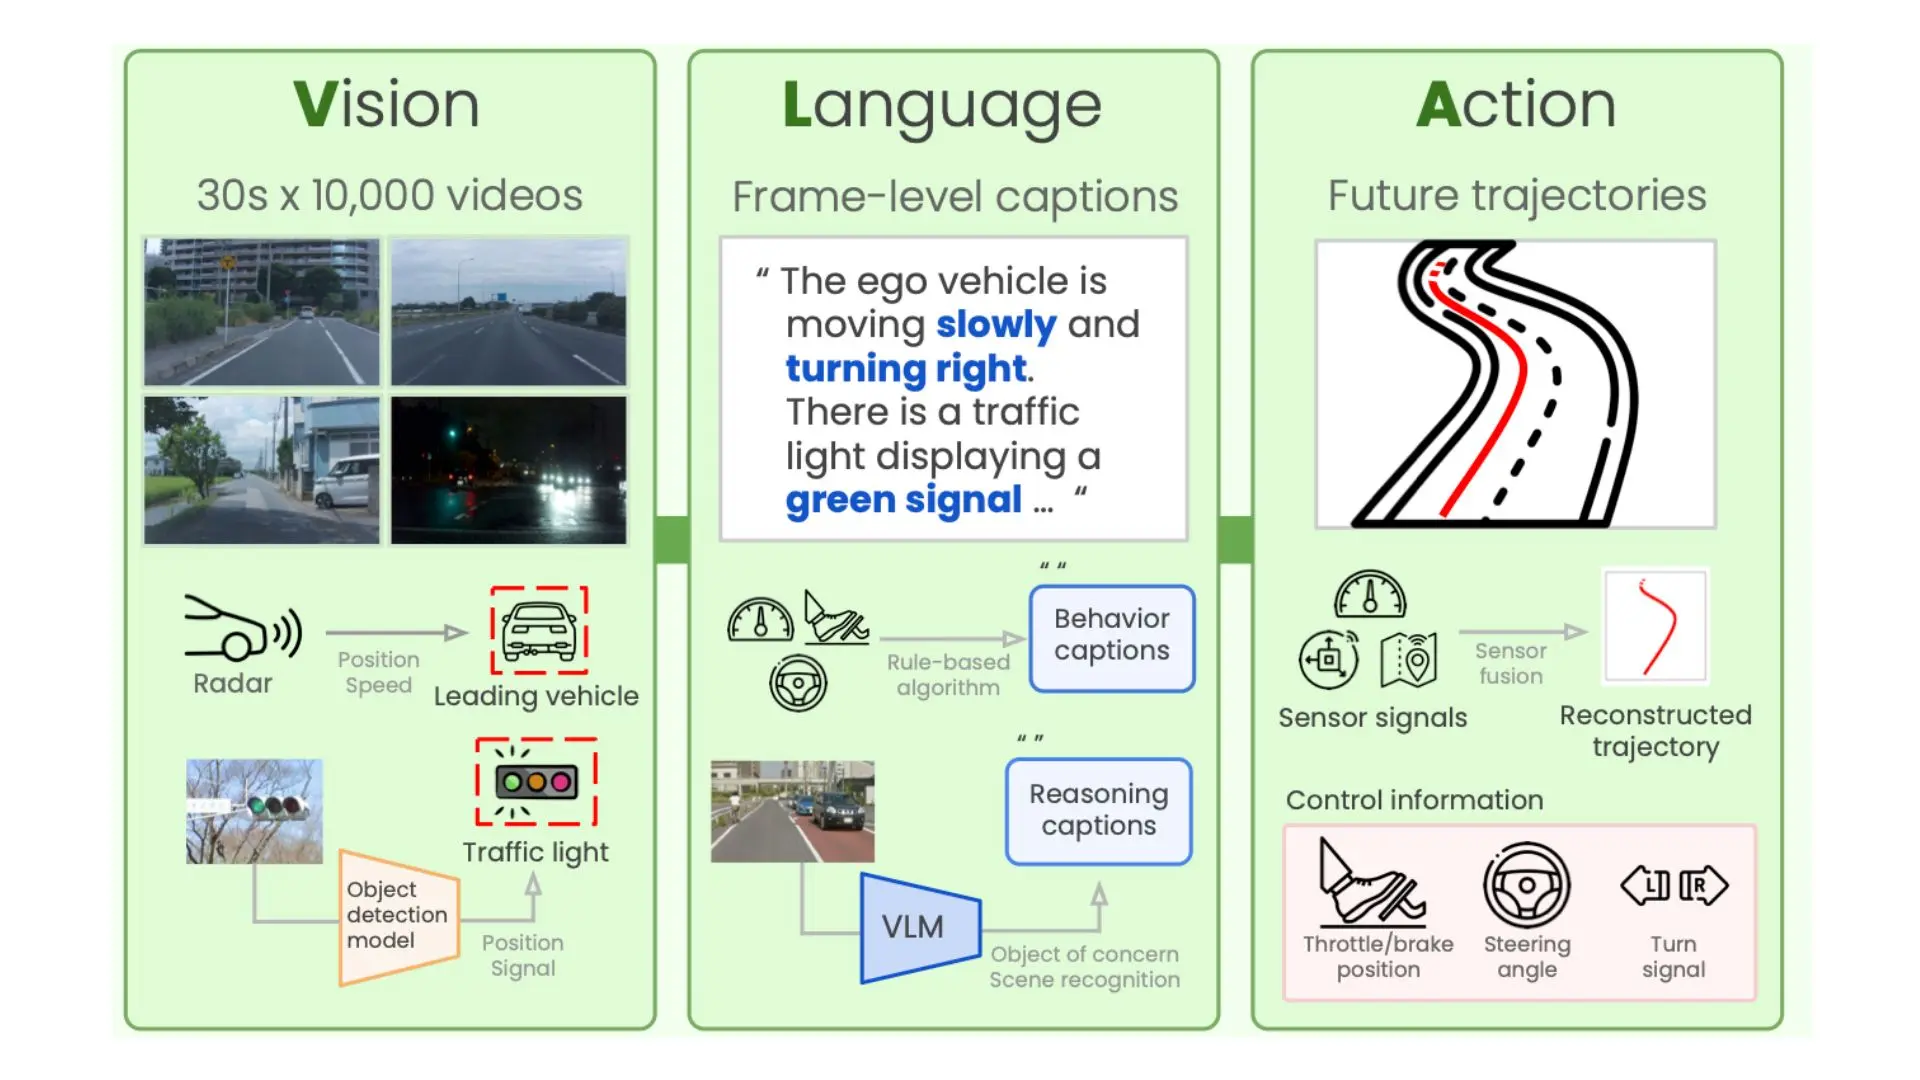
![Vision Language Action System Nvidia [논문 리뷰] CoVLA: Comprehensive Vision-Language-Action Dataset for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/covla-comprehensive-vision-language-action-dataset-for-autonomous-driving-0.png)


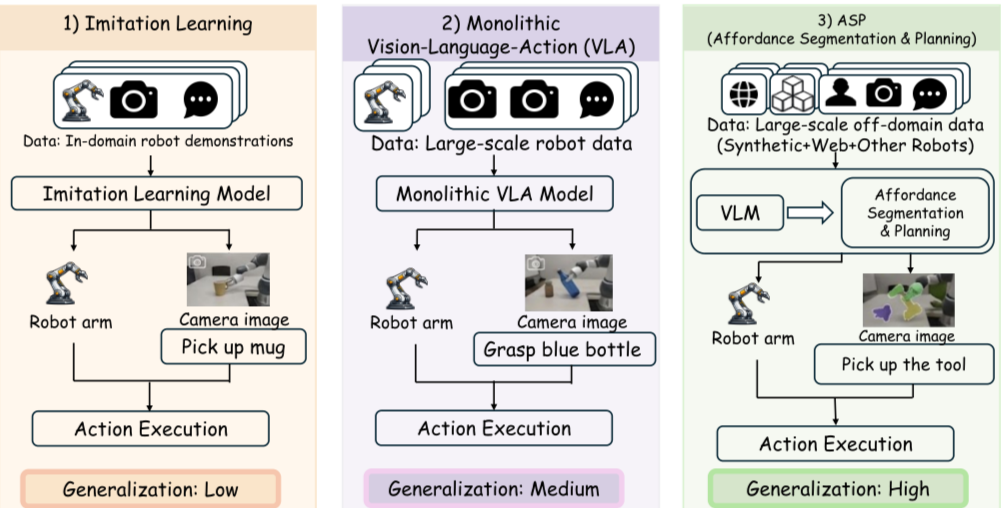
![Vision Language Action System Nvidia [논문 리뷰] Improving Vision-Language-Action Models via Chain-of-Affordance](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/improving-vision-language-action-models-via-chain-of-affordance-0.png)
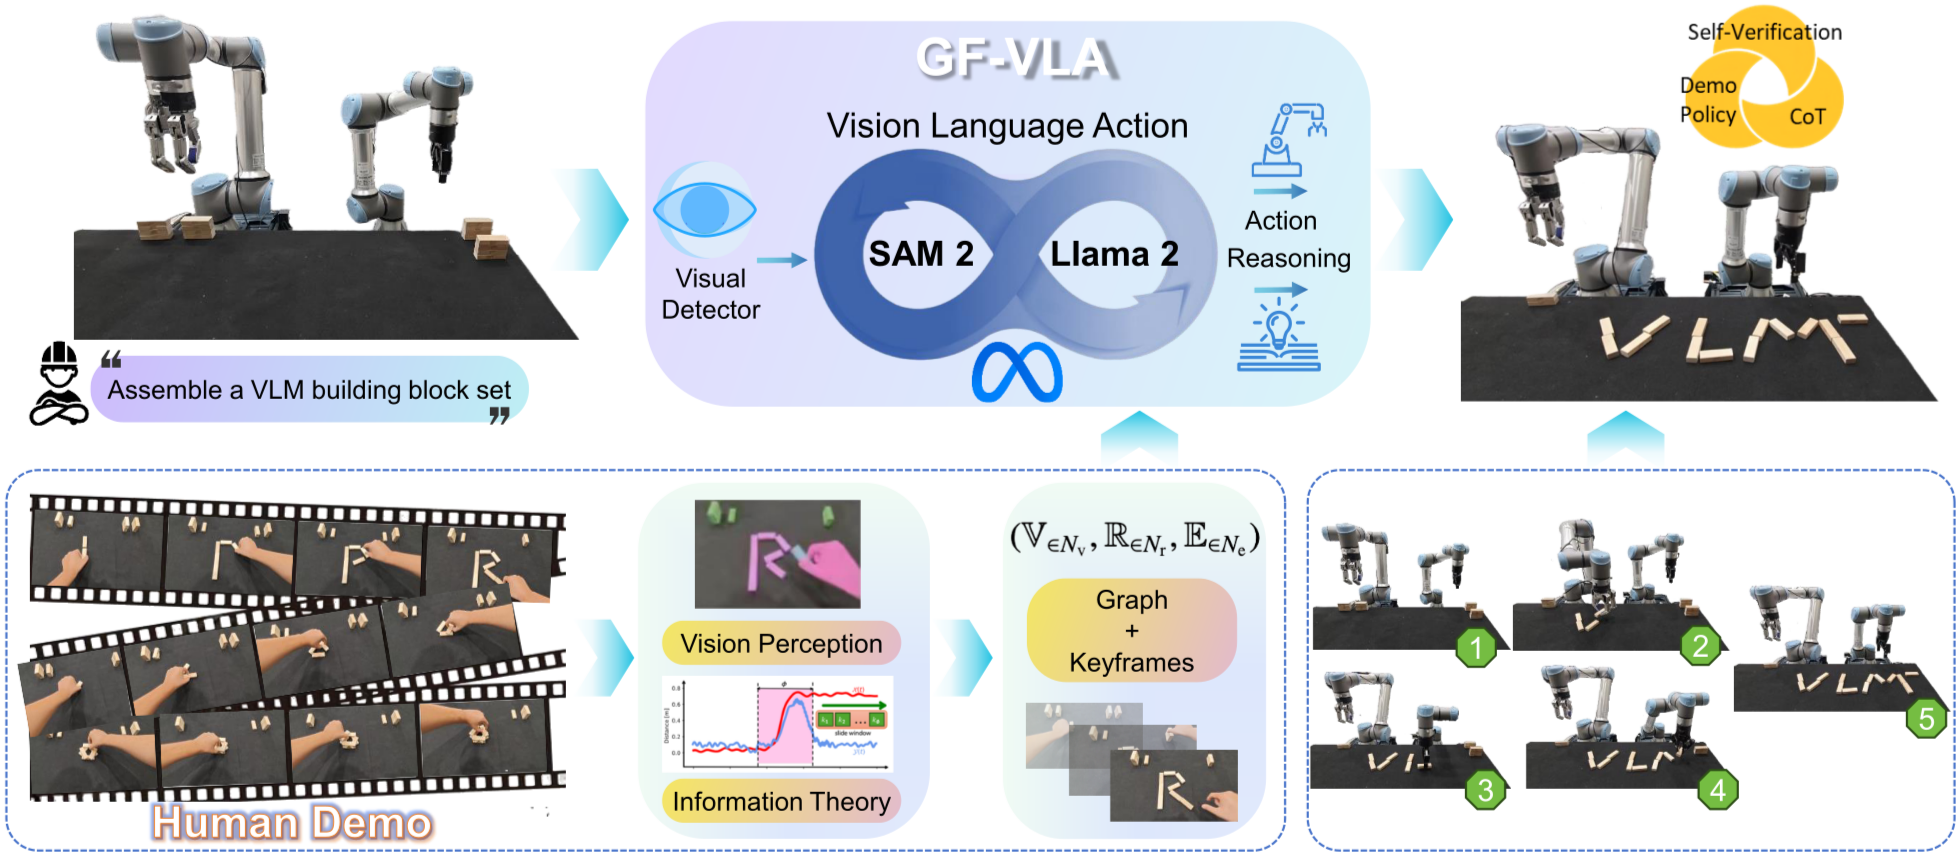
![Vision Language Action System Nvidia [논문 리뷰] Graph-Fused Vision-Language-Action for Policy Reasoning in ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/graph-fused-vision-language-action-for-policy-reasoning-in-multi-arm-robotic-manipulation-1.png)
![Vision Language Action System Nvidia [論文レビュー] OpenDriveVLA: Towards End-to-end Autonomous Driving with Large ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/opendrivevla-towards-end-to-end-autonomous-driving-with-large-vision-language-action-model-0.png)