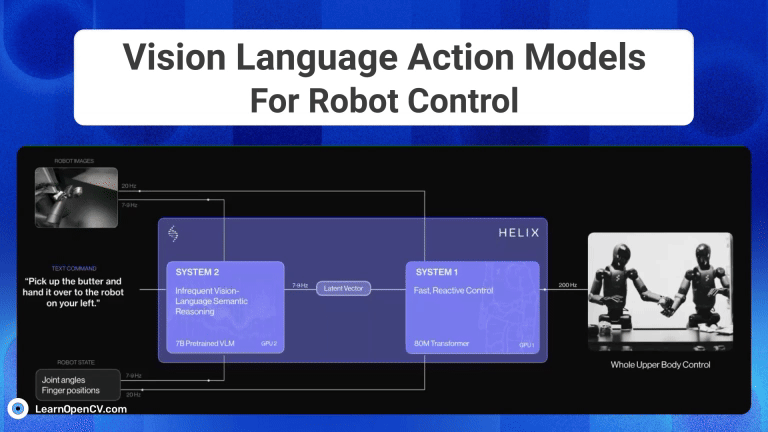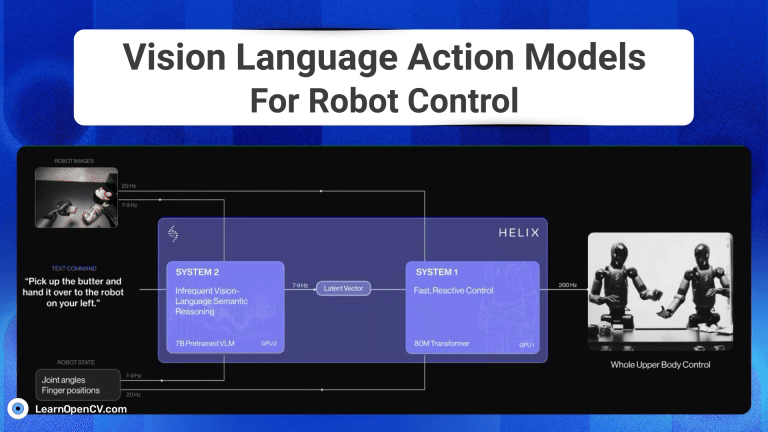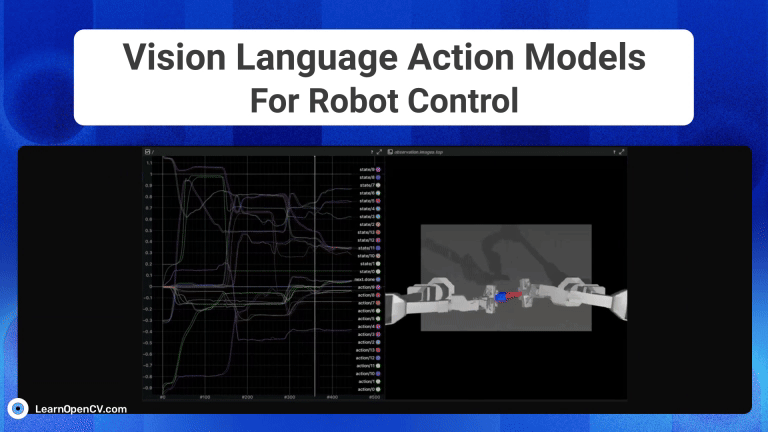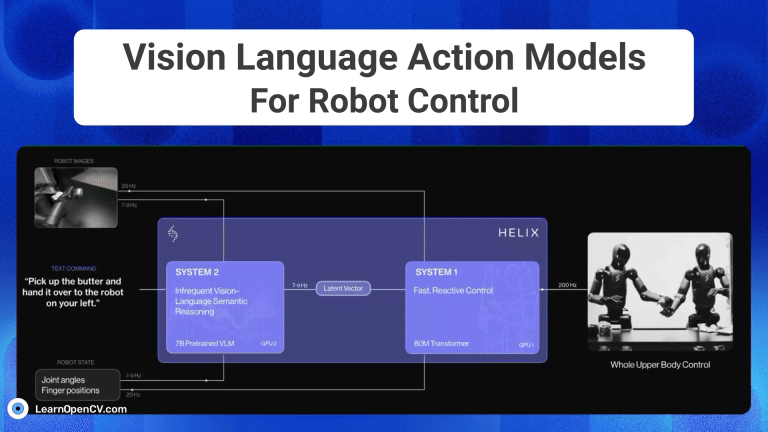
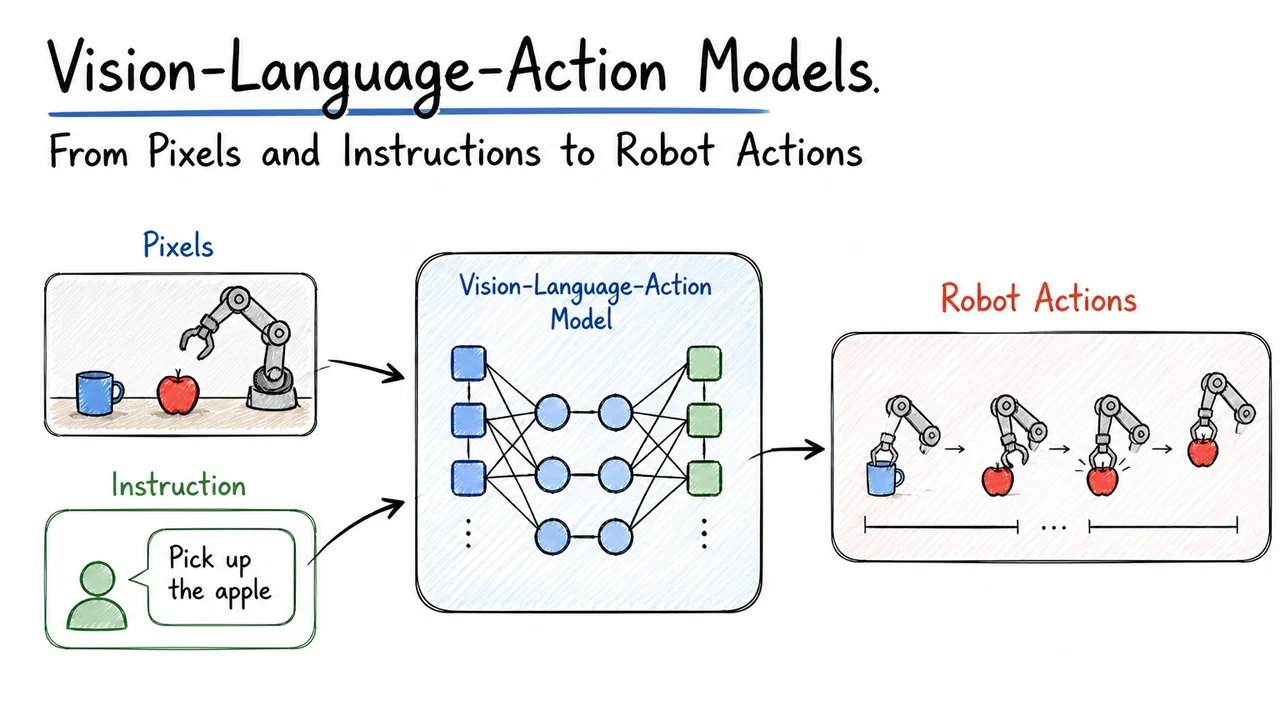
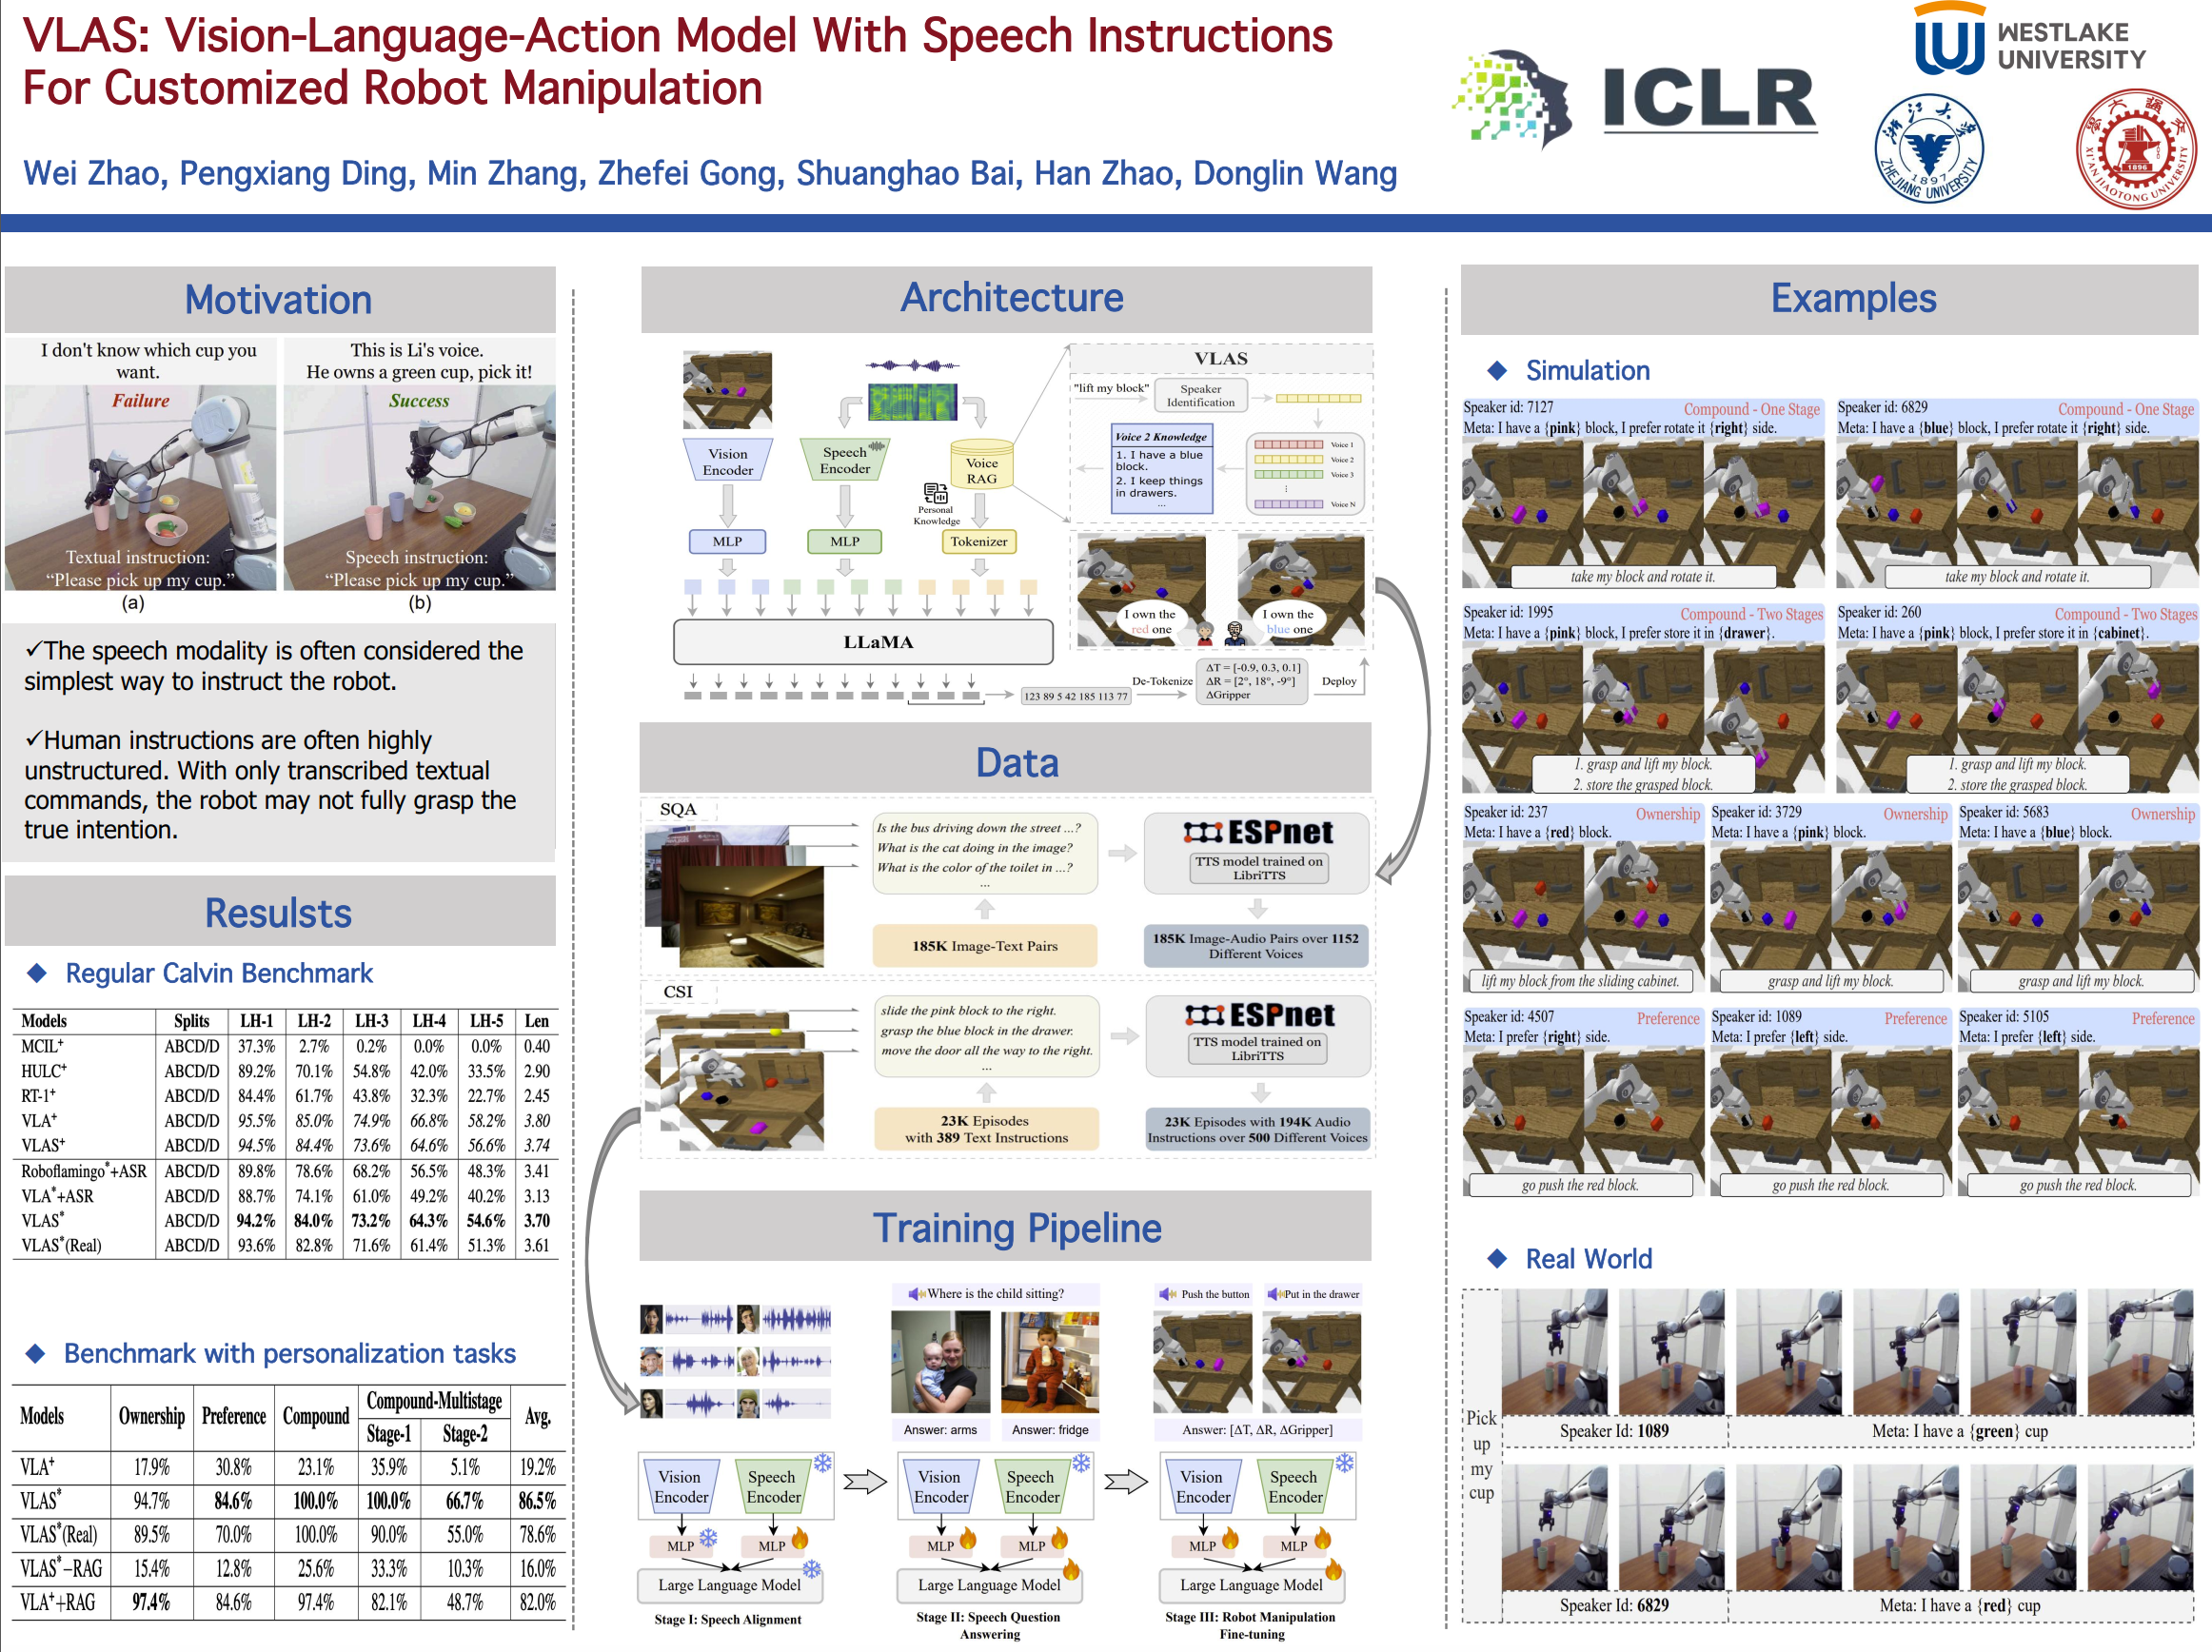
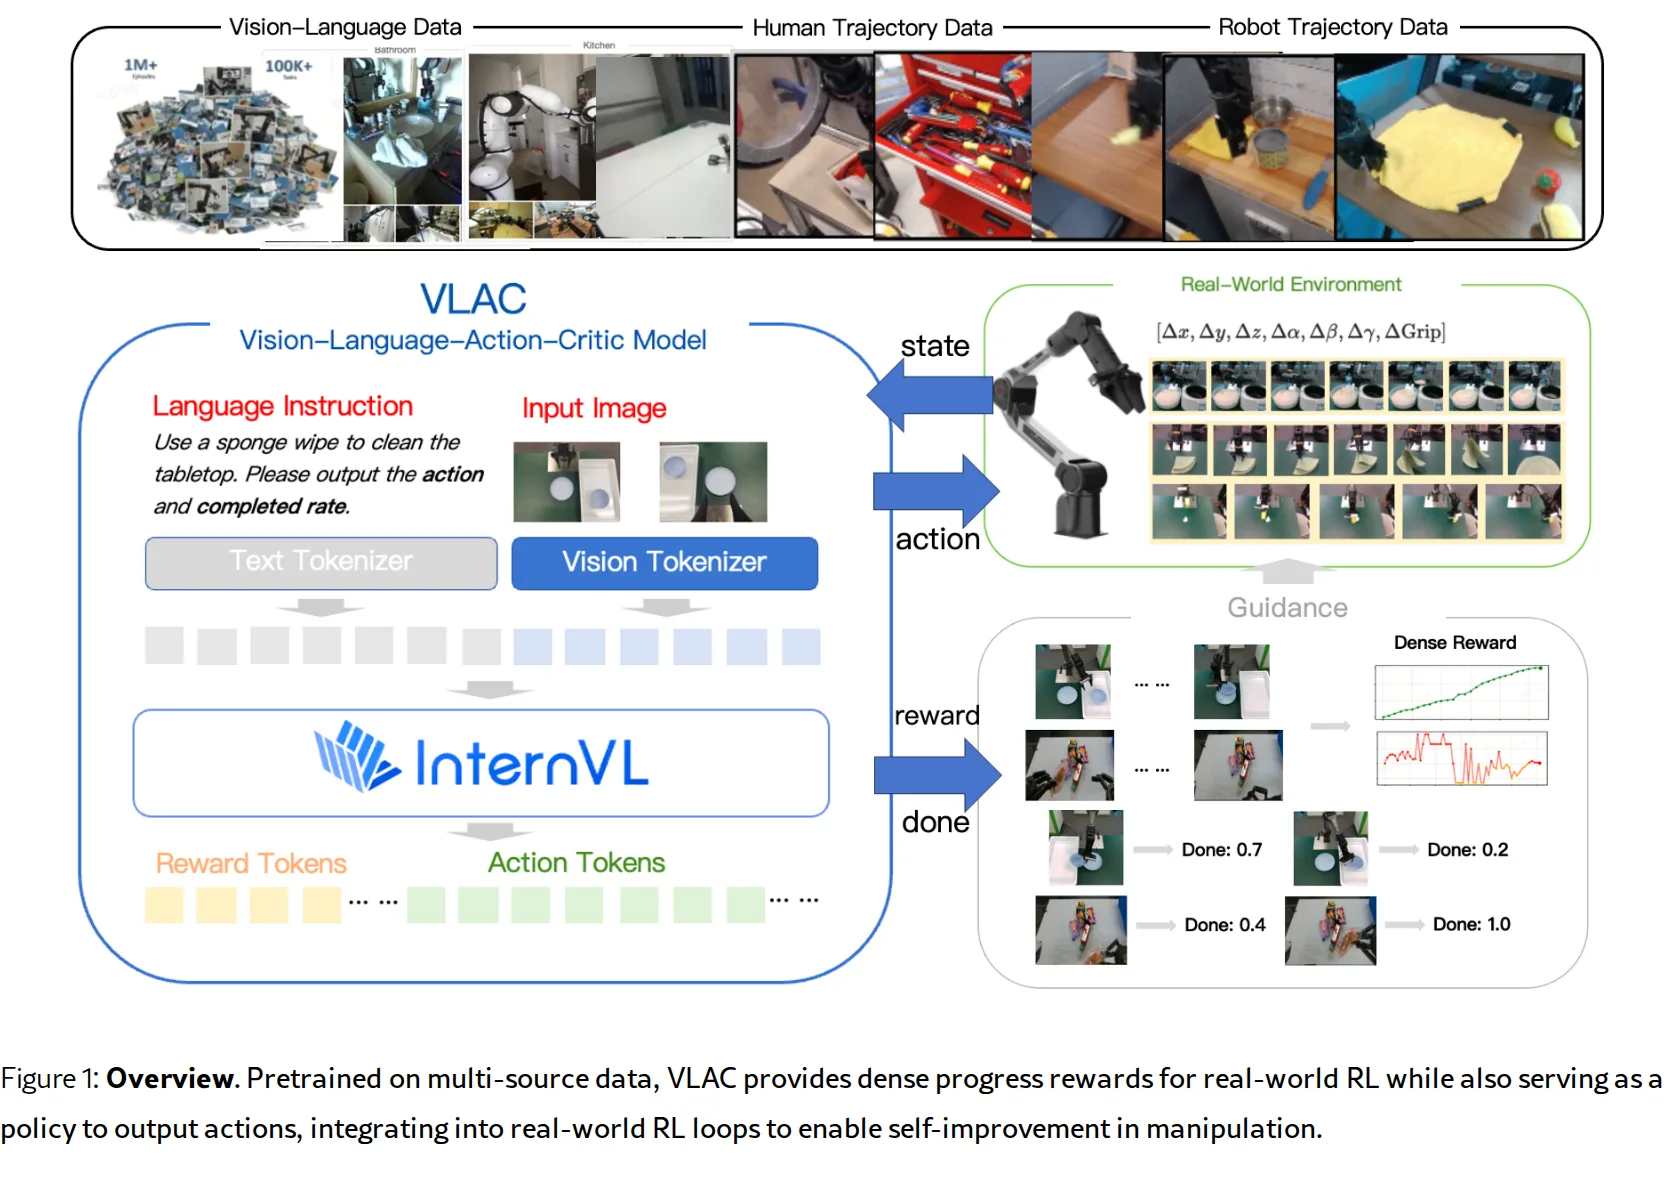
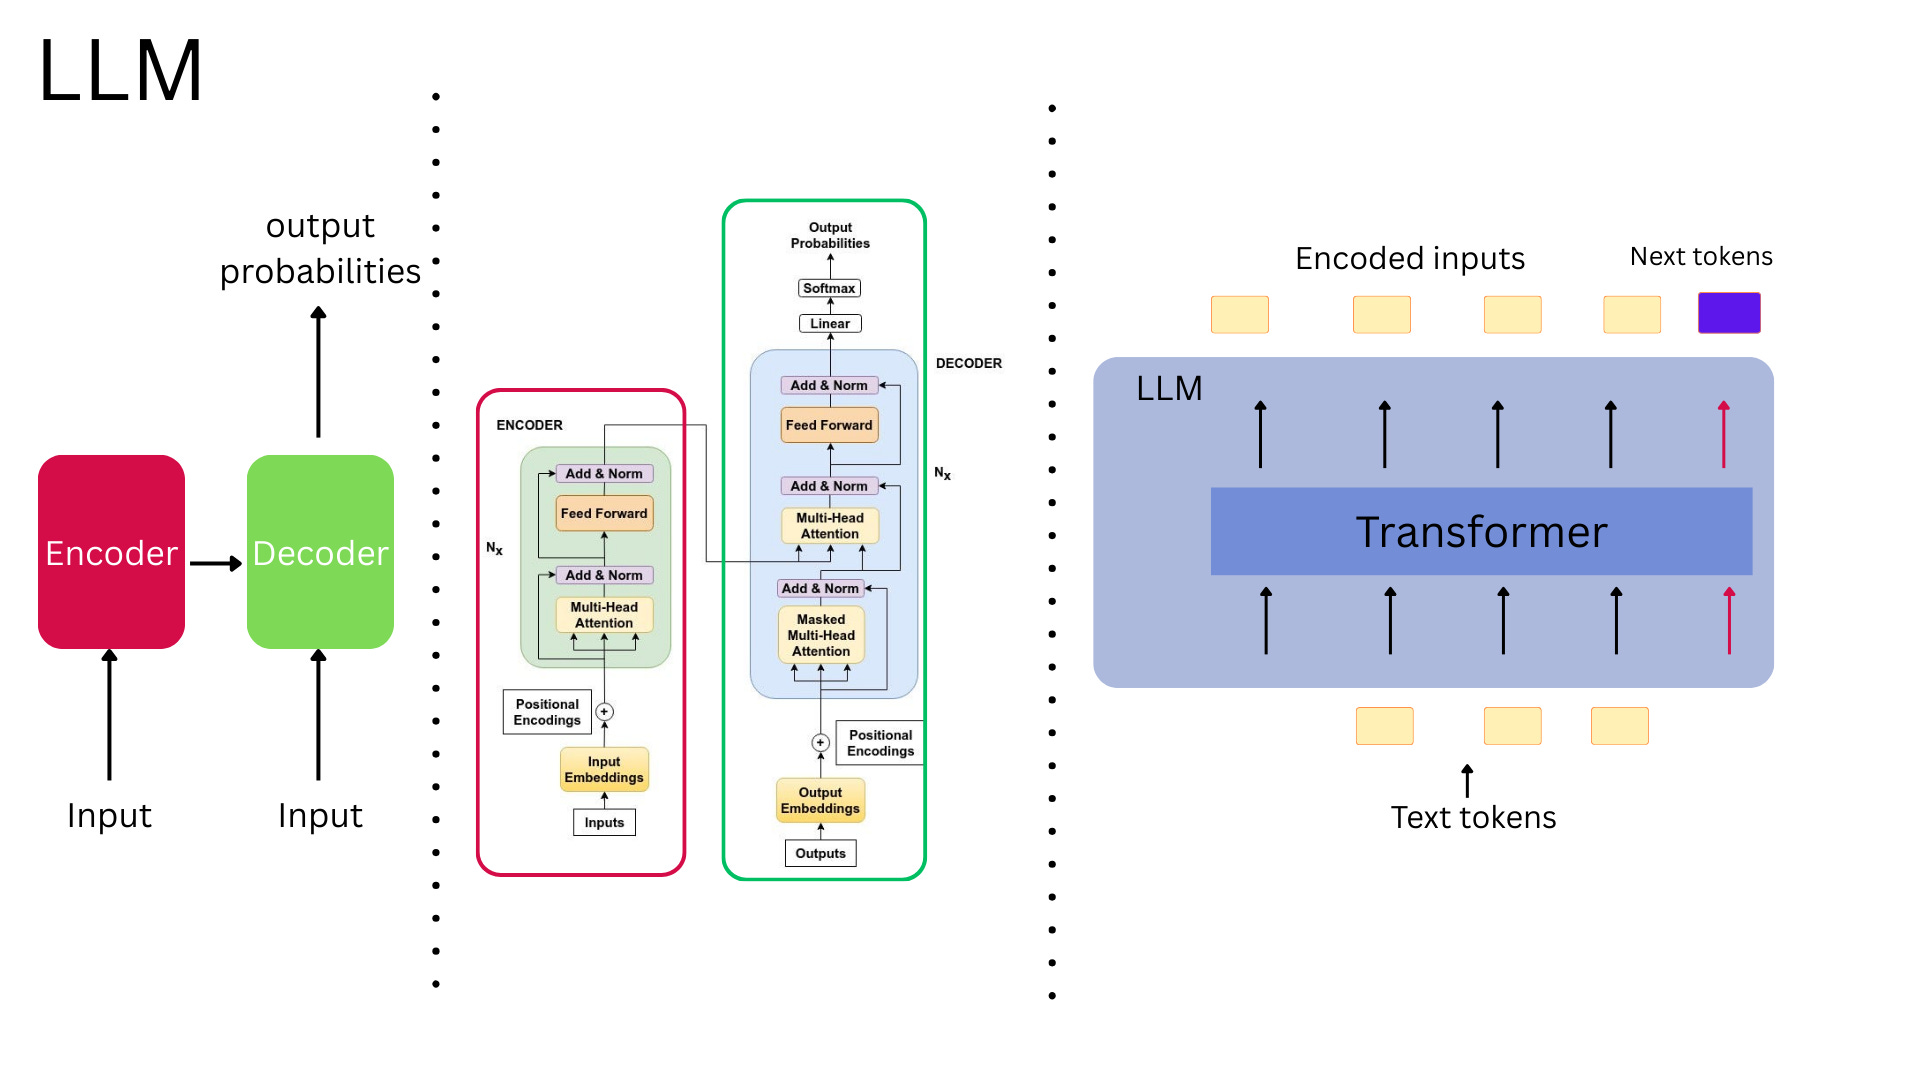
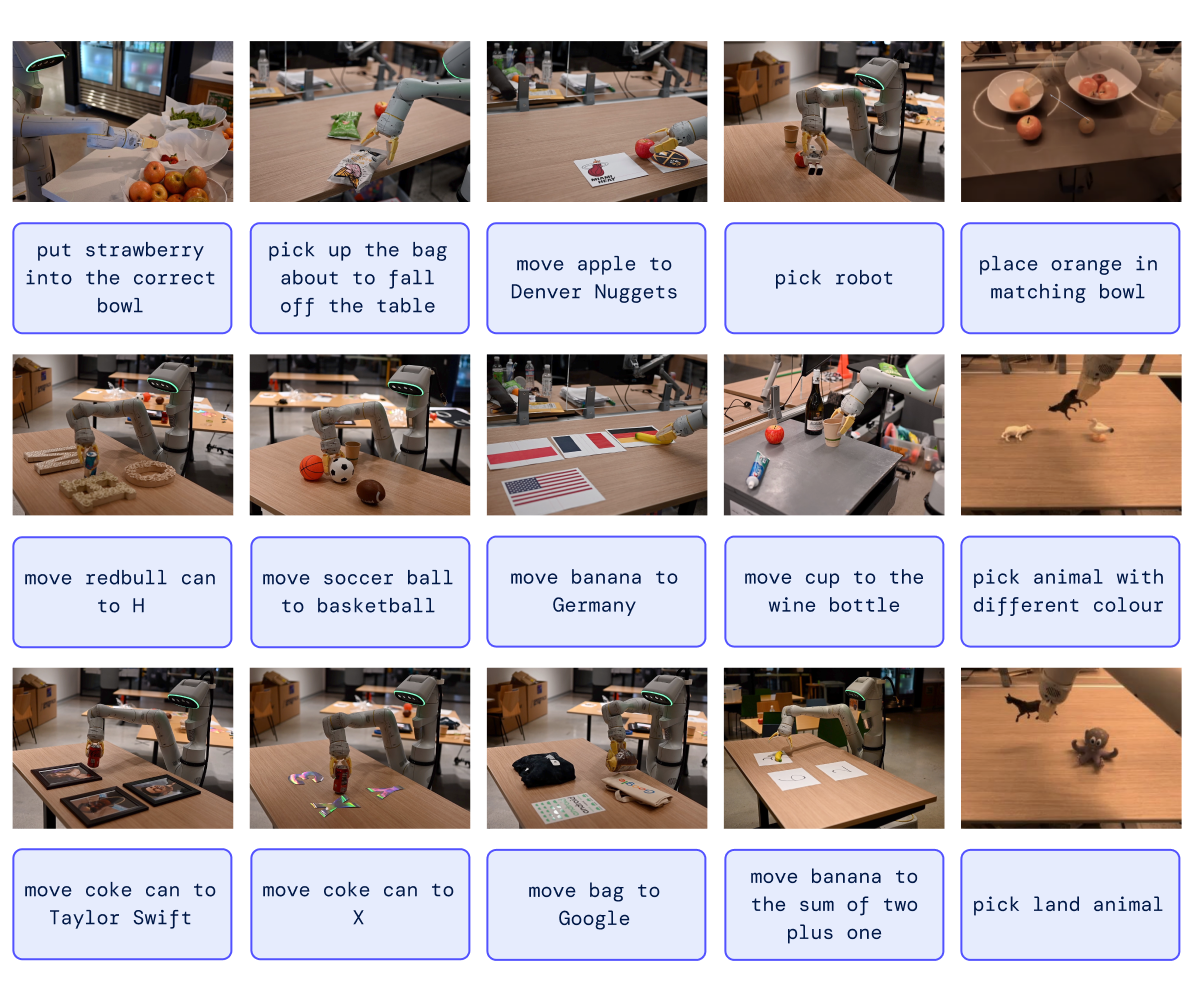
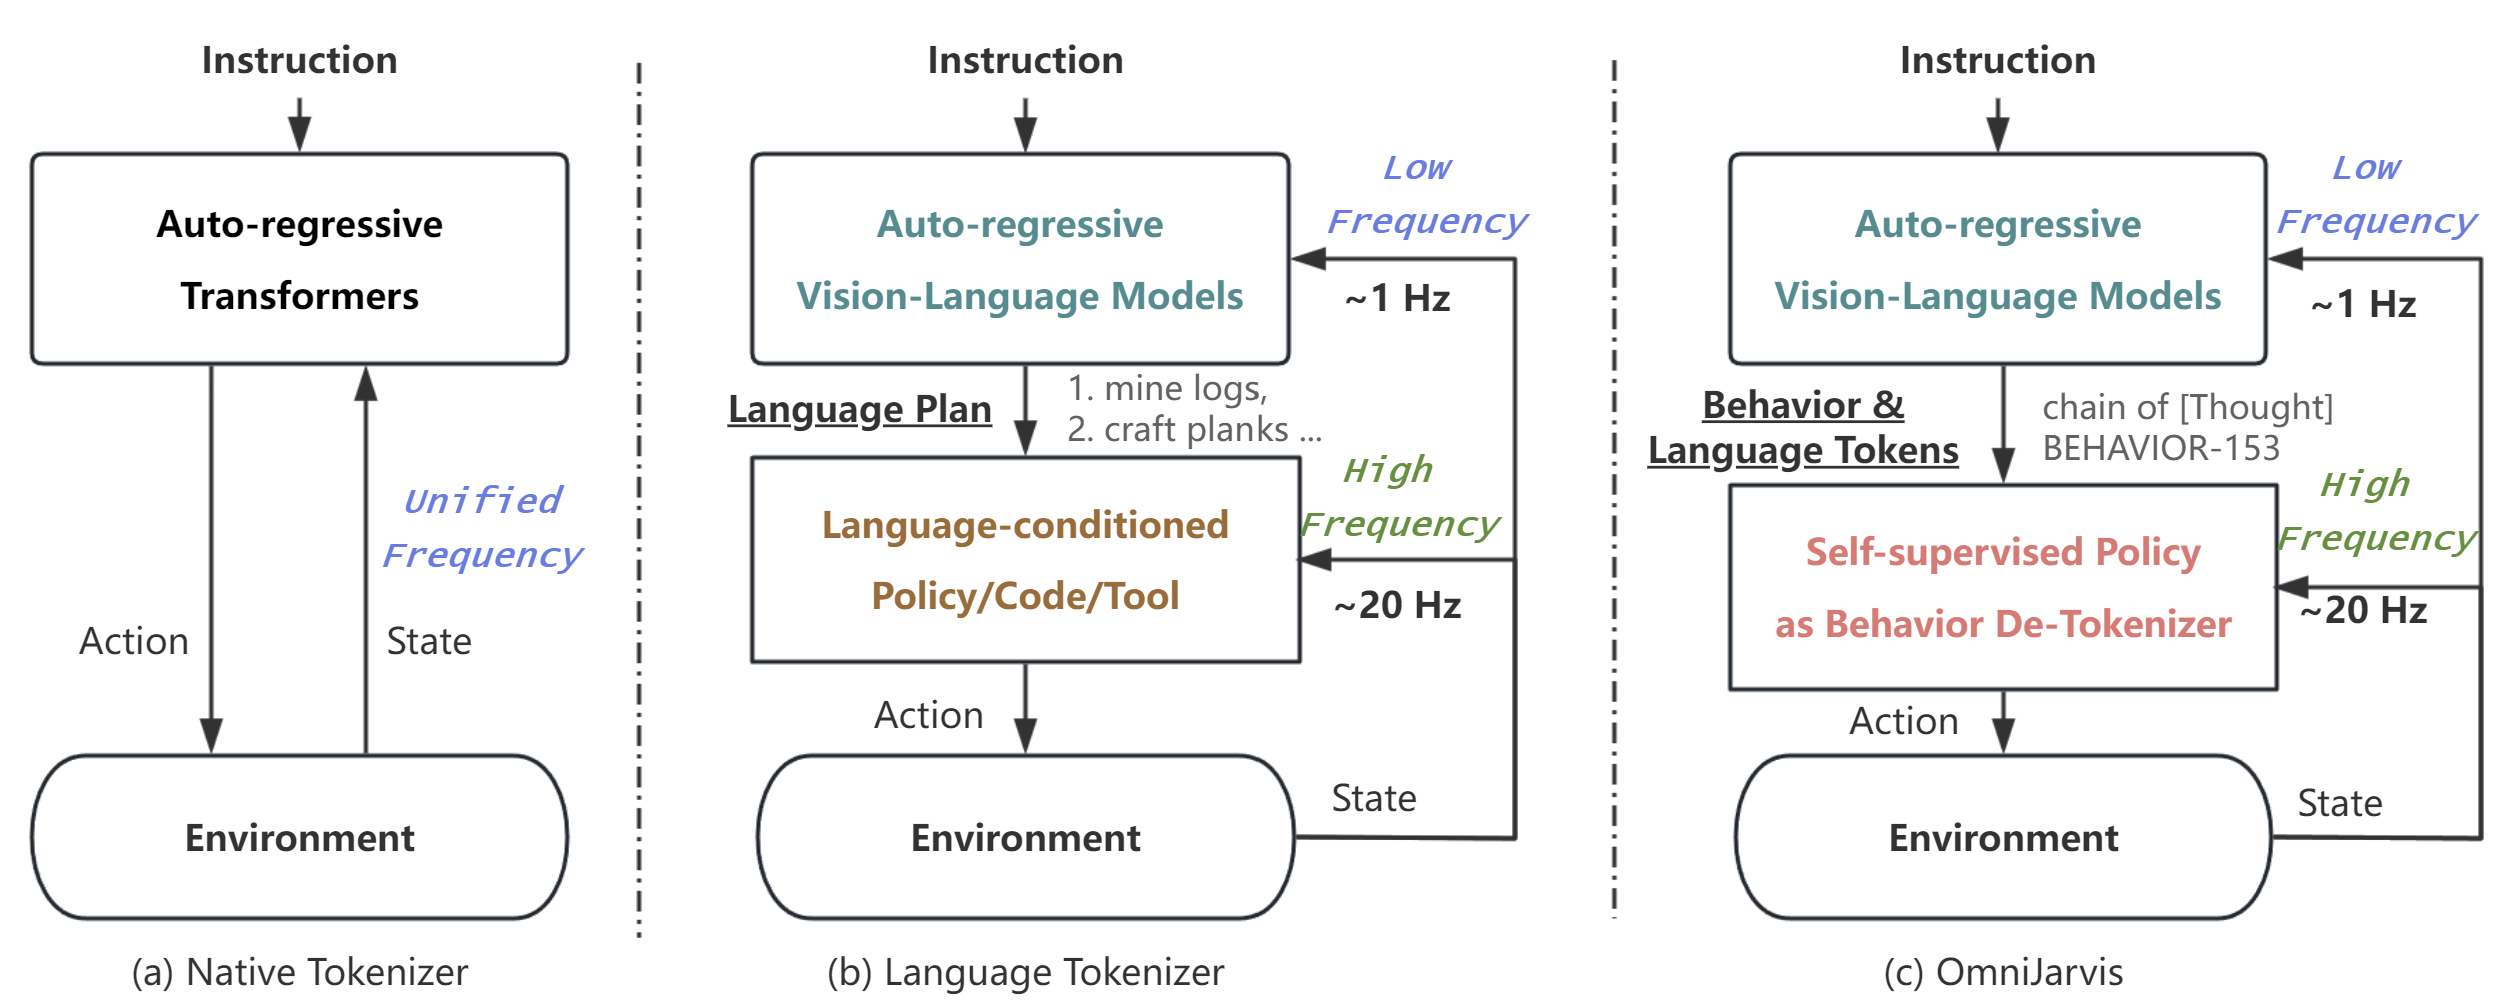
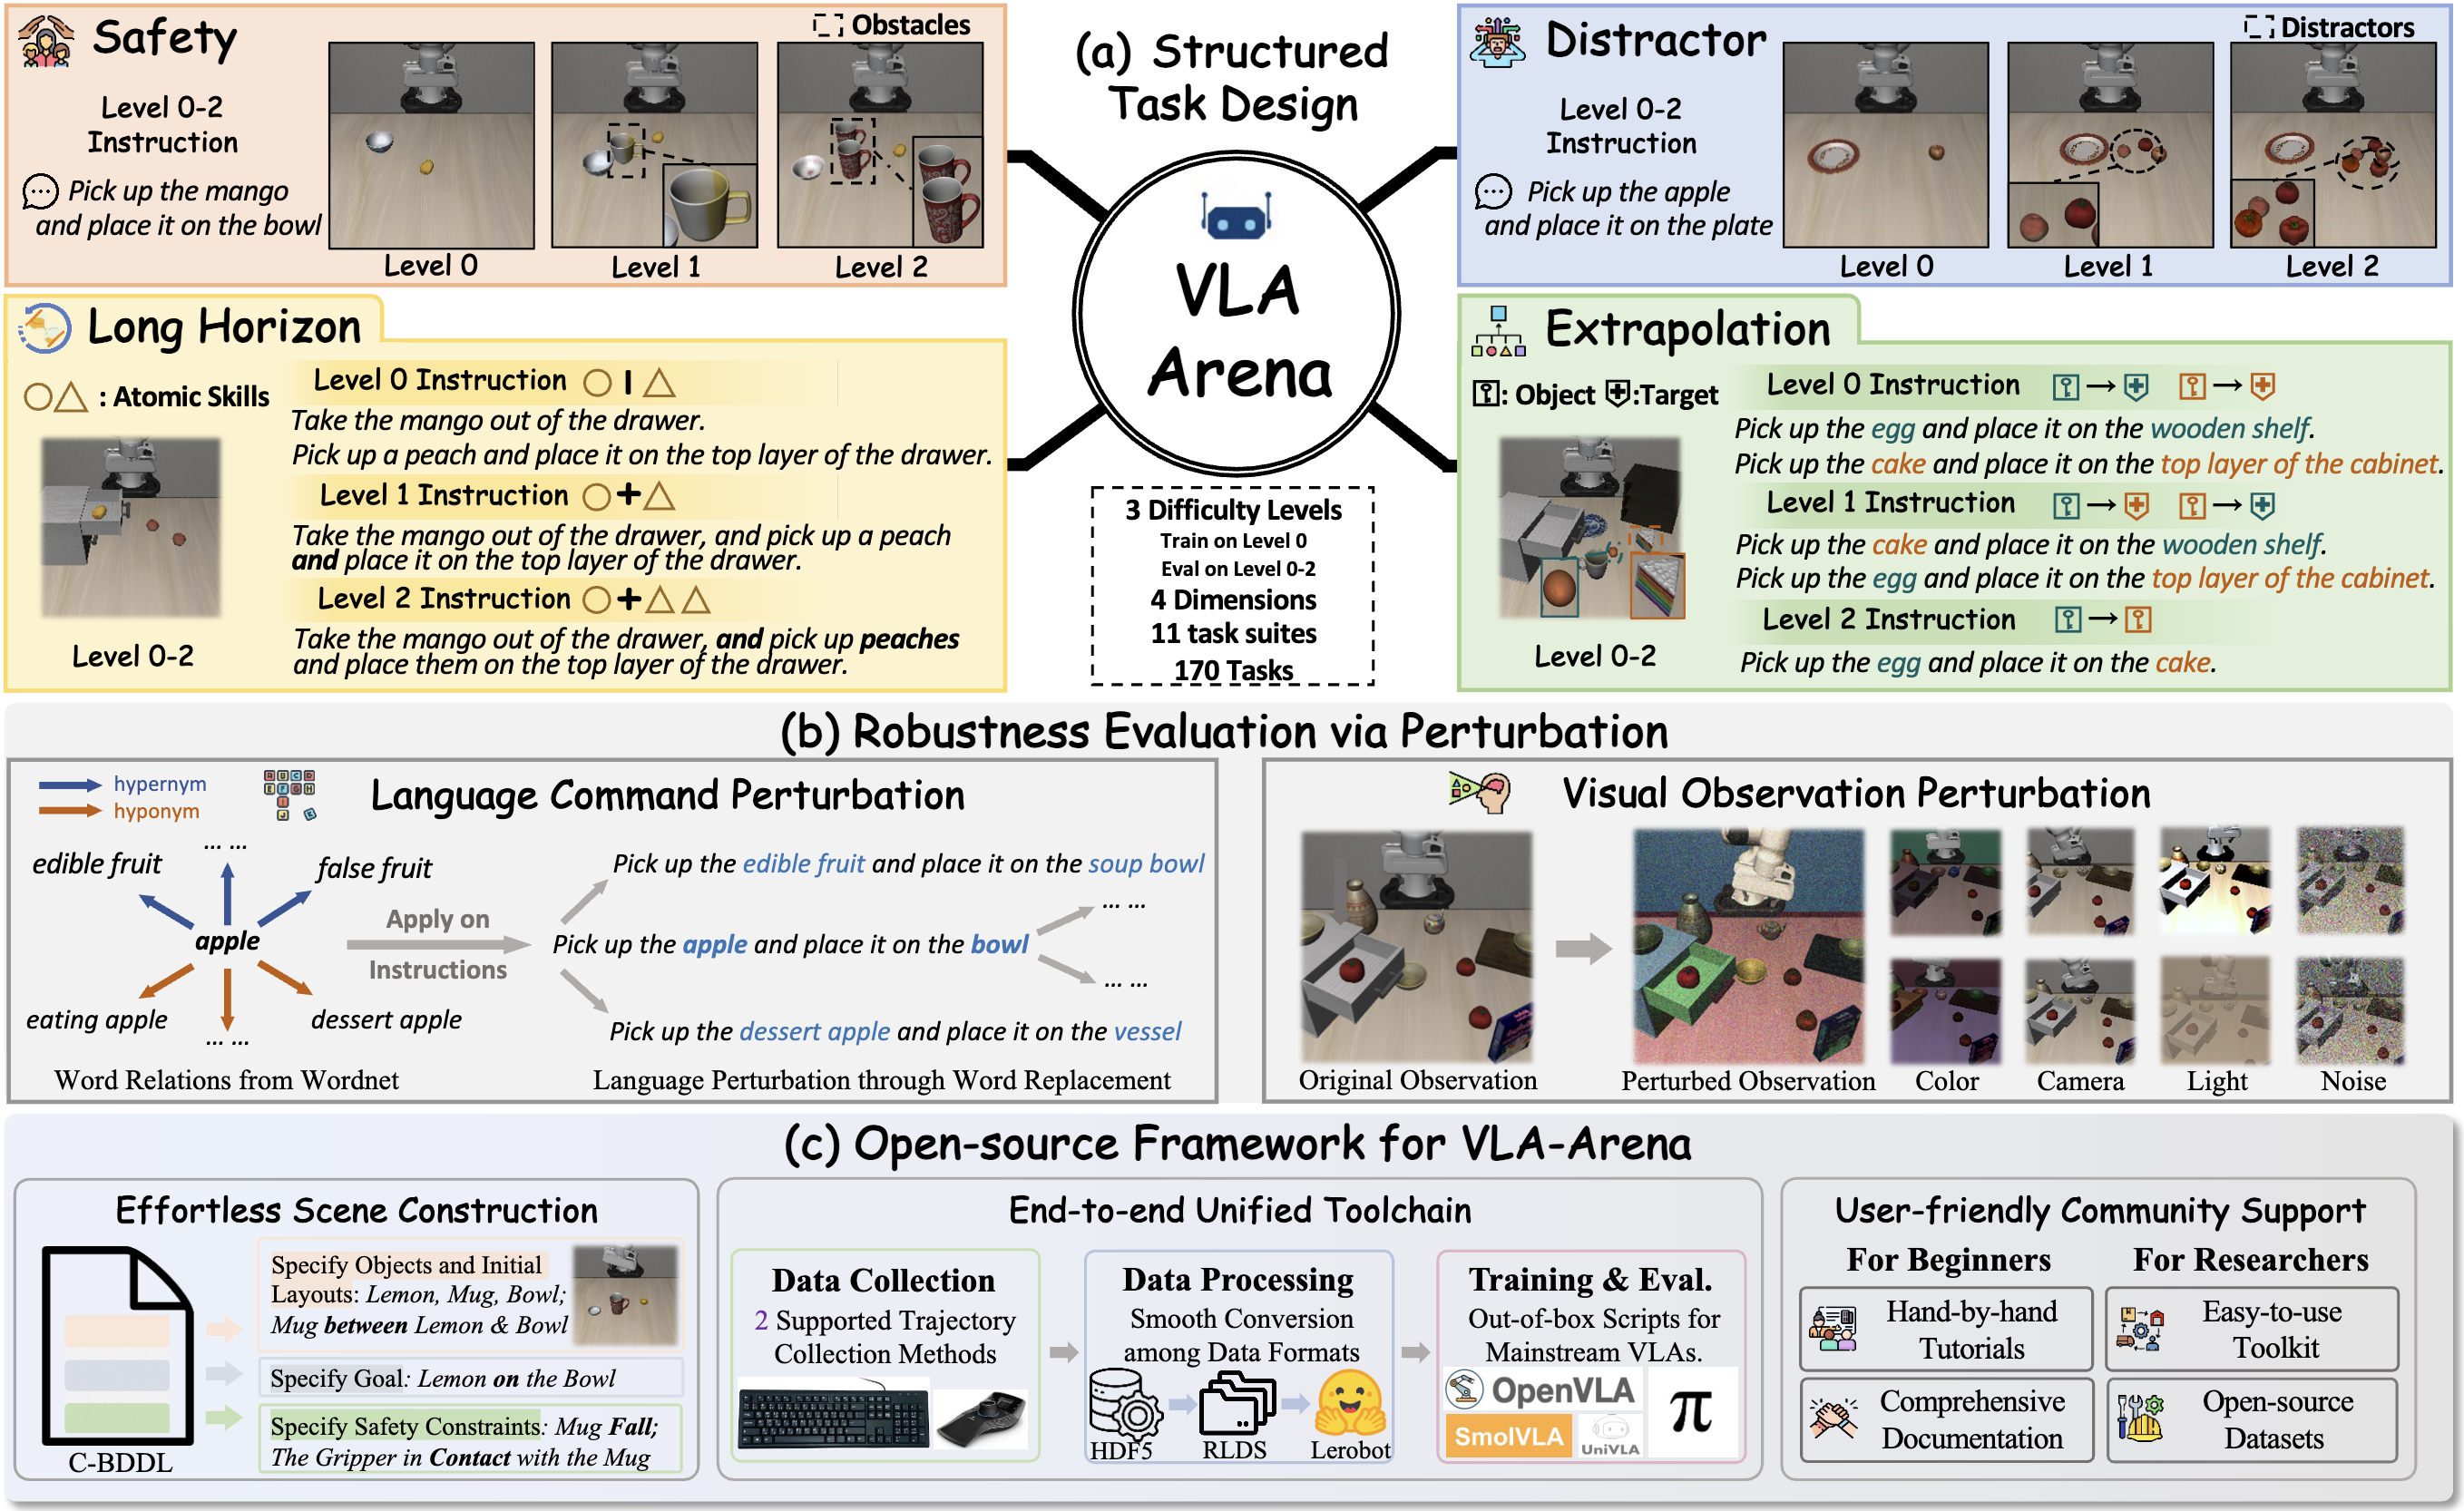
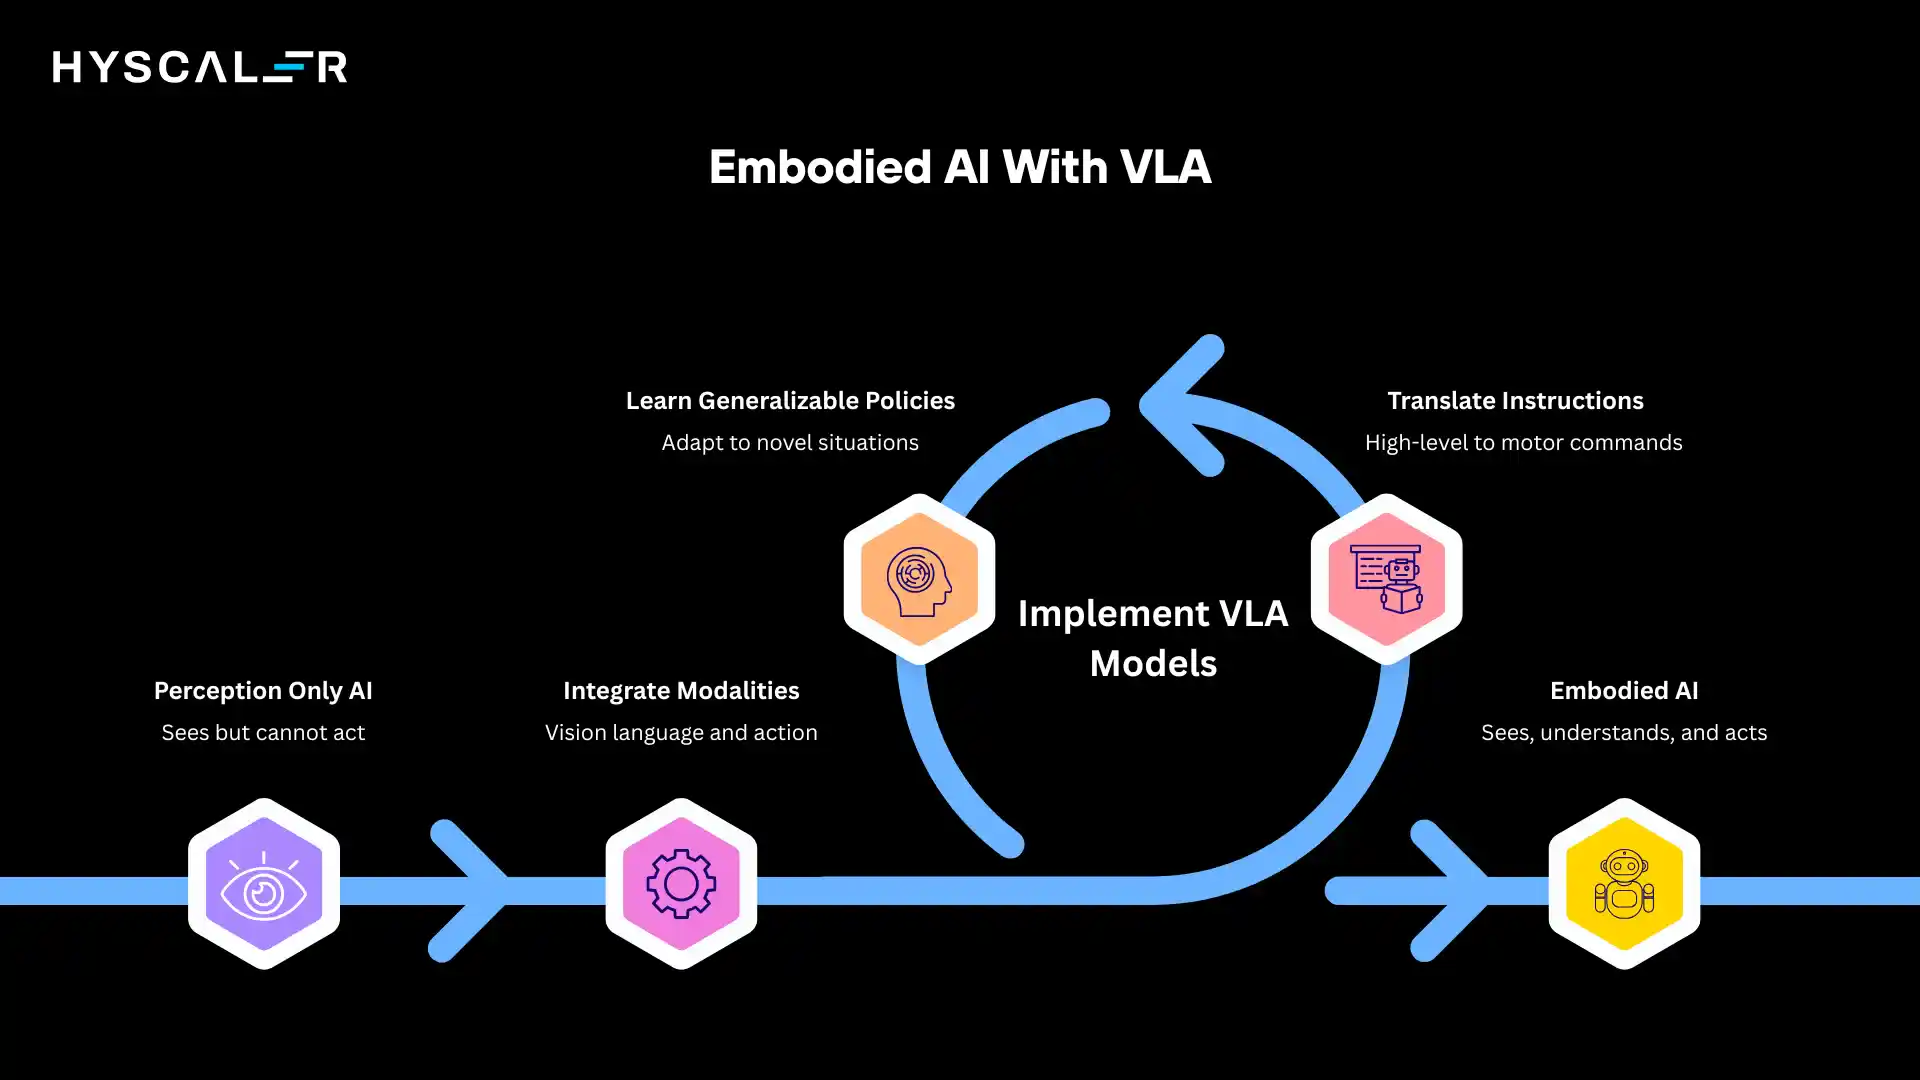
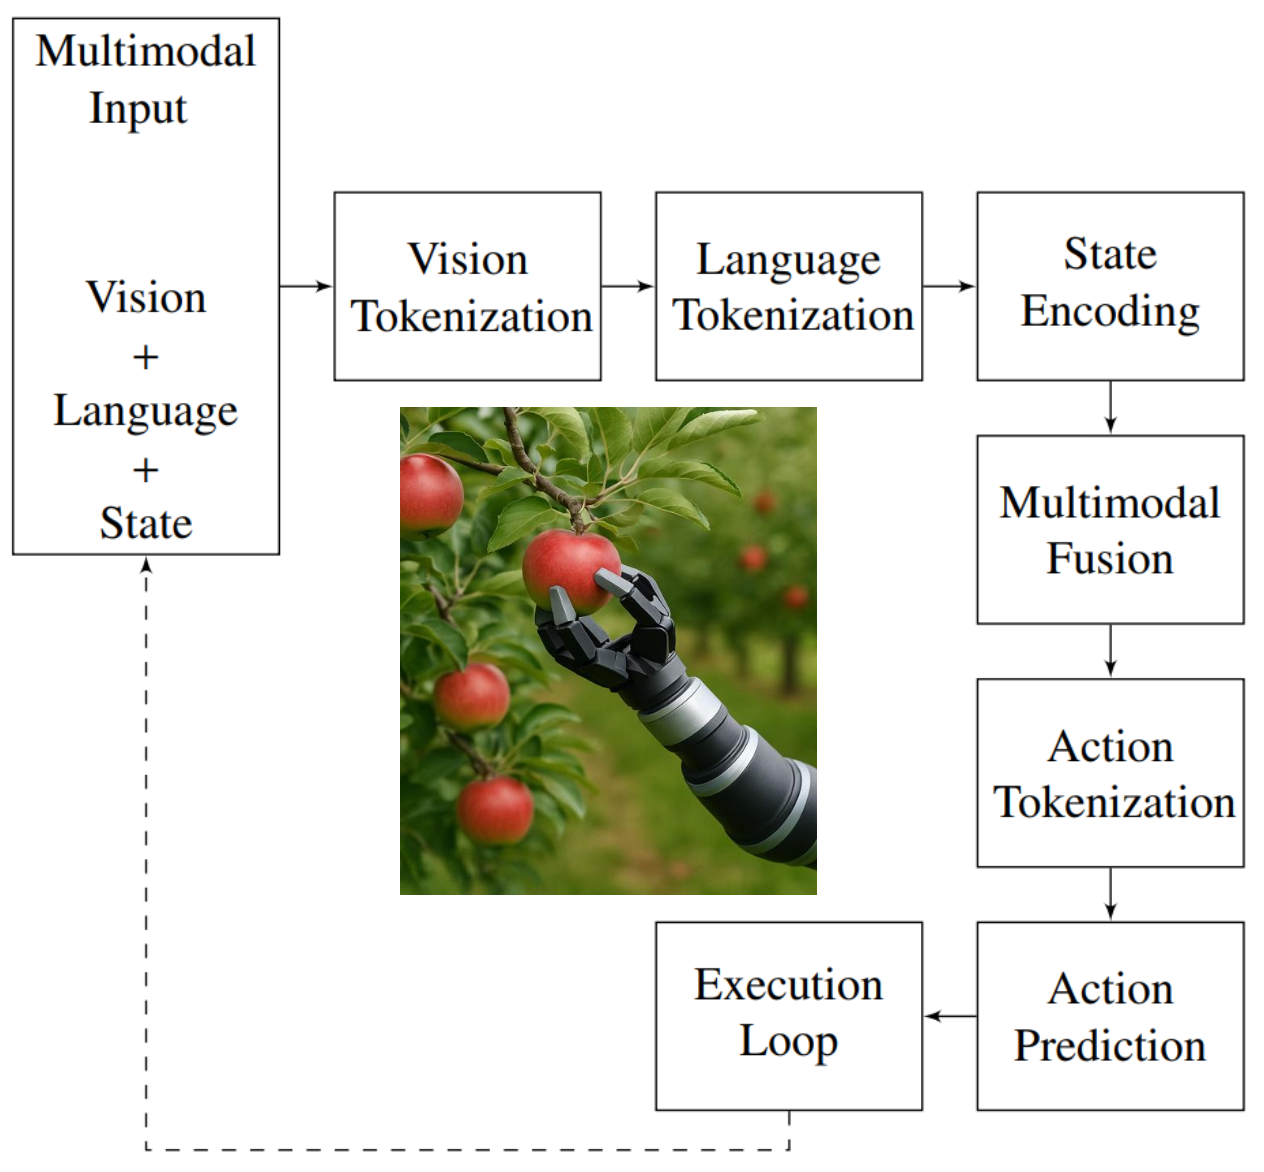
Vision Language Action Display
Document the past through hundreds of historically-significant Vision Language Action Display photographs. heritage-preserving showcasing play, doll, and game. ideal for museums and cultural institutions. Our Vision Language Action Display collection features high-quality images with excellent detail and clarity. Suitable for various applications including web design, social media, personal projects, and digital content creation All Vision Language Action Display images are available in high resolution with professional-grade quality, optimized for both digital and print applications, and include comprehensive metadata for easy organization and usage. Our Vision Language Action Display gallery offers diverse visual resources to bring your ideas to life. Our Vision Language Action Display database continuously expands with fresh, relevant content from skilled photographers. Diverse style options within the Vision Language Action Display collection suit various aesthetic preferences. Whether for commercial projects or personal use, our Vision Language Action Display collection delivers consistent excellence. The Vision Language Action Display collection represents years of careful curation and professional standards. Comprehensive tagging systems facilitate quick discovery of relevant Vision Language Action Display content. Instant download capabilities enable immediate access to chosen Vision Language Action Display images. Regular updates keep the Vision Language Action Display collection current with contemporary trends and styles. Professional licensing options accommodate both commercial and educational usage requirements.
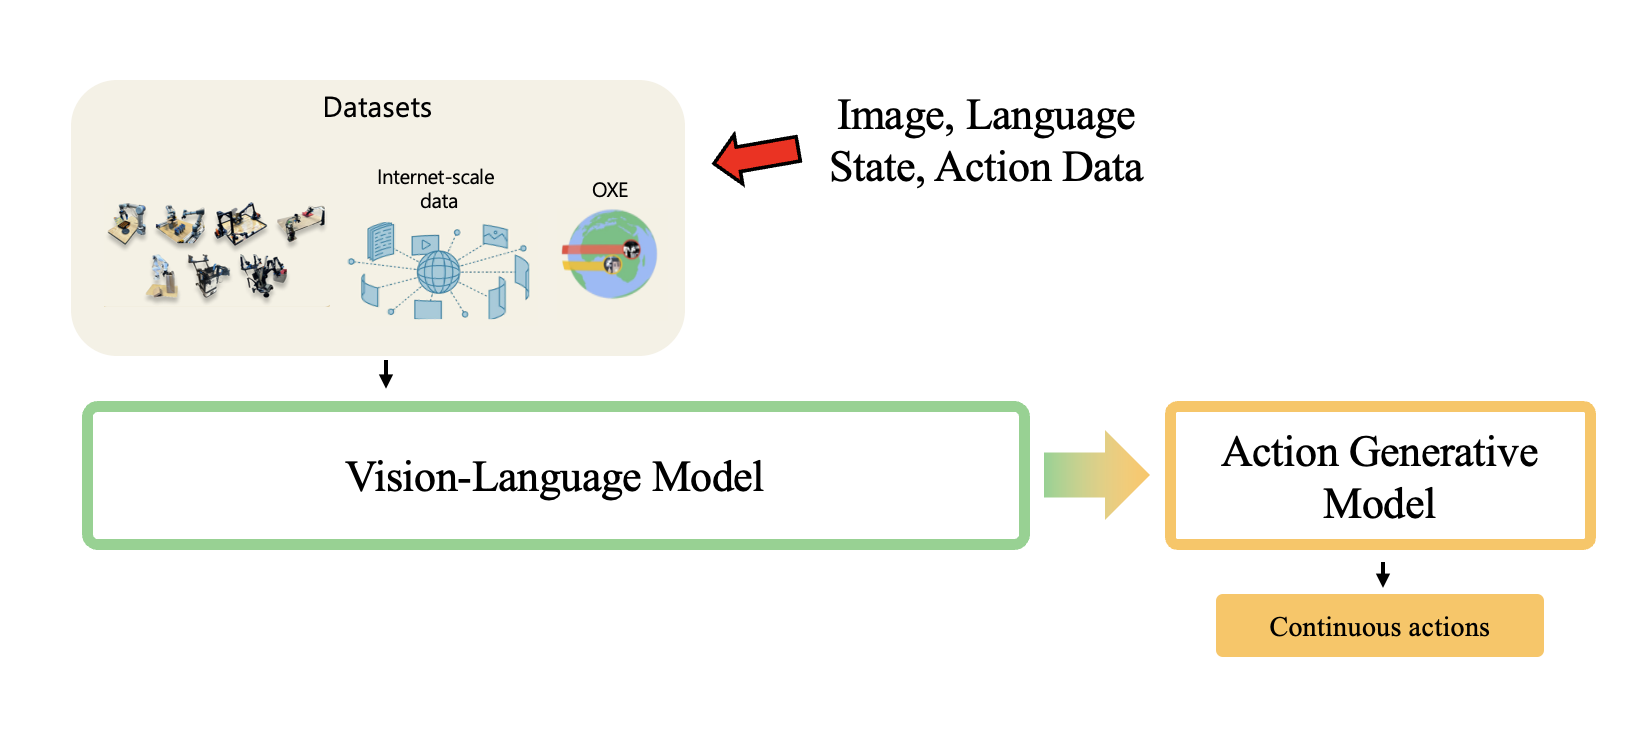


![Vision Language Action Display [论文评述] When Alignment Fails: Multimodal Adversarial Attacks on Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/when-alignment-fails-multimodal-adversarial-attacks-on-vision-language-action-models-3.png)

![Vision Language Action Display [논문 리뷰] Model-agnostic Adversarial Attack and Defense for Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/model-agnostic-adversarial-attack-and-defense-for-vision-language-action-models-2.png)
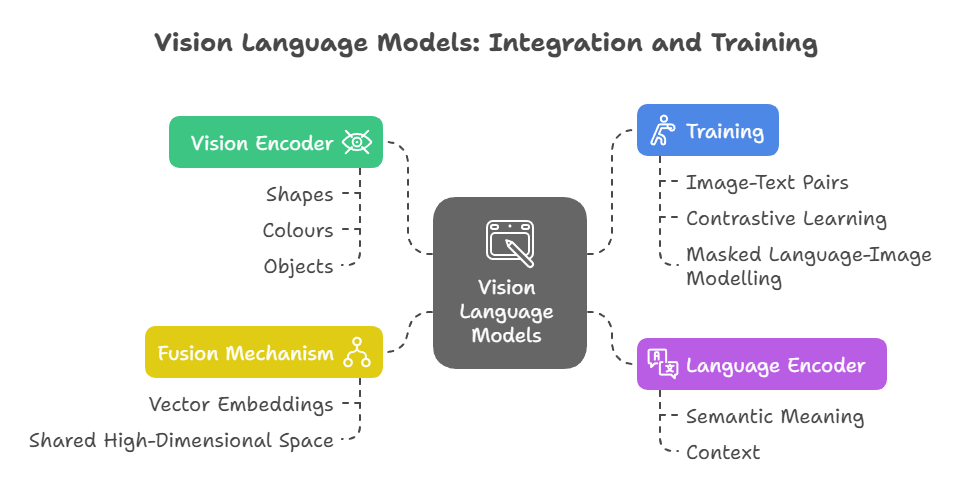


![Vision Language Action Display [论文评述] Uni-NaVid: A Video-based Vision-Language-Action Model for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/uni-navid-a-video-based-vision-language-action-model-for-unifying-embodied-navigation-tasks-0.png)
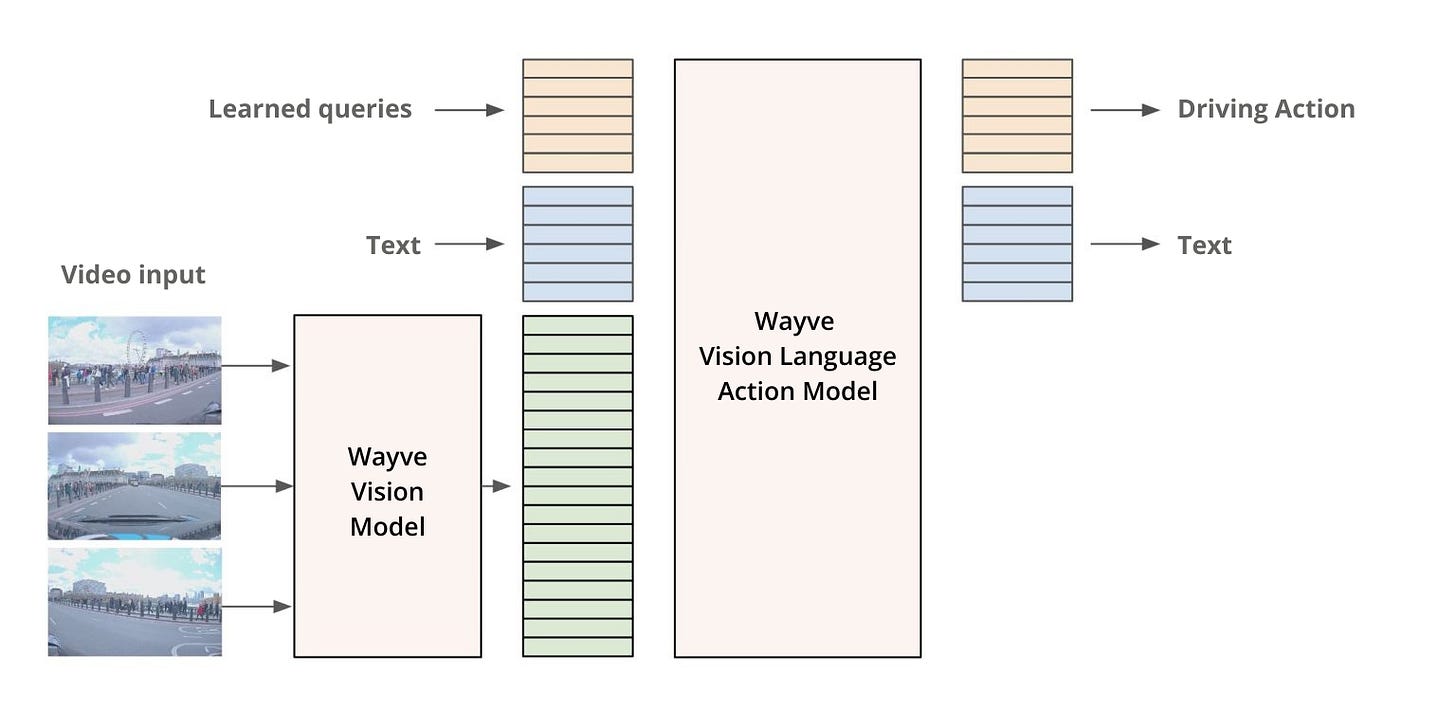


![Vision Language Action Display [논문 리뷰] GeneralVLA: Generalizable Vision-Language-Action Models with ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/generalvla-generalizable-vision-language-action-models-with-knowledge-guided-trajectory-planning-0.png)


![Vision Language Action Display [July 2024] AI & Machine Learning Monthly Newsletter 💻🤖 | Zero To Mastery](https://images.ctfassets.net/aq13lwl6616q/7aCnZVvfQEbaD8tkpNBIRA/06fe00bb1dfaef60573c4be63593d7bb/vlms-explained.jpg)
![Vision Language Action Display [논문 리뷰] Improving Vision-Language-Action Models via Chain-of-Affordance](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/improving-vision-language-action-models-via-chain-of-affordance-0.png)
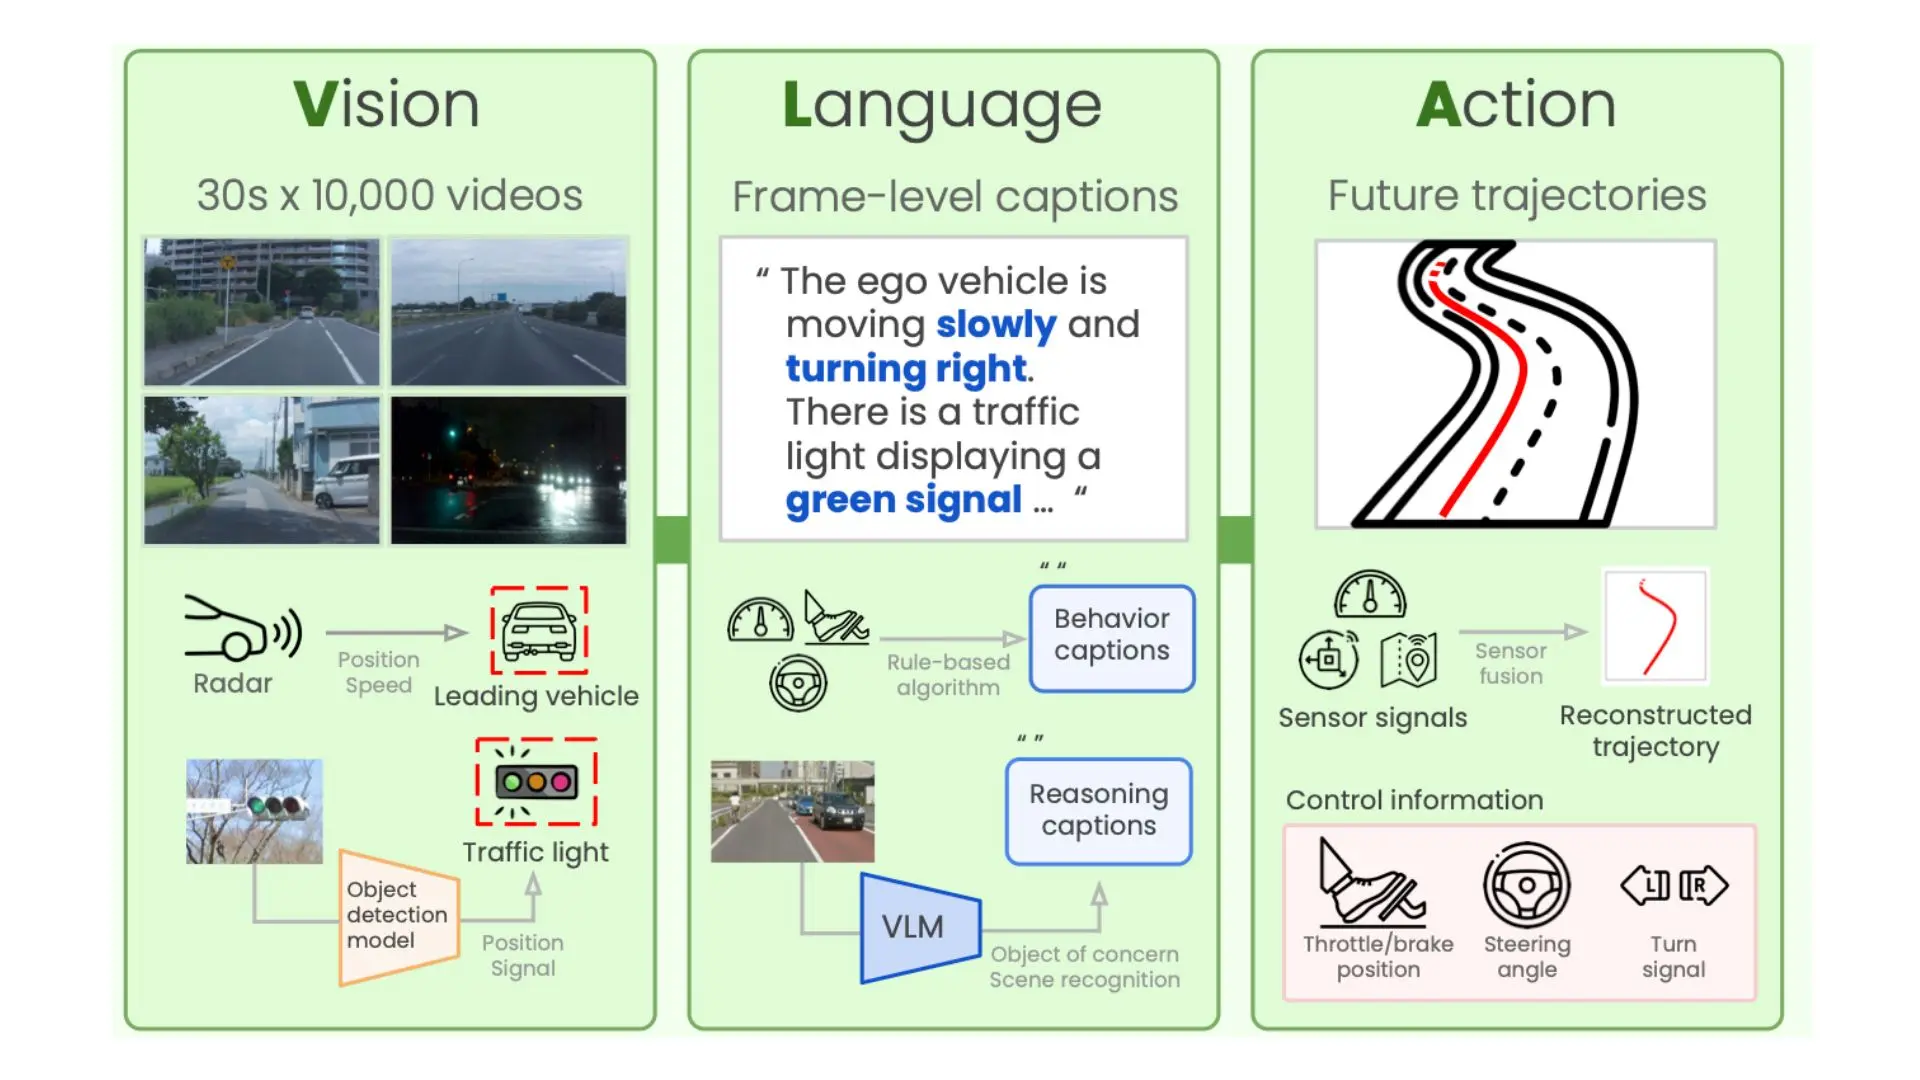


![Vision Language Action Display [논문 리뷰] Sigma: The Key for Vision-Language-Action Models toward ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/sigma-the-key-for-vision-language-action-models-toward-telepathic-alignment-1.png)

![Vision Language Action Display [리뷰] Vision-Language-Action Models: Concepts, Progress, Applications ...](https://blog.eunsour.dev/assets/img/vla_models/15.png)


![Vision Language Action Display [Literature Review] $π_{0.5}$: a Vision-Language-Action Model with Open ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/05-a-vision-language-action-model-with-open-world-generalization-0.png)


![Vision Language Action Display [论文评述] XR-1: Towards Versatile Vision-Language-Action Models via ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/xr-1-towards-versatile-vision-language-action-models-via-learning-unified-vision-motion-representations-0.png)
![Vision Language Action Display [논문 리뷰] Discrete Diffusion for Reflective Vision-Language-Action Models ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/discrete-diffusion-for-reflective-vision-language-action-models-in-autonomous-driving-3.png)


![Vision Language Action Display [논문 리뷰] SmolVLA: A Vision-Language-Action Model for Affordable and ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/smolvla-a-vision-language-action-model-for-affordable-and-efficient-robotics-0.png)


![Vision Language Action Display [论文评述] CLARE: Continual Learning for Vision-Language-Action Models via ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/clare-continual-learning-for-vision-language-action-models-via-autonomous-adapter-routing-and-expansion-0.png)
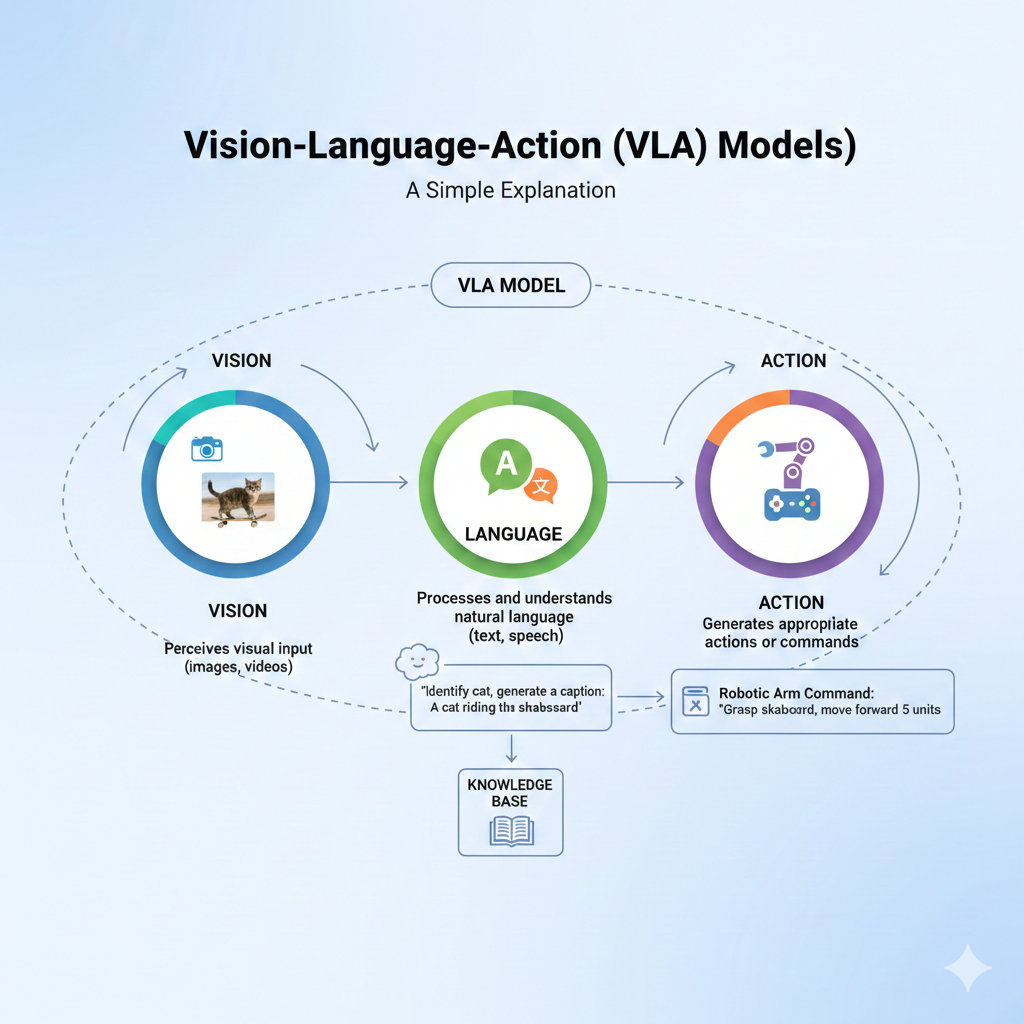


![Vision Language Action Display [论文评述] TriVLA: A Triple-System-Based Unified Vision-Language-Action ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/trivla-a-triple-system-based-unified-vision-language-action-model-for-general-robot-control-1.png)