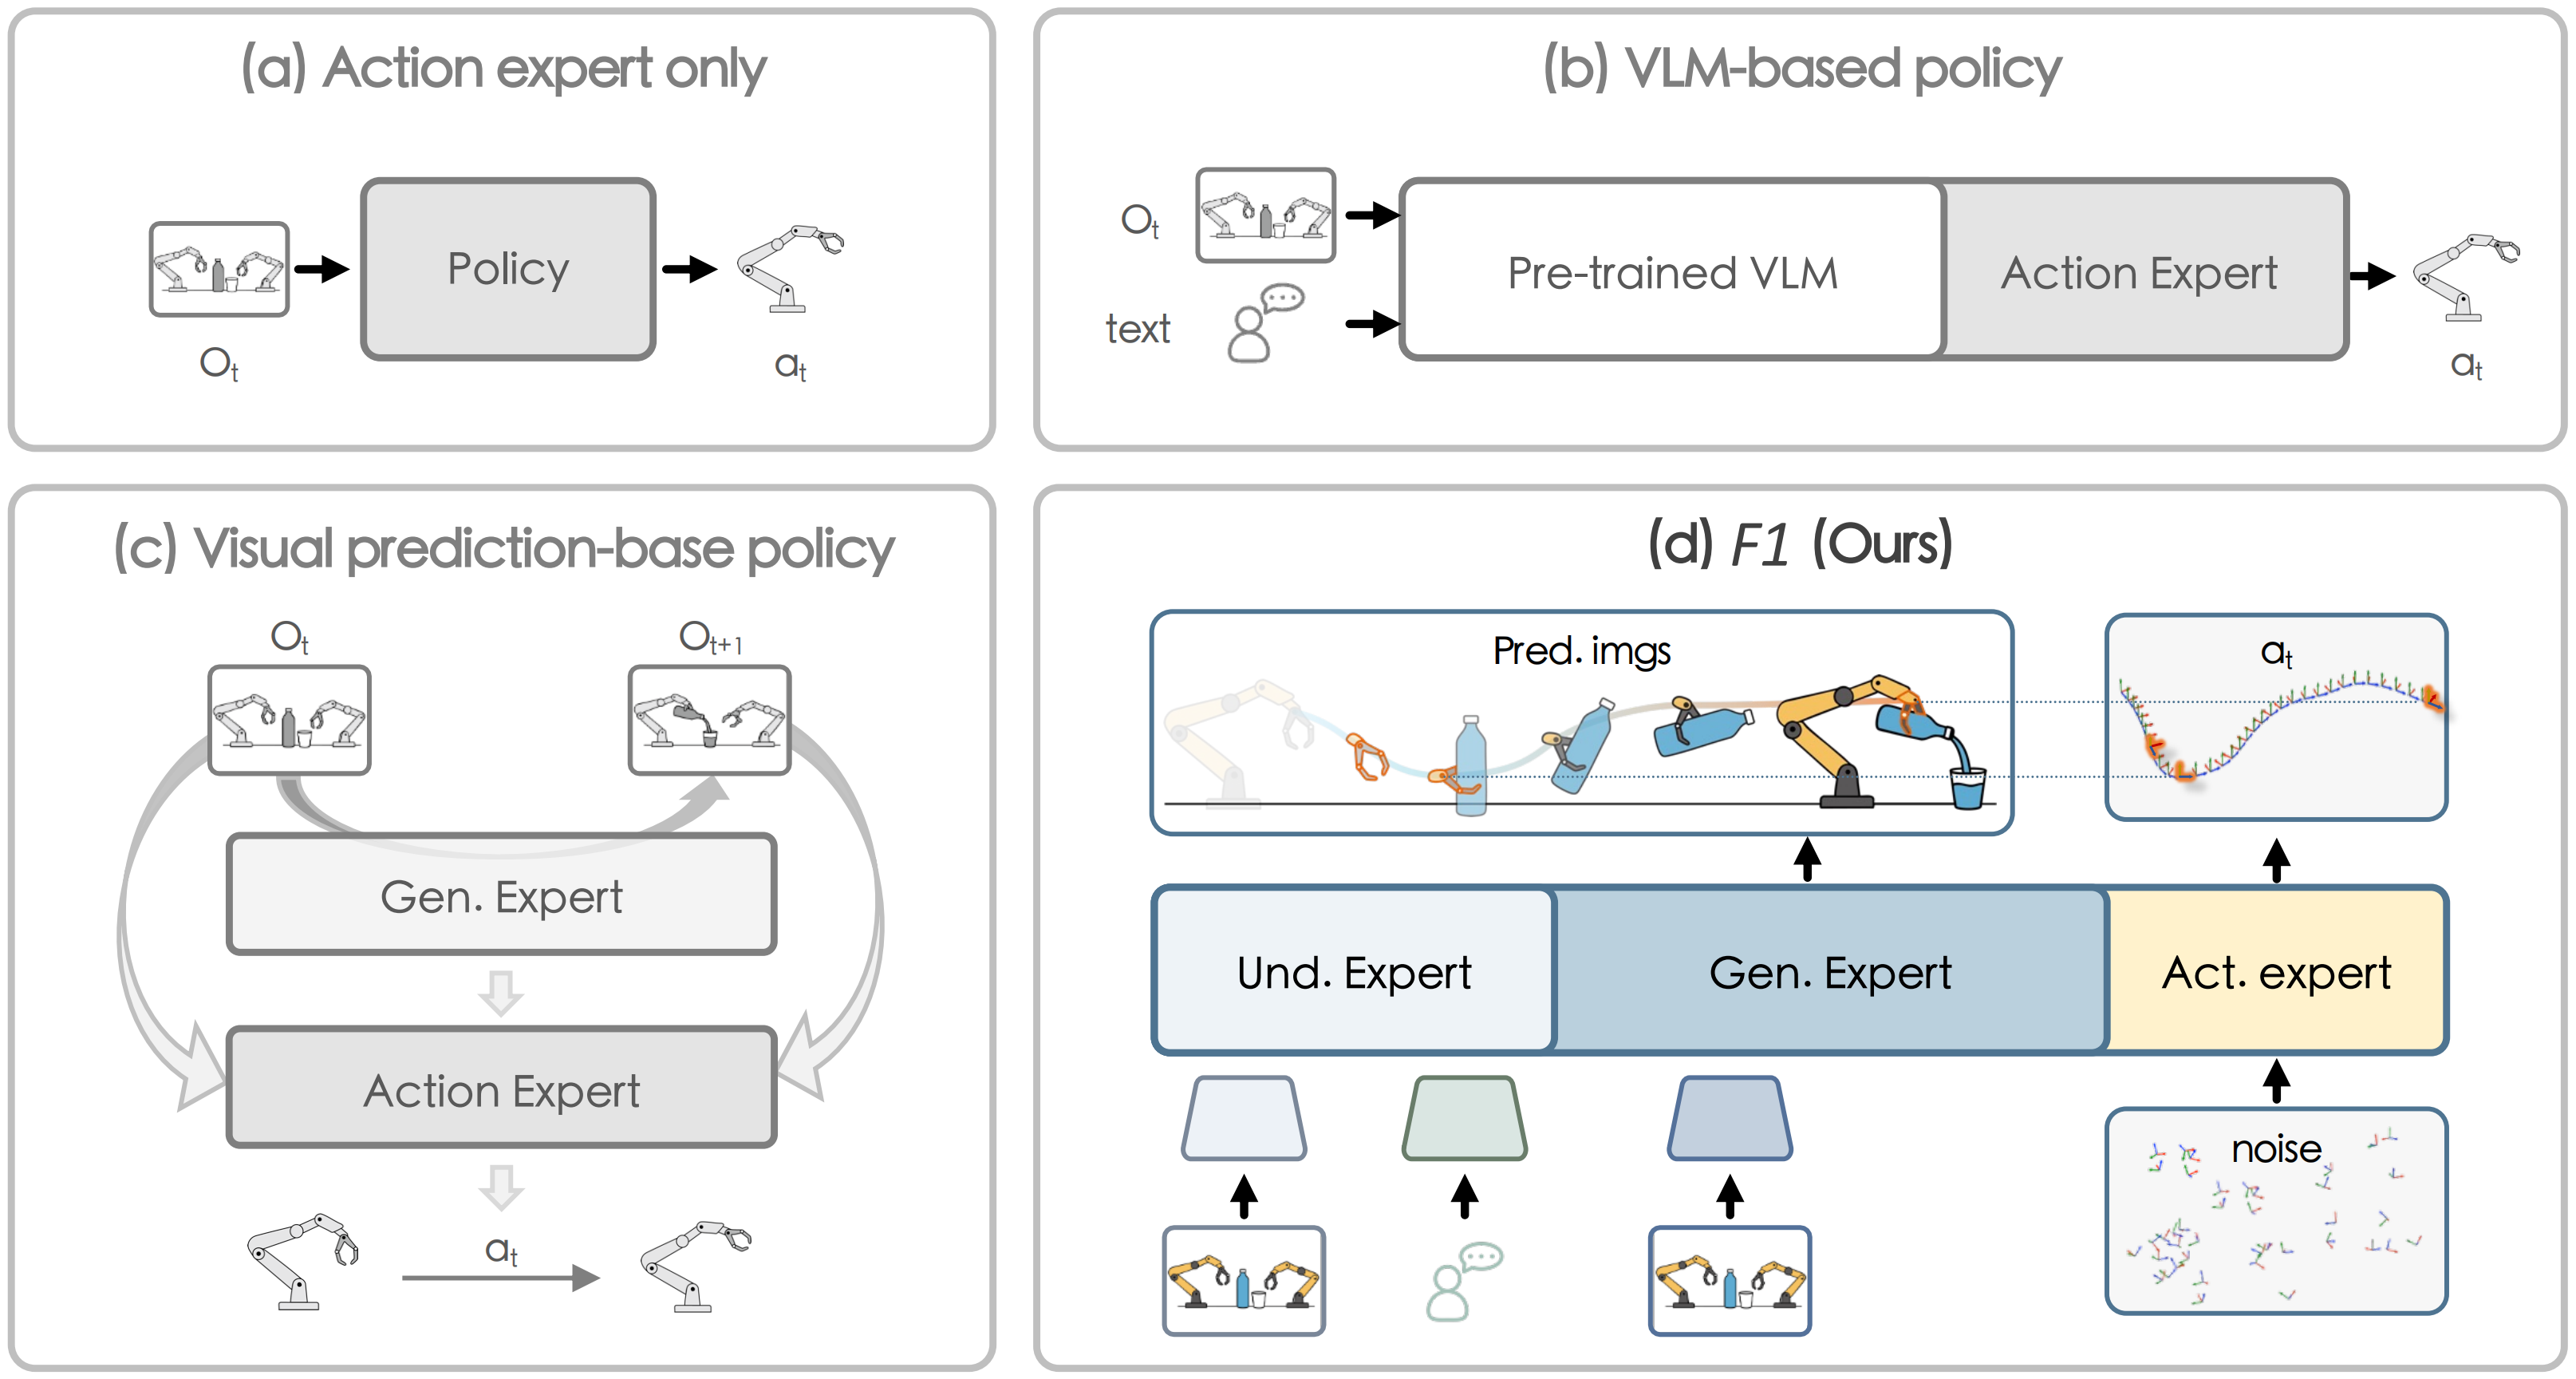
Vla Models Example Task Input/output
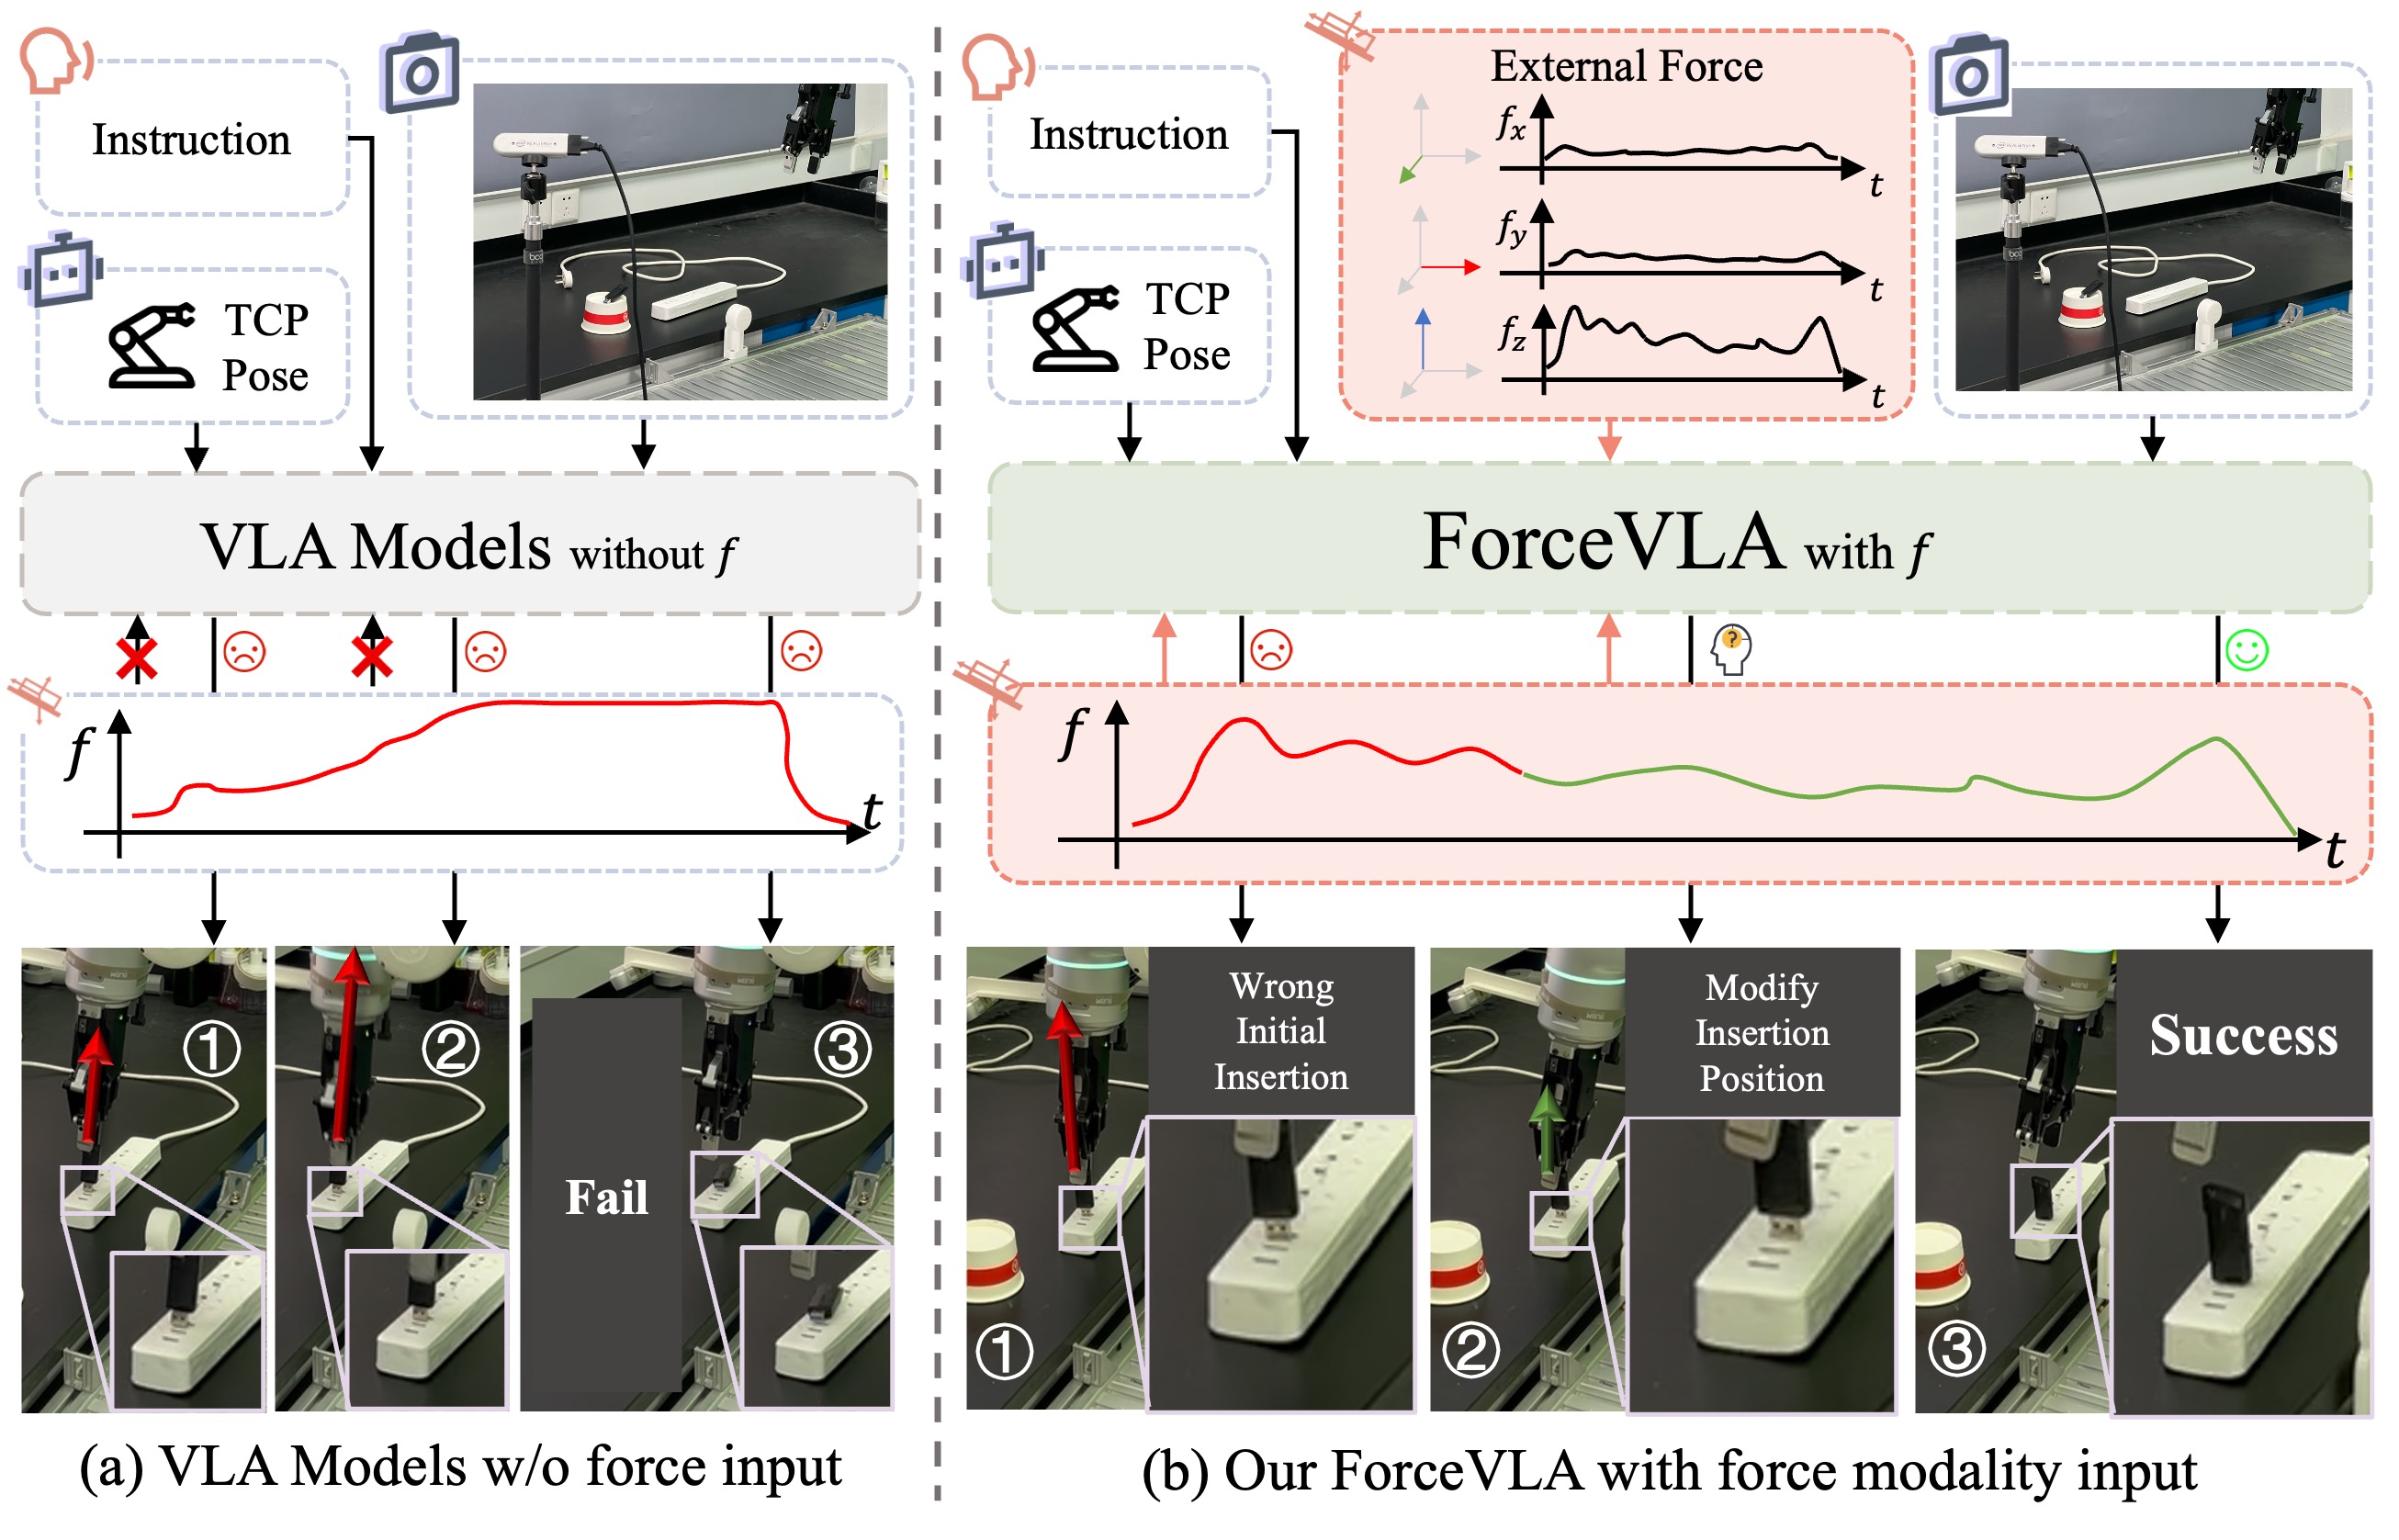
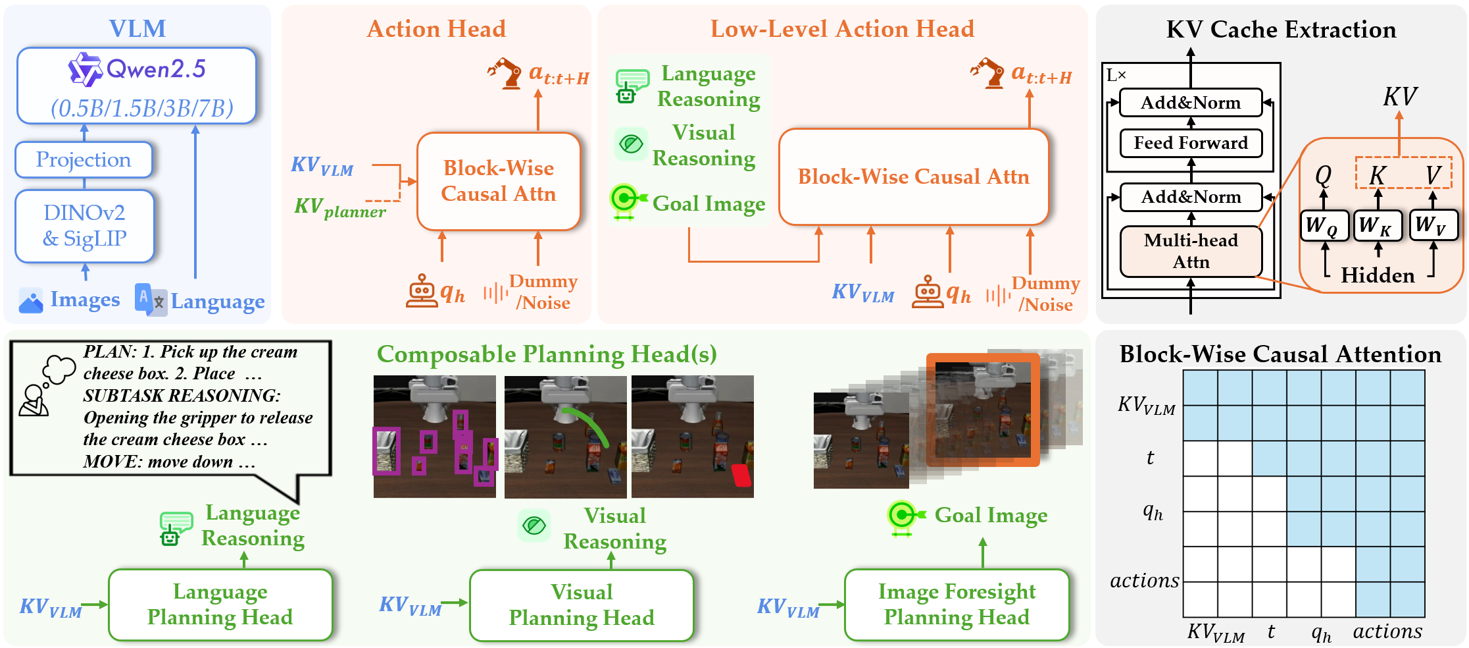
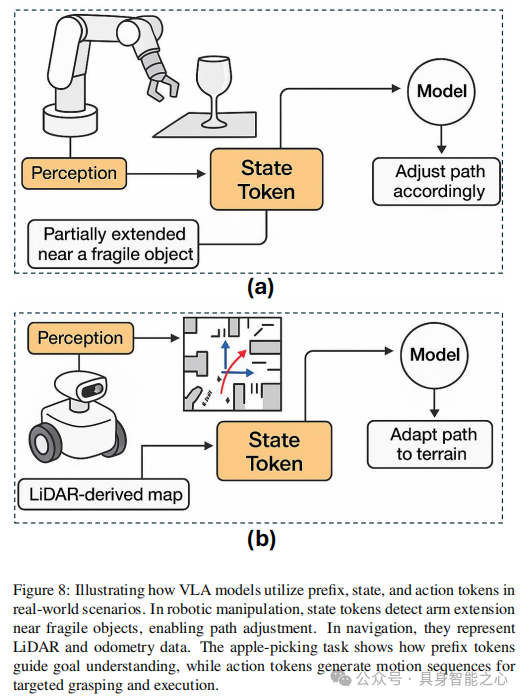
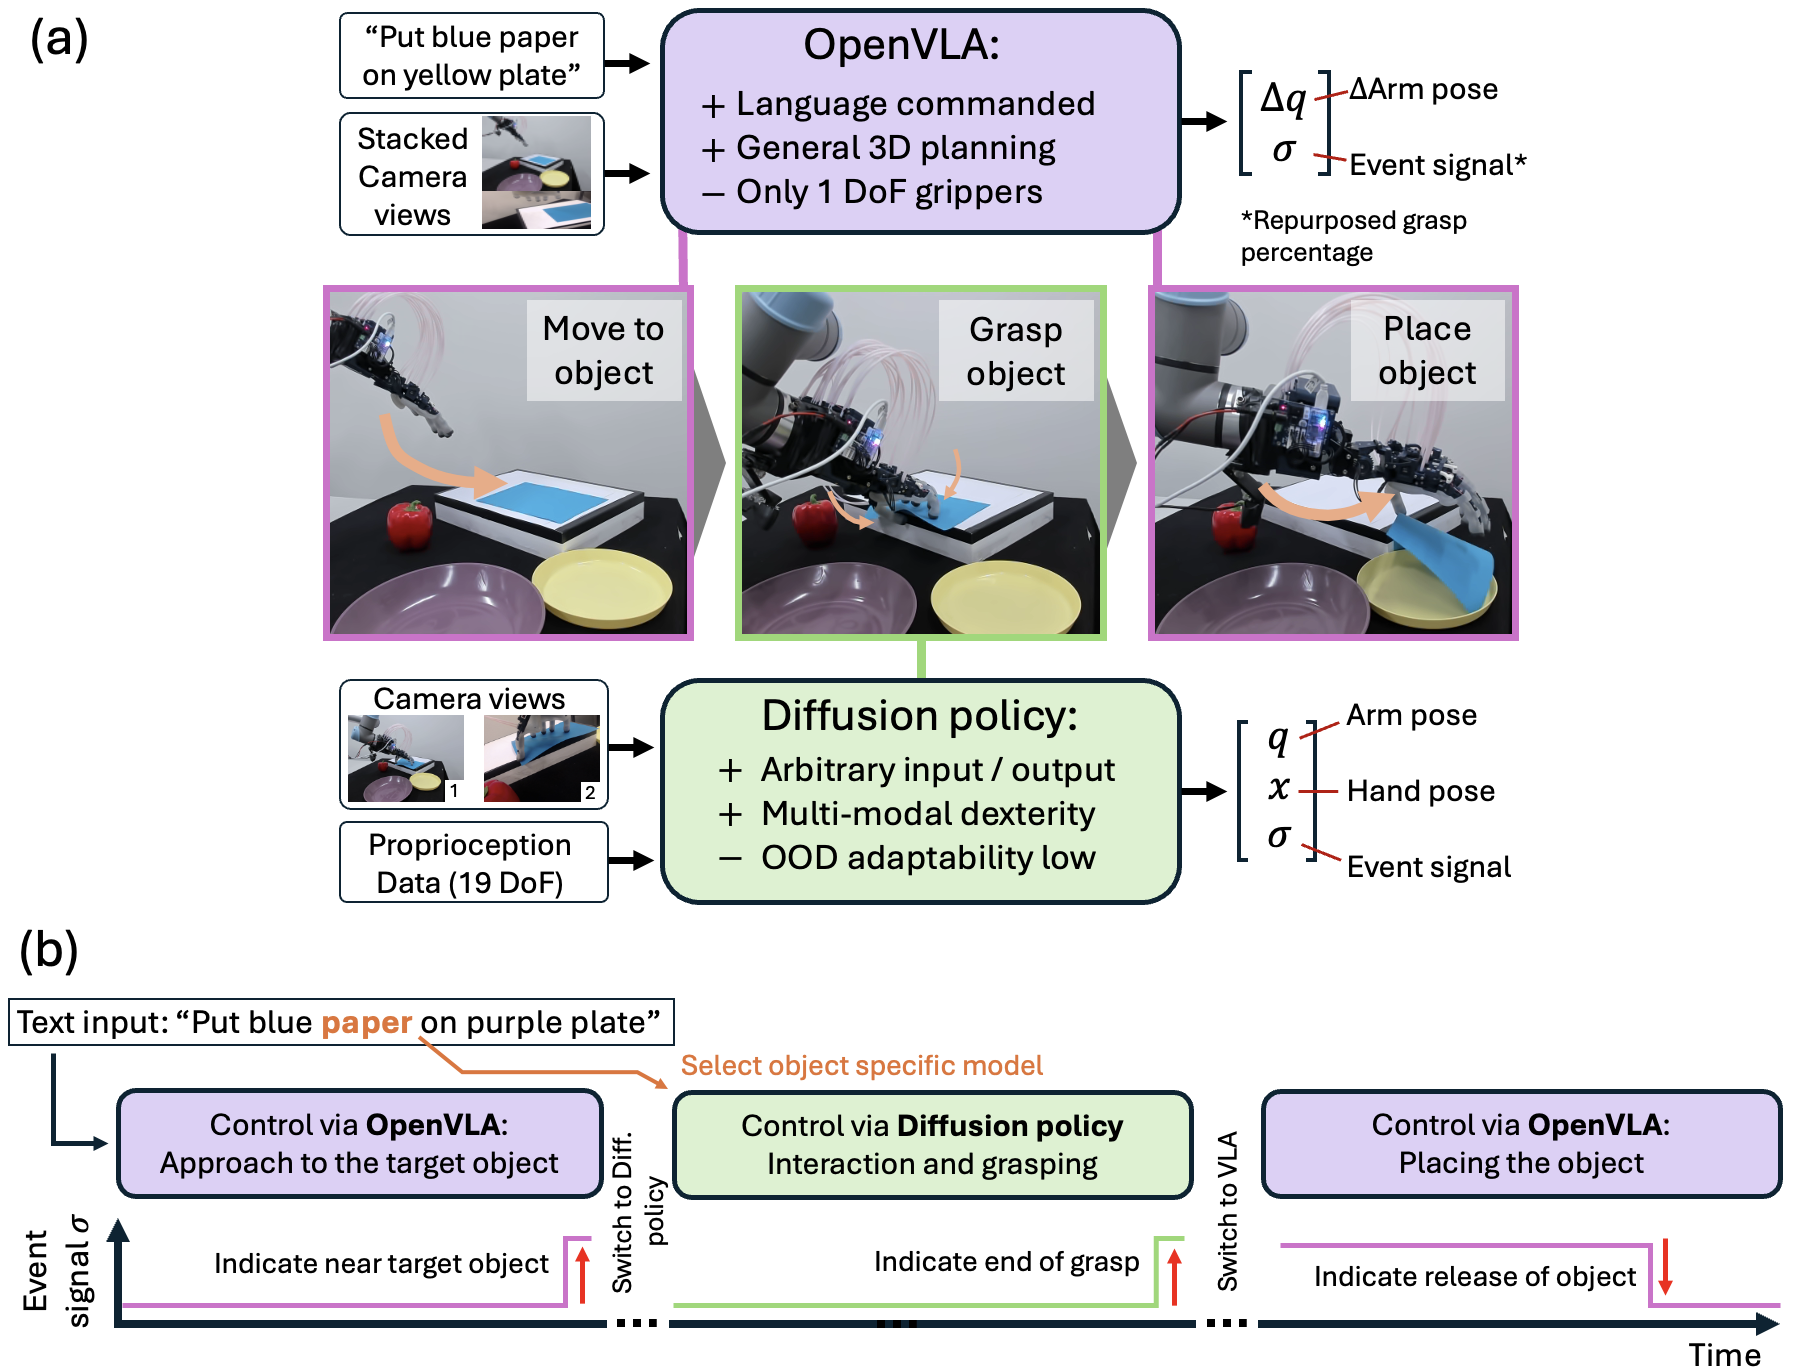
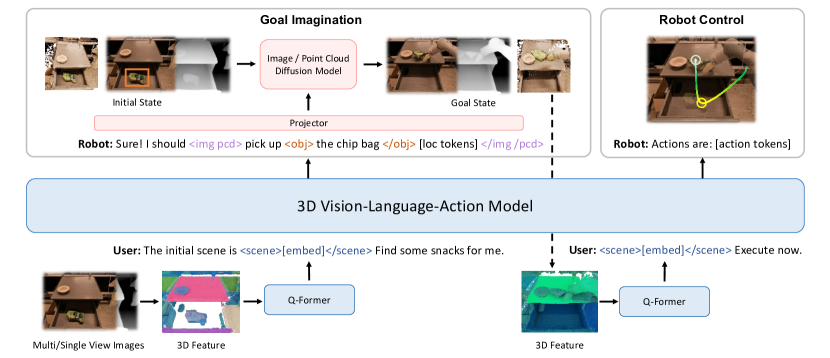
Document the past through numerous historically-significant Vla Models Example Task Input/output photographs. heritage-preserving showcasing photography, images, and pictures. ideal for museums and cultural institutions. The Vla Models Example Task Input/output collection maintains consistent quality standards across all images. Suitable for various applications including web design, social media, personal projects, and digital content creation All Vla Models Example Task Input/output images are available in high resolution with professional-grade quality, optimized for both digital and print applications, and include comprehensive metadata for easy organization and usage. Discover the perfect Vla Models Example Task Input/output images to enhance your visual communication needs. Professional licensing options accommodate both commercial and educational usage requirements. The Vla Models Example Task Input/output archive serves professionals, educators, and creatives across diverse industries. Comprehensive tagging systems facilitate quick discovery of relevant Vla Models Example Task Input/output content. Multiple resolution options ensure optimal performance across different platforms and applications. Diverse style options within the Vla Models Example Task Input/output collection suit various aesthetic preferences. Cost-effective licensing makes professional Vla Models Example Task Input/output photography accessible to all budgets. Whether for commercial projects or personal use, our Vla Models Example Task Input/output collection delivers consistent excellence.
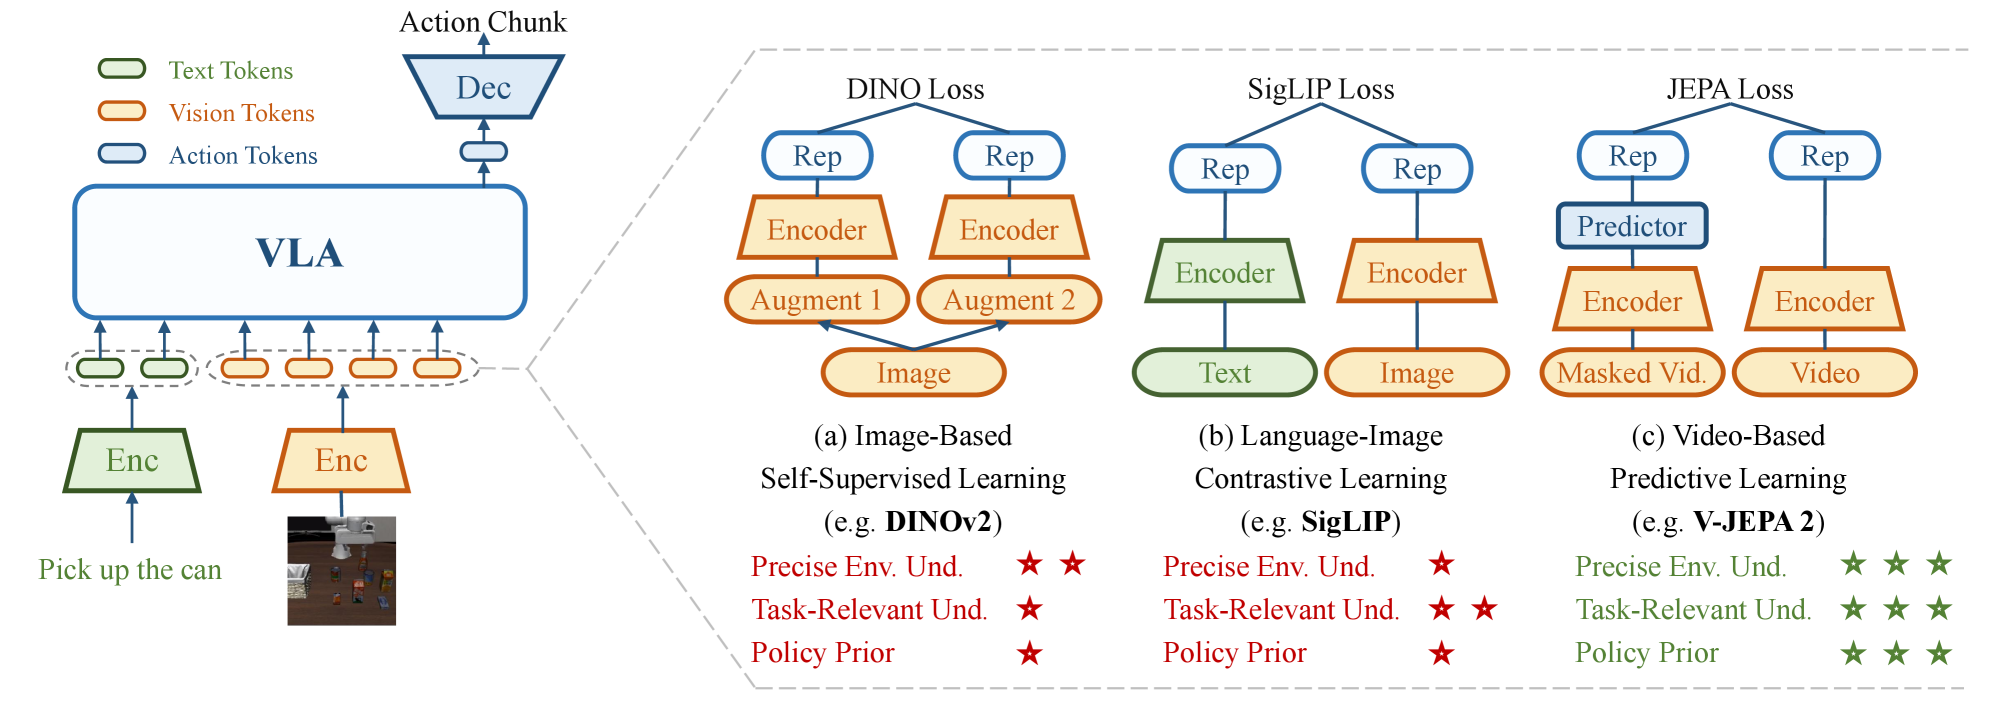
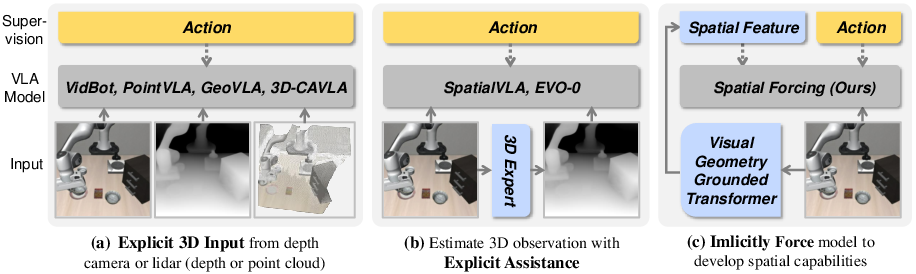
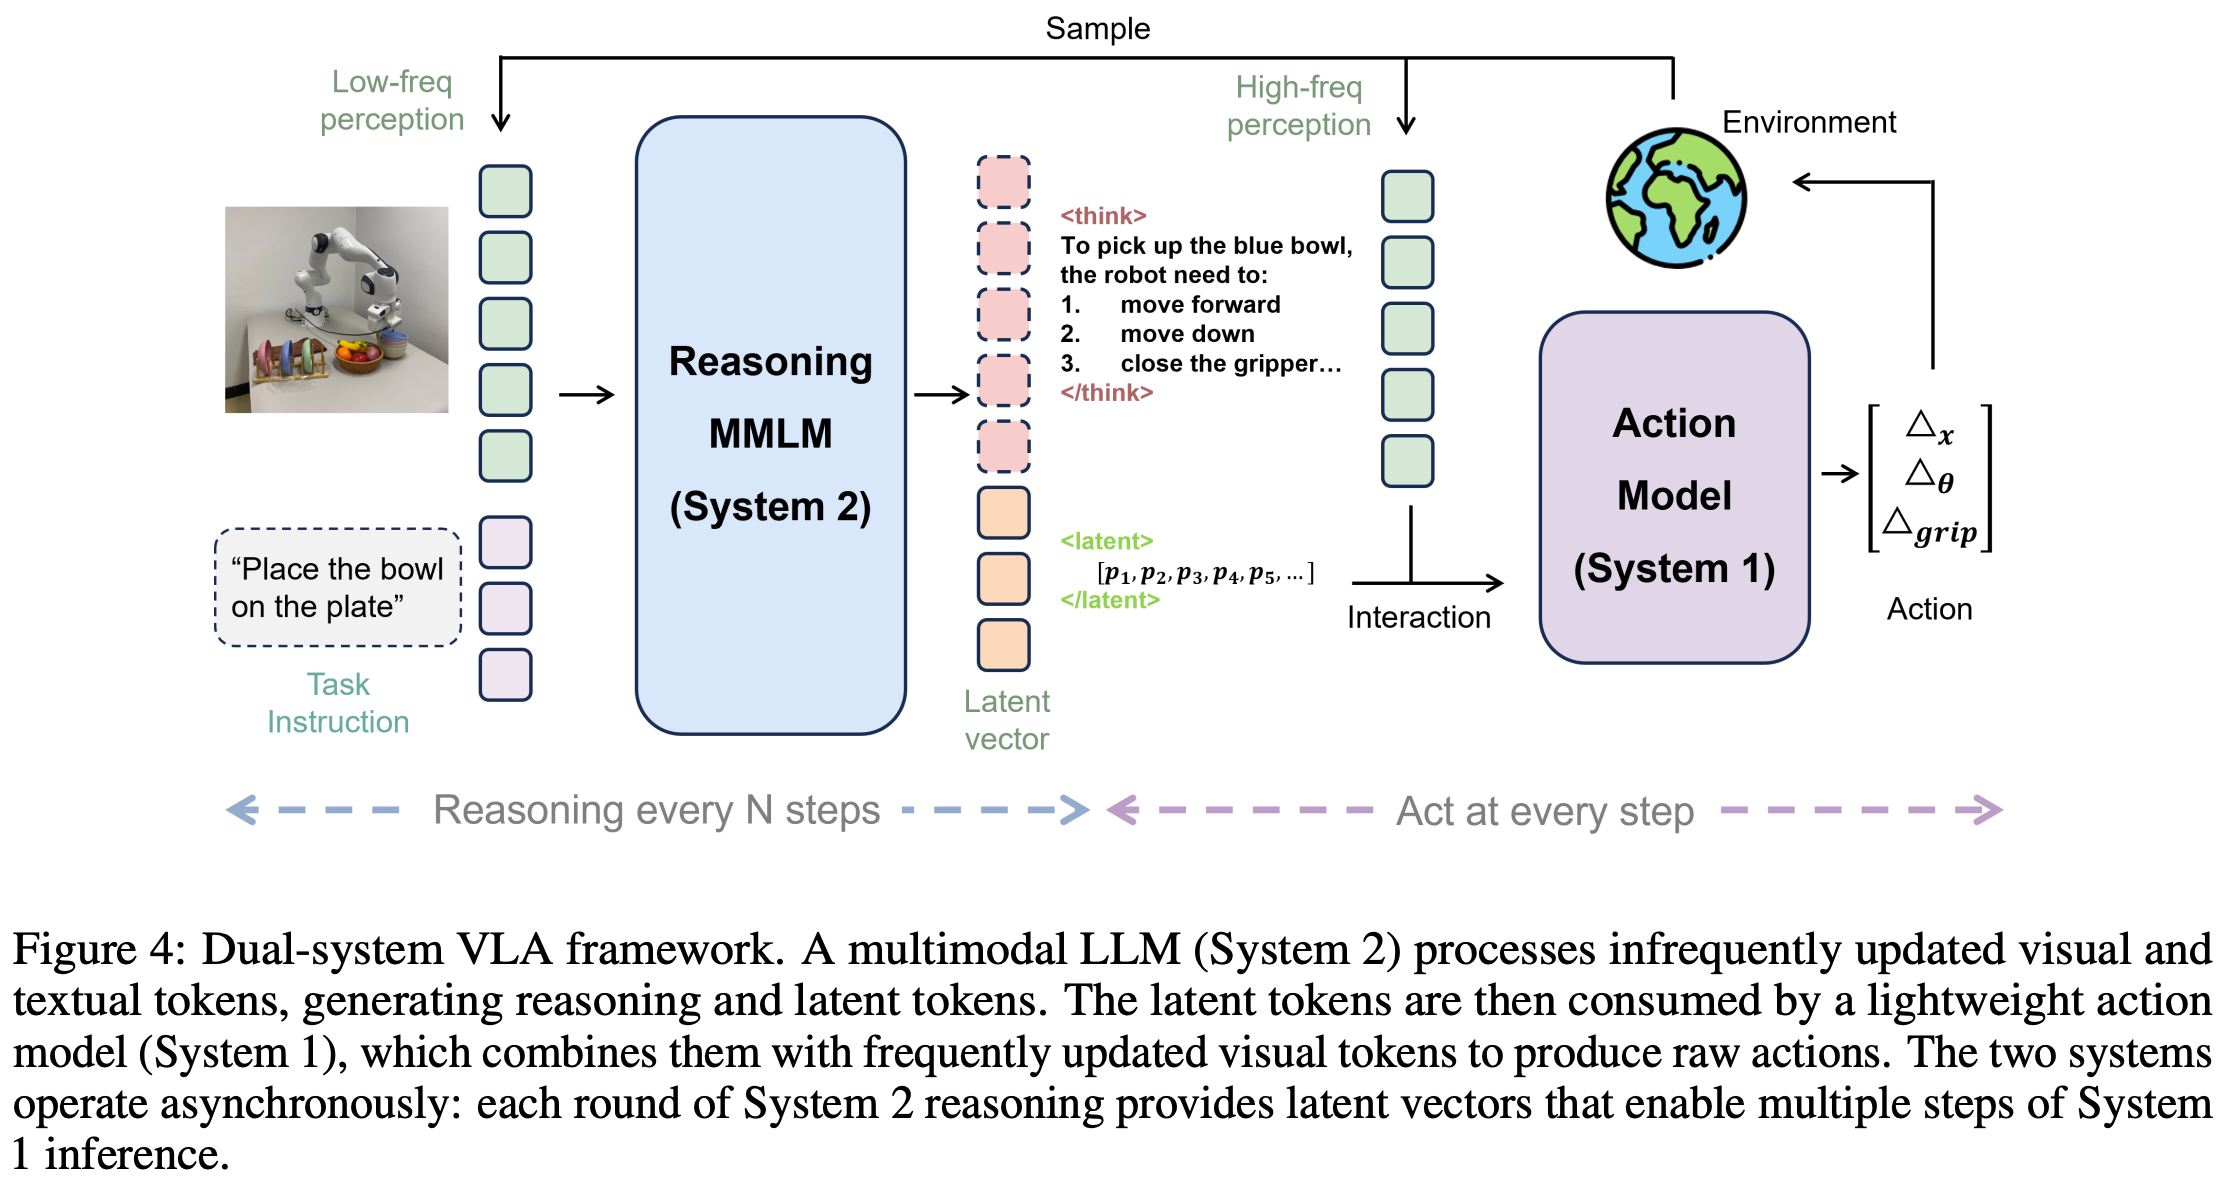
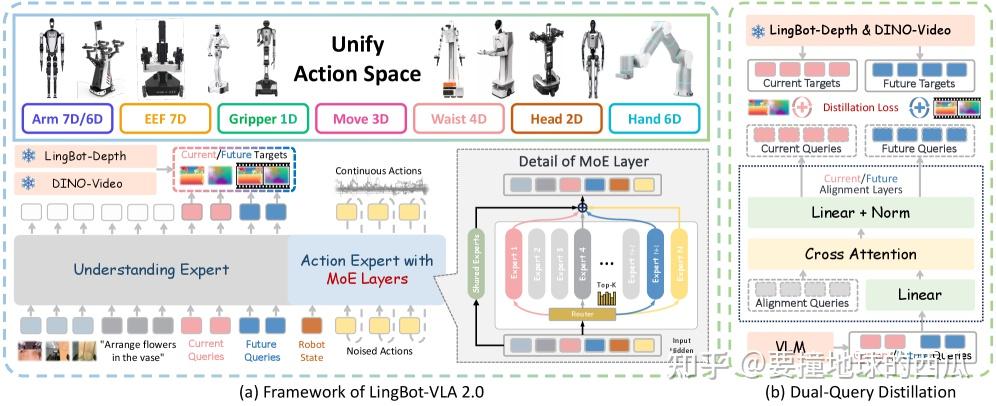
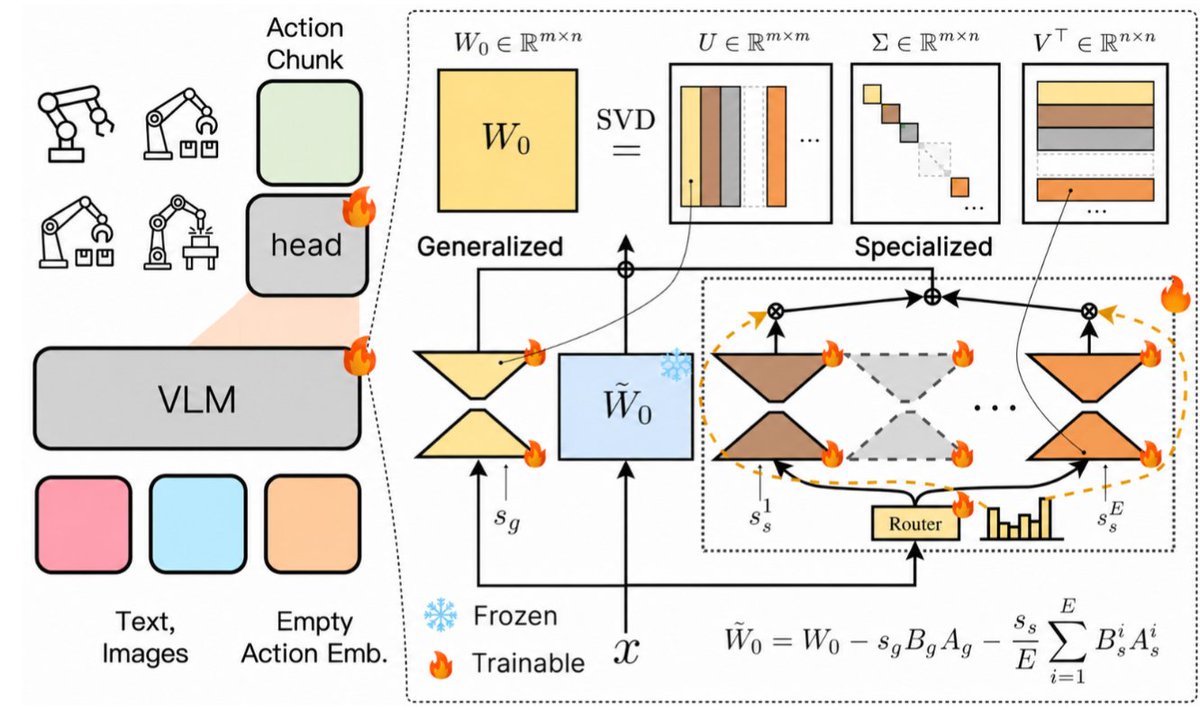


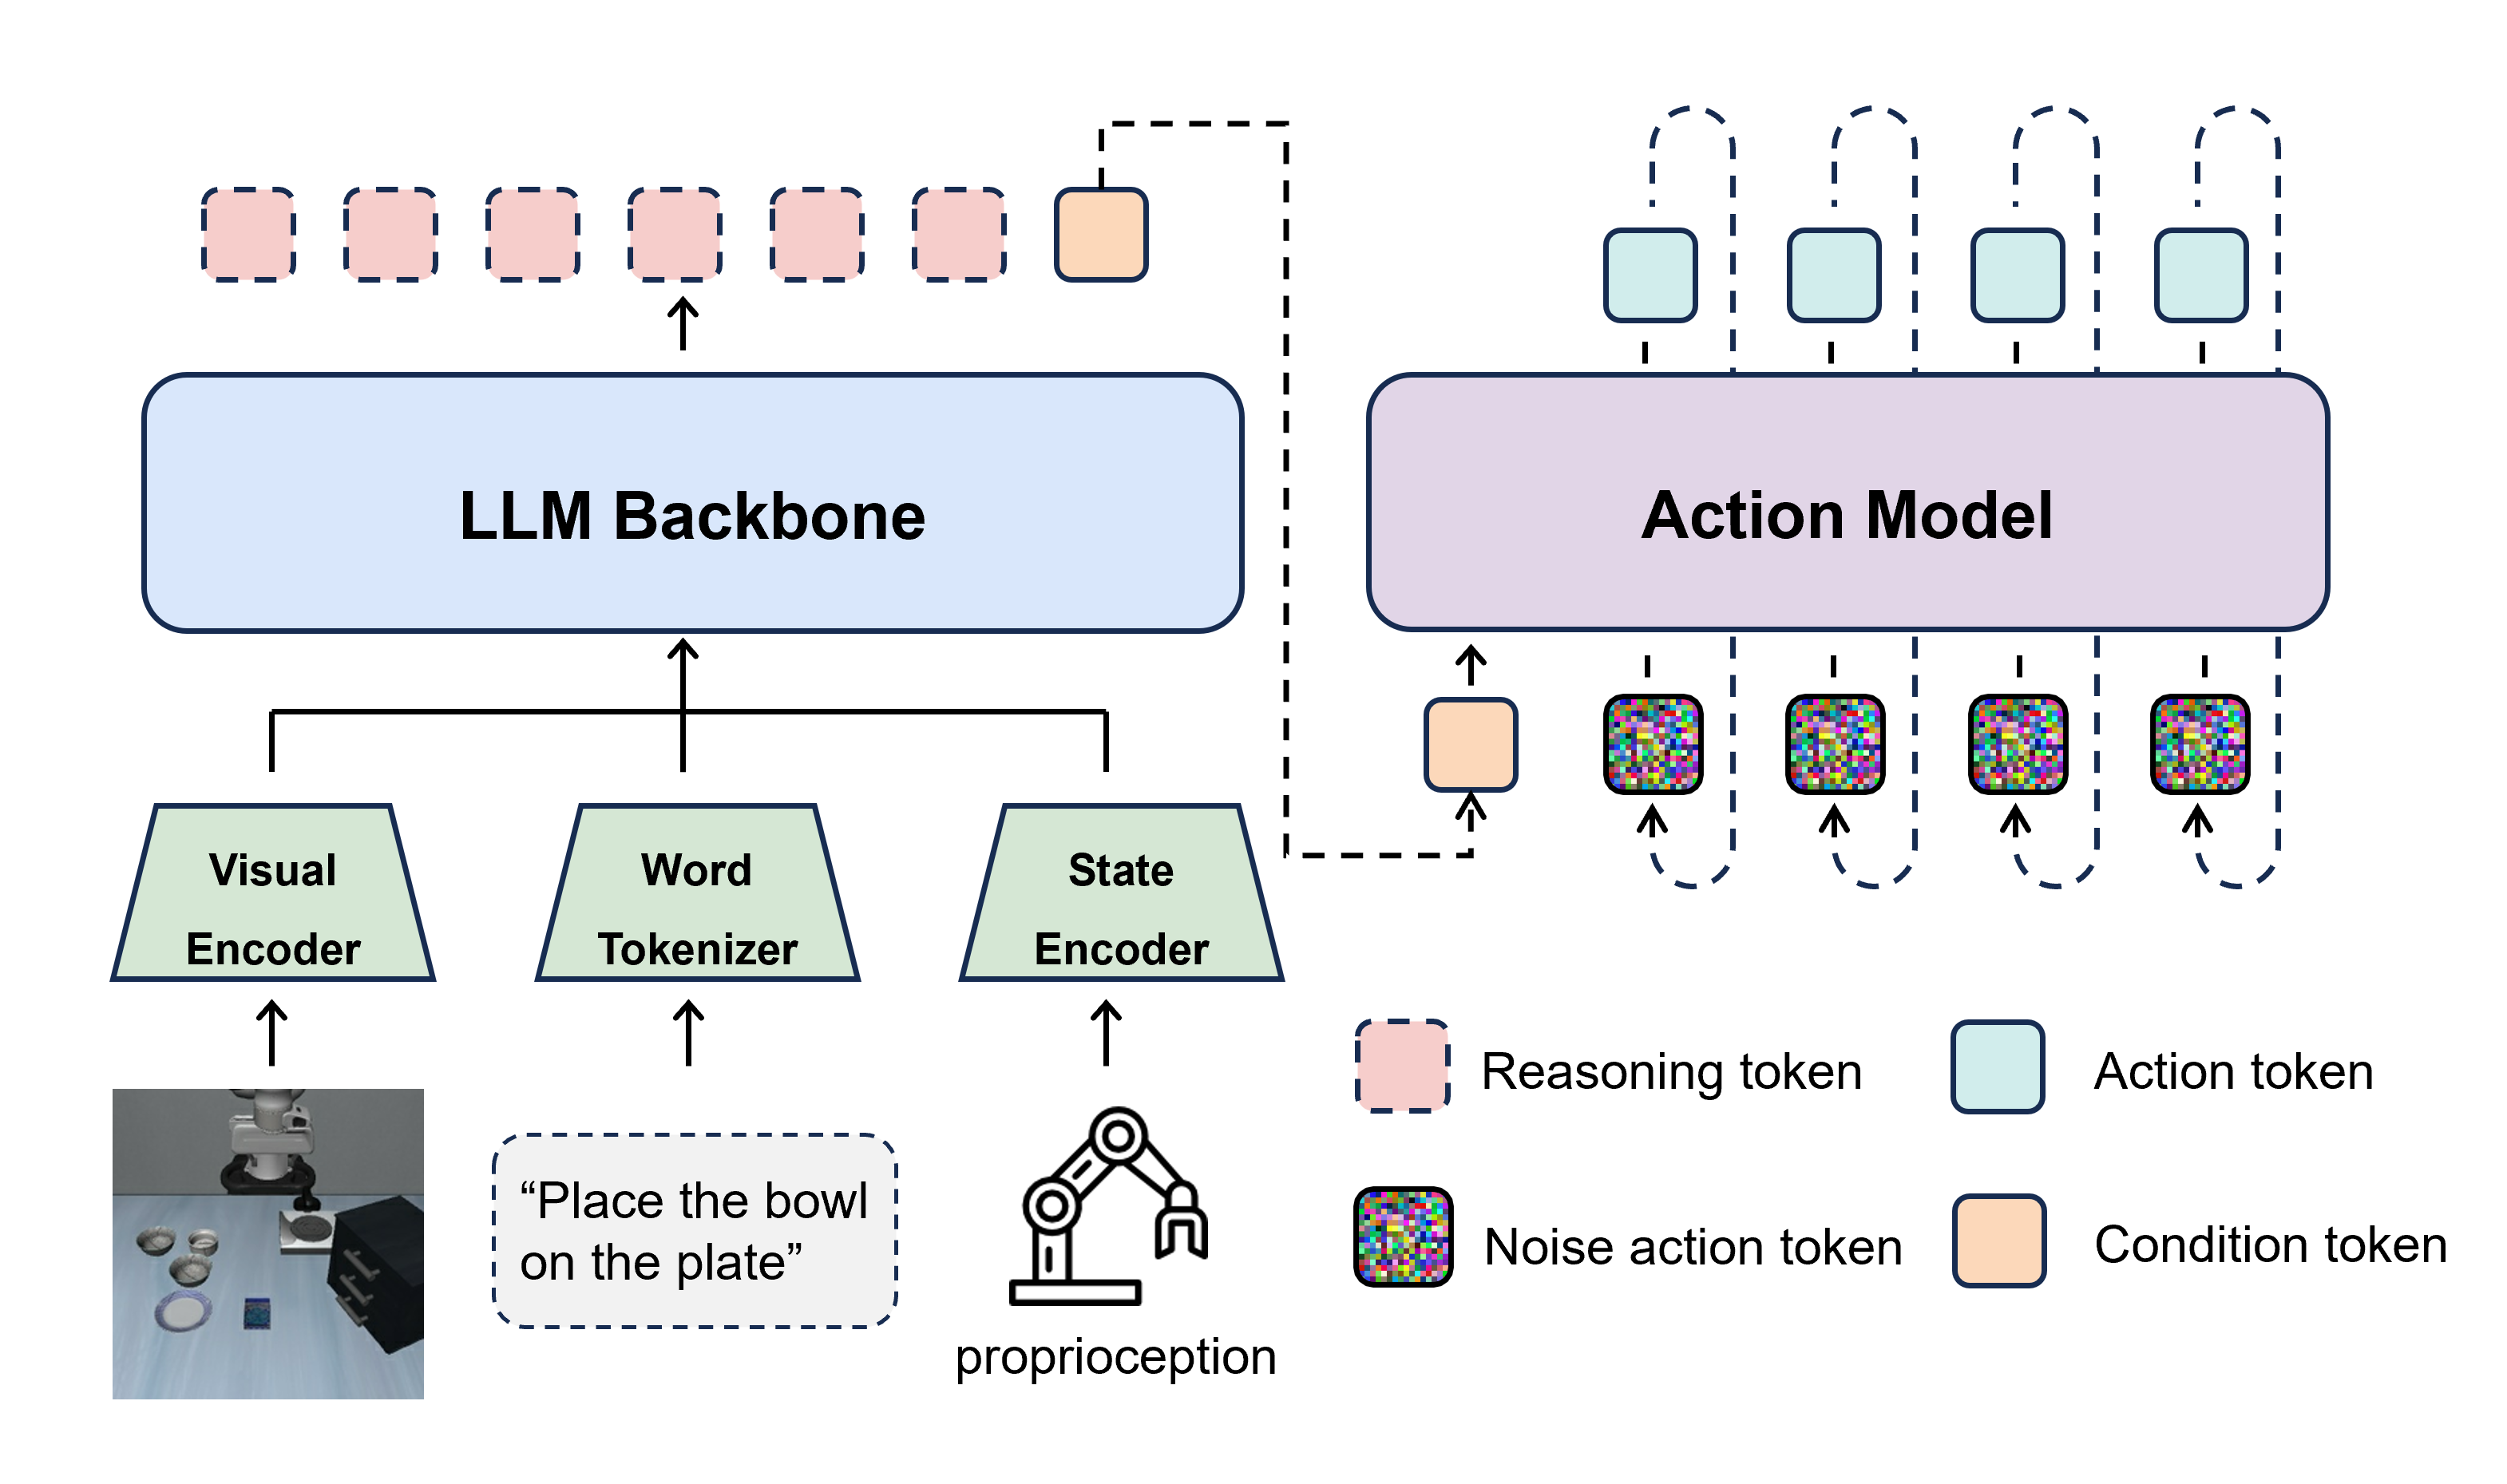
![Vla Models Example Task Input/output [论文评述] CognitiveDrone: A VLA Model and Evaluation Benchmark for Real ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/cognitivedrone-a-vla-model-and-evaluation-benchmark-for-real-time-cognitive-task-solving-and-reasoning-in-uavs-0.png)


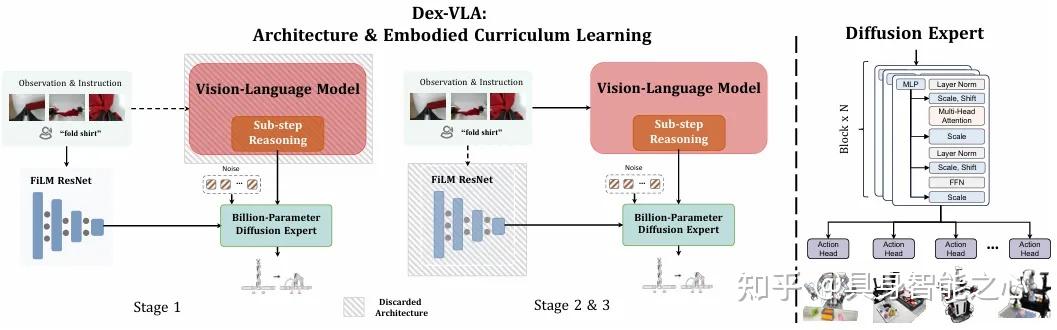
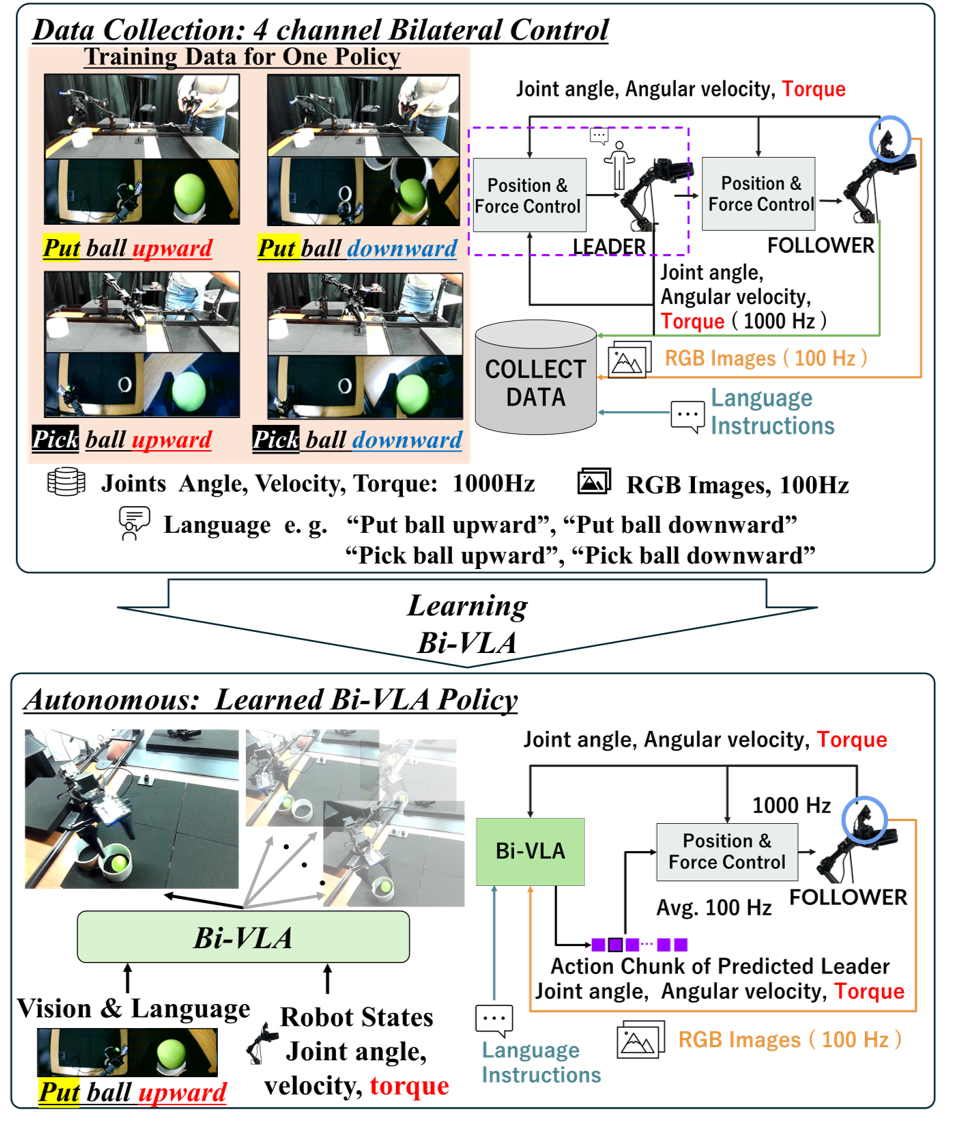
![Vla Models Example Task Input/output [논문 리뷰] VLA Model-Expert Collaboration for Bi-directional Manipulation ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/vla-model-expert-collaboration-for-bi-directional-manipulation-learning-0.png)
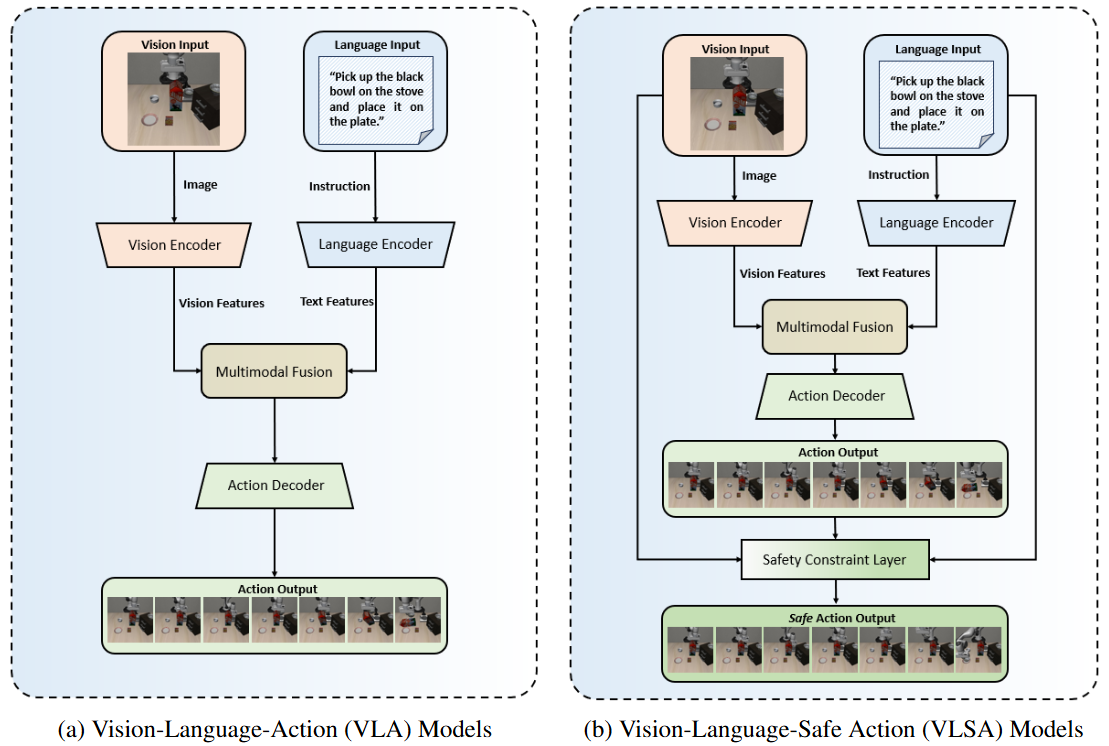


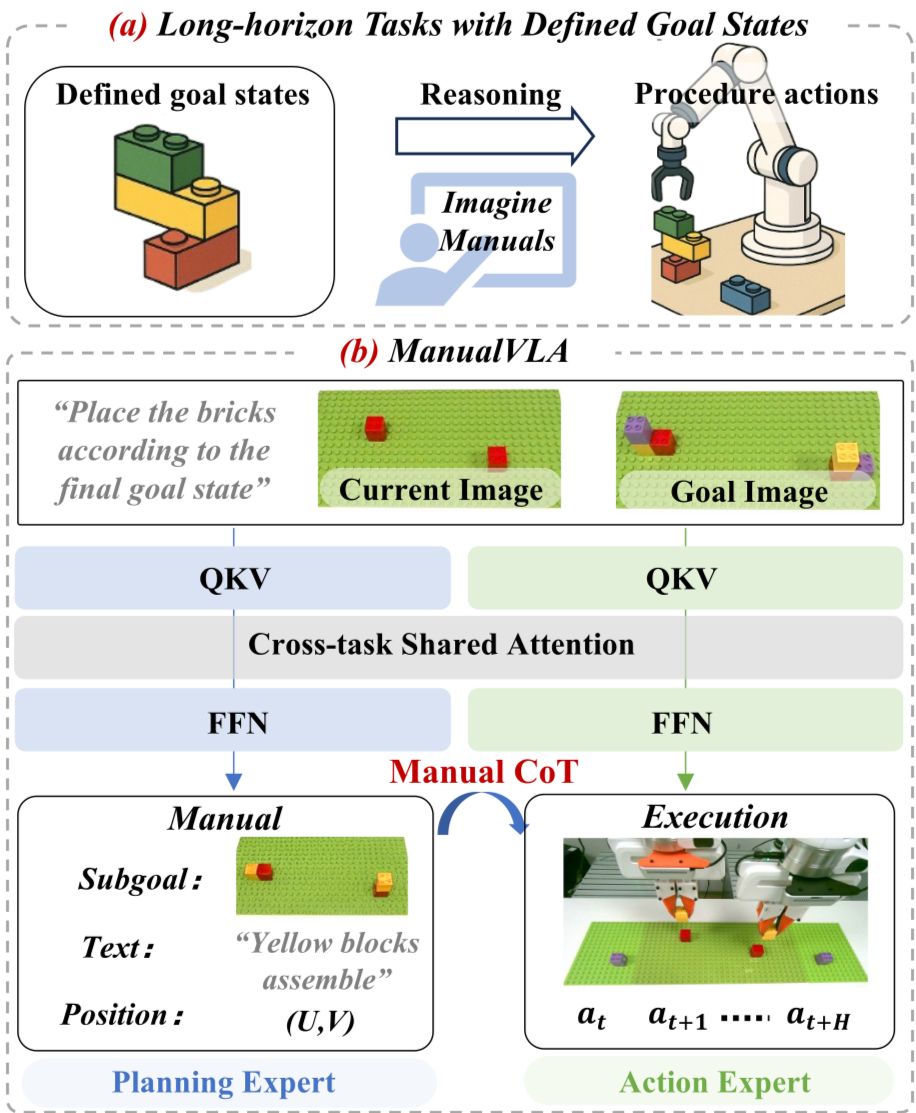
![Vla Models Example Task Input/output [论文评述] ManualVLA: A Unified VLA Model for Chain-of-Thought Manual ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/manualvla-a-unified-vla-model-for-chain-of-thought-manual-generation-and-robotic-manipulation-0.png)
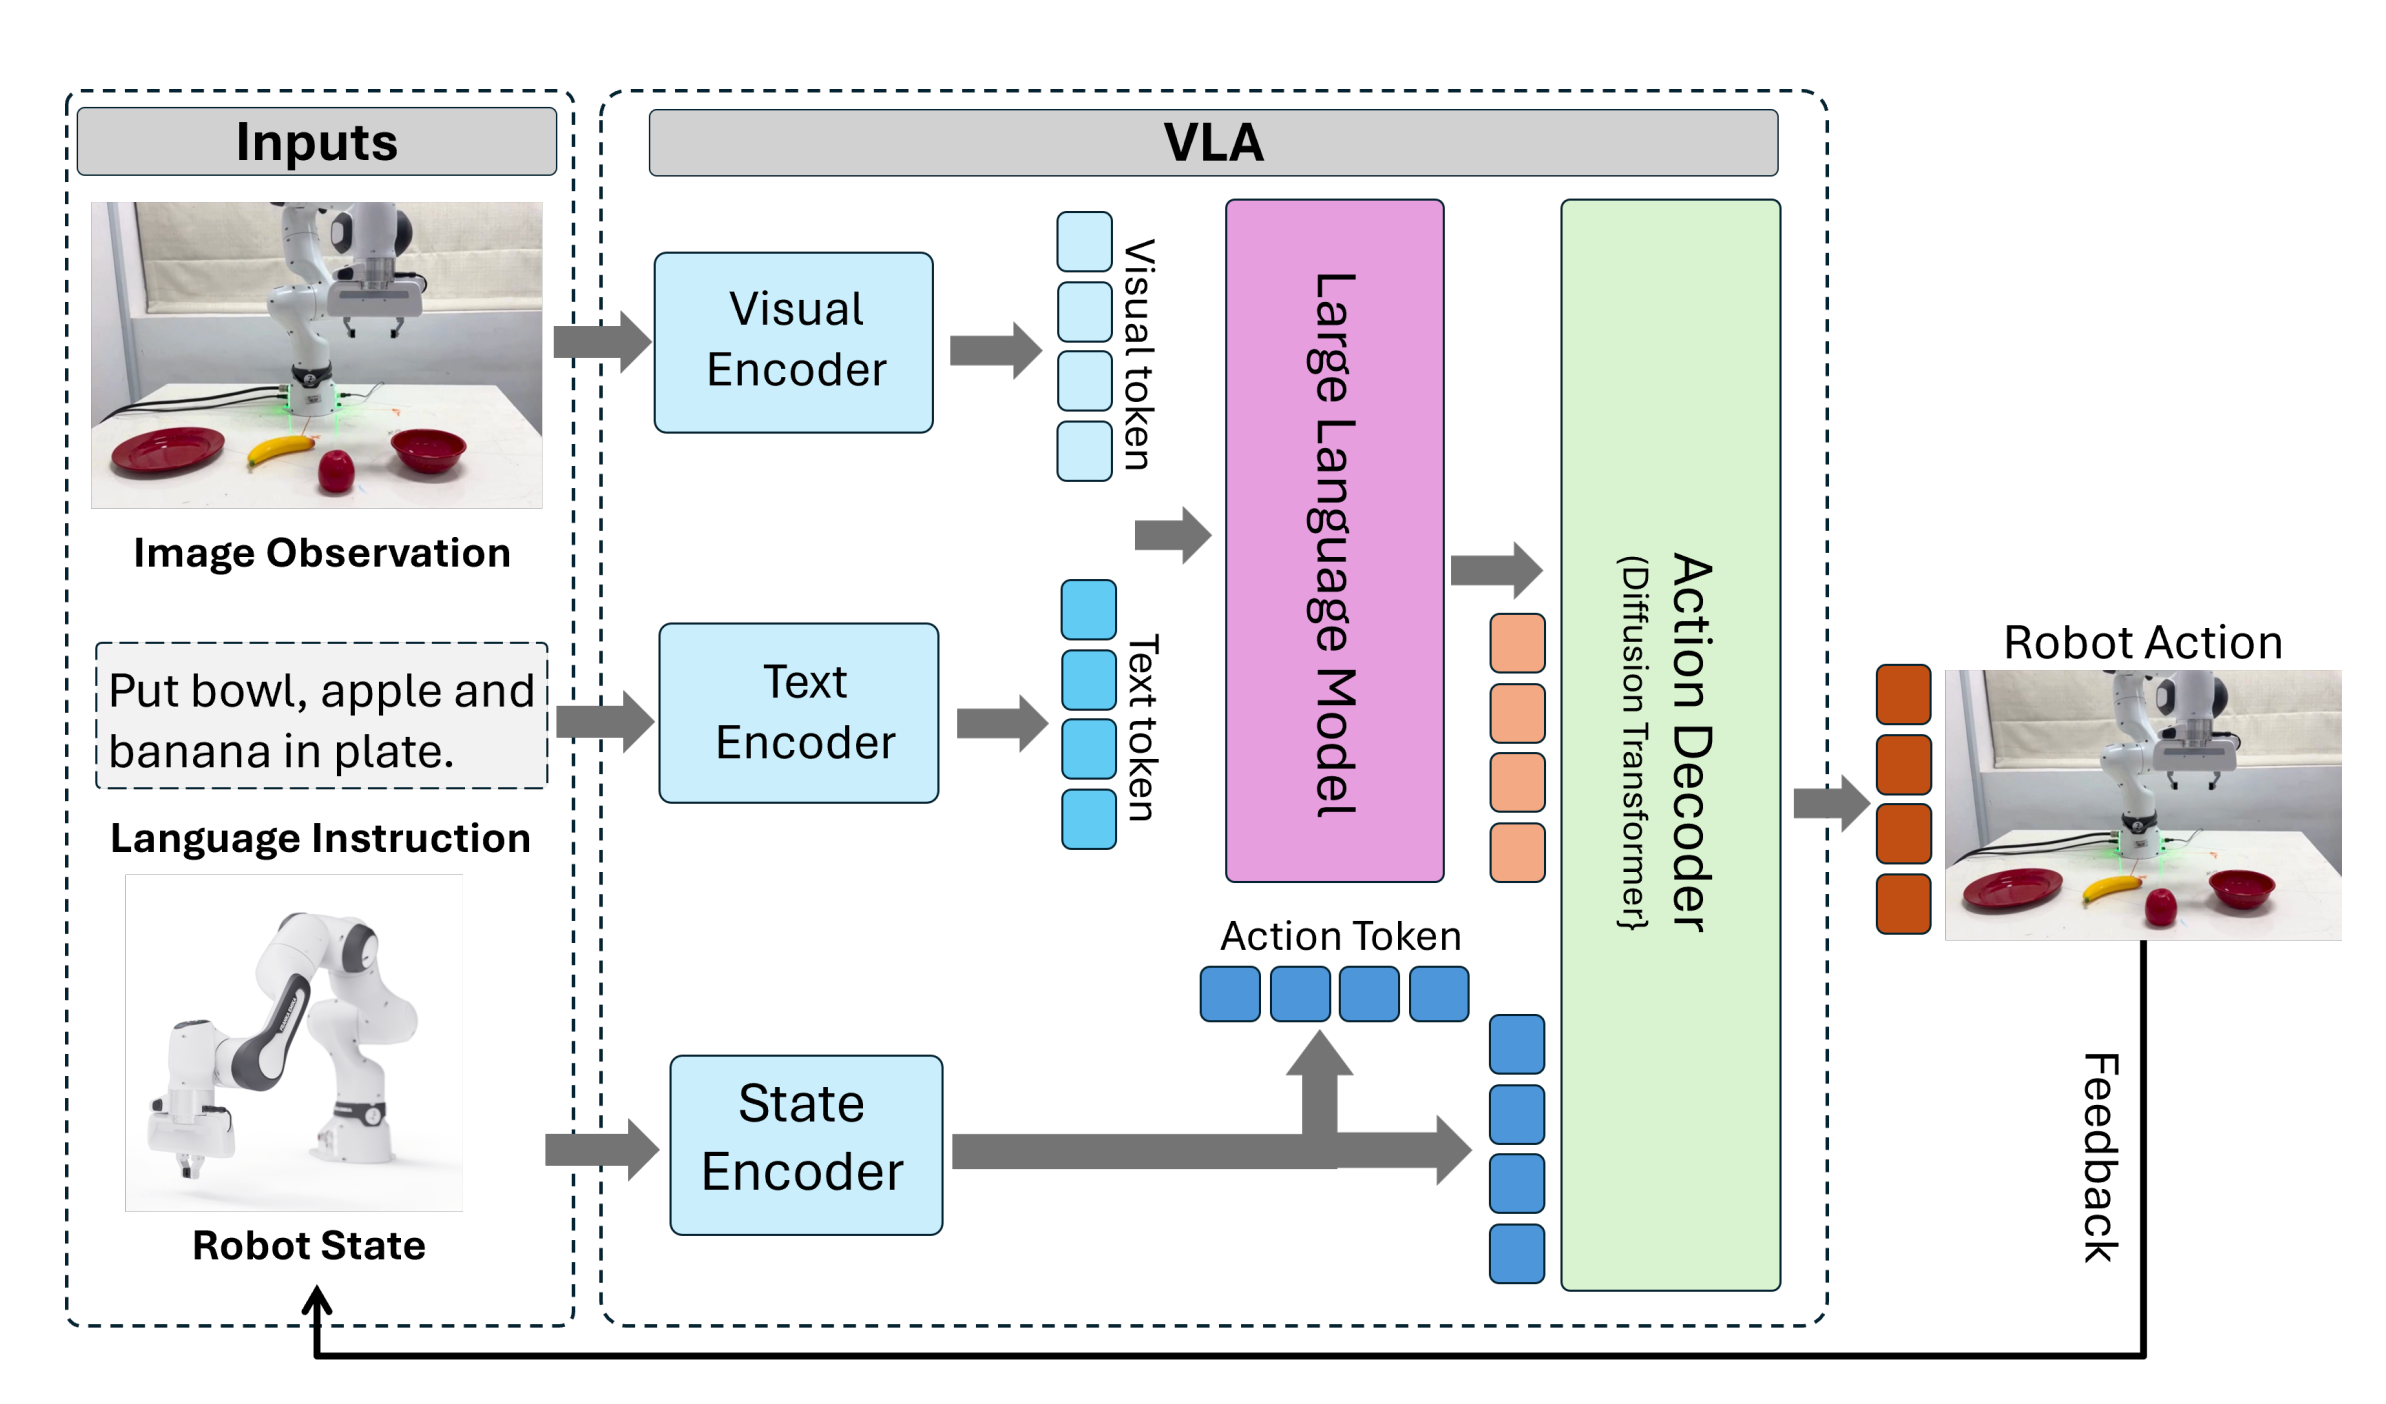


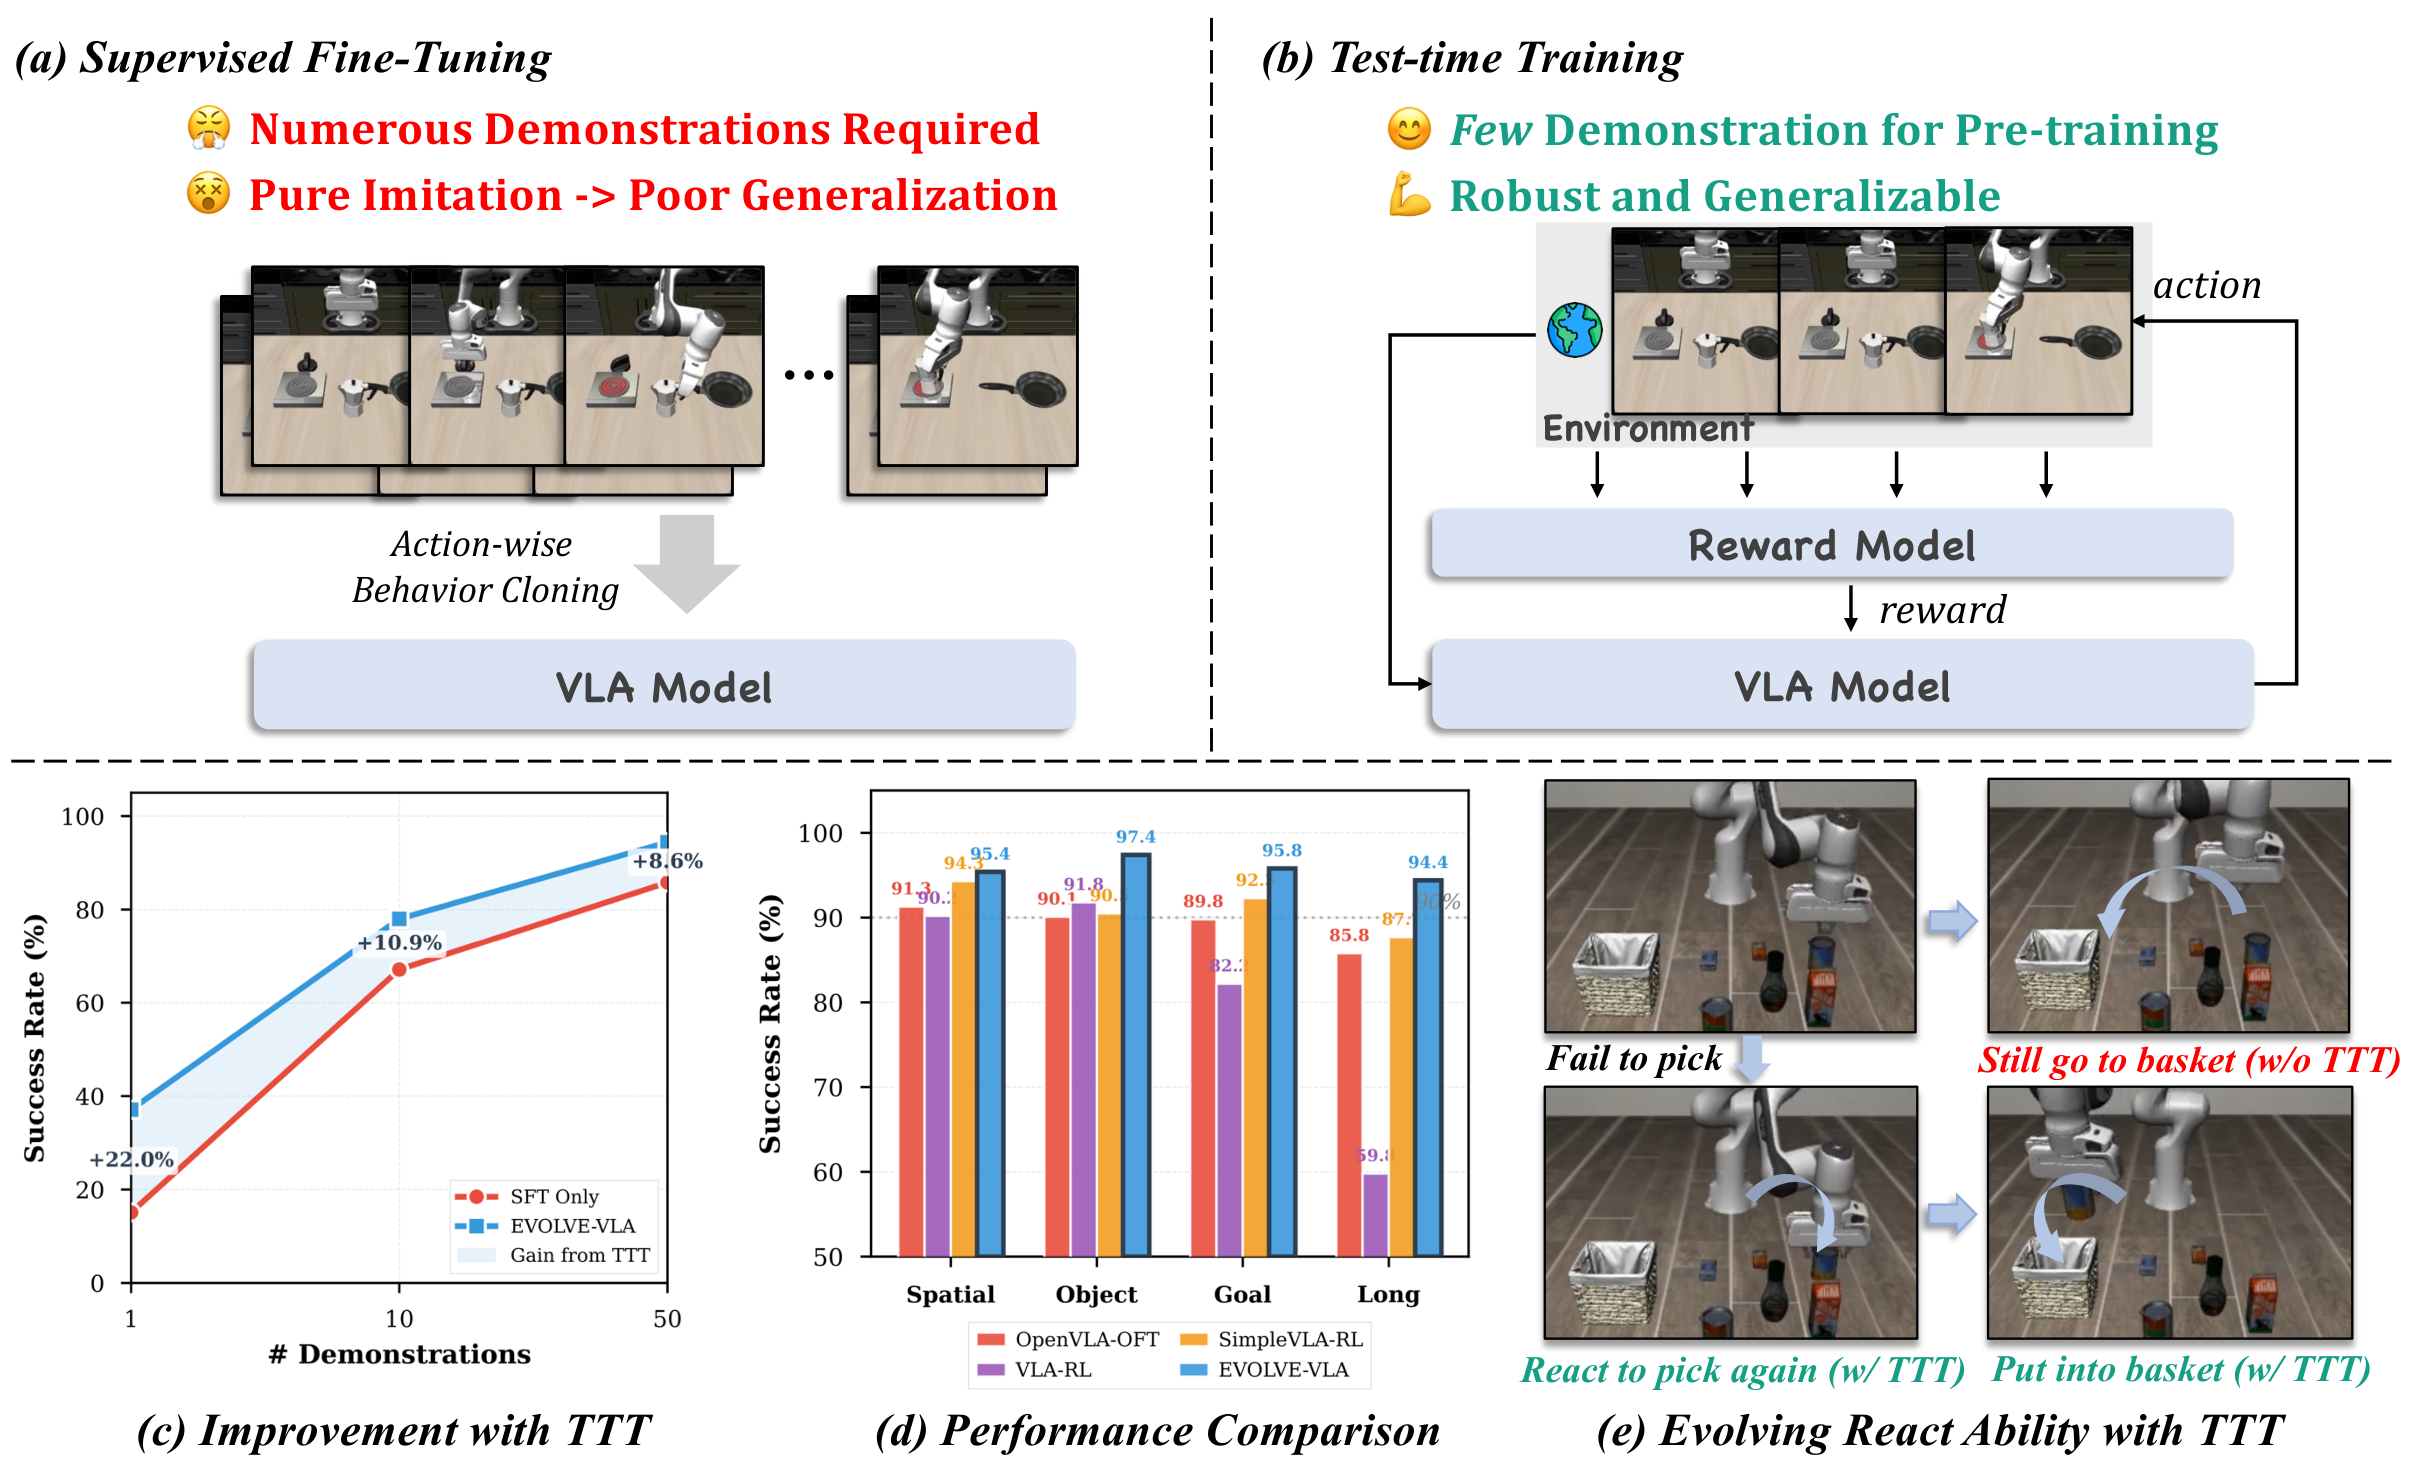
![Vla Models Example Task Input/output [论文评述] BridgeVLA: Input-Output Alignment for Efficient 3D Manipulation ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/bridgevla-input-output-alignment-for-efficient-3d-manipulation-learning-with-vision-language-models-1.png)


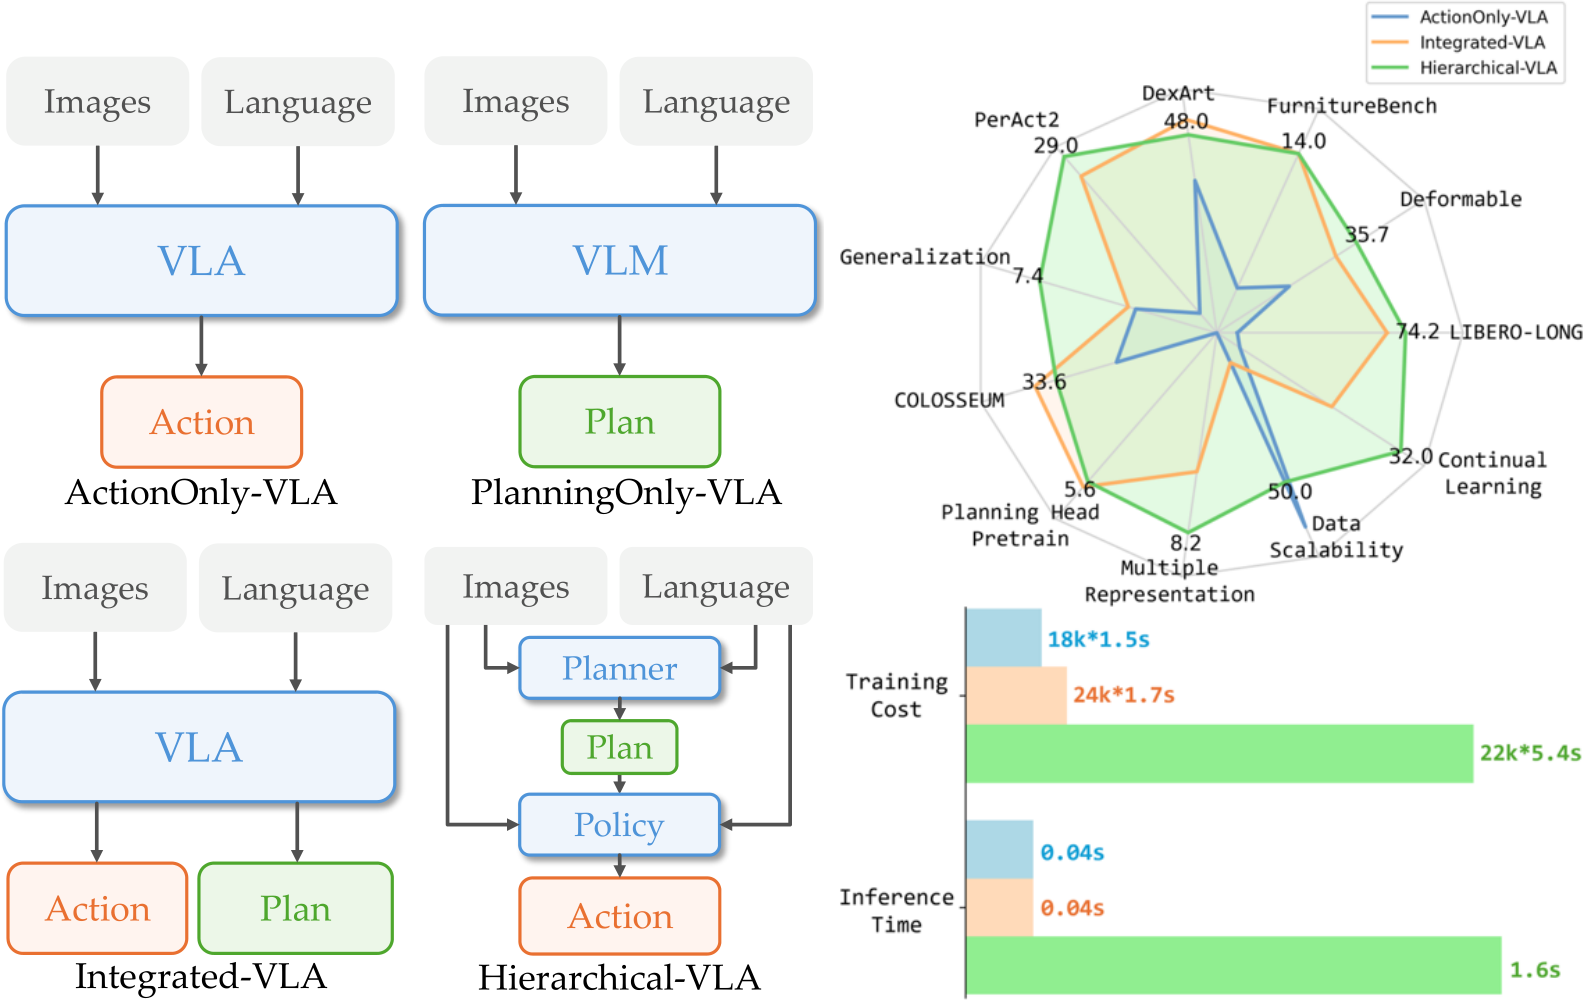
![Vla Models Example Task Input/output [PDF] Pure Vision Language Action (VLA) Models: A Comprehensive Survey ...](https://figures.semanticscholar.org/cf3e01ec29ce6d6ec3446646327bd6b54fea9d6f/500px/2-Figure2-1.png)
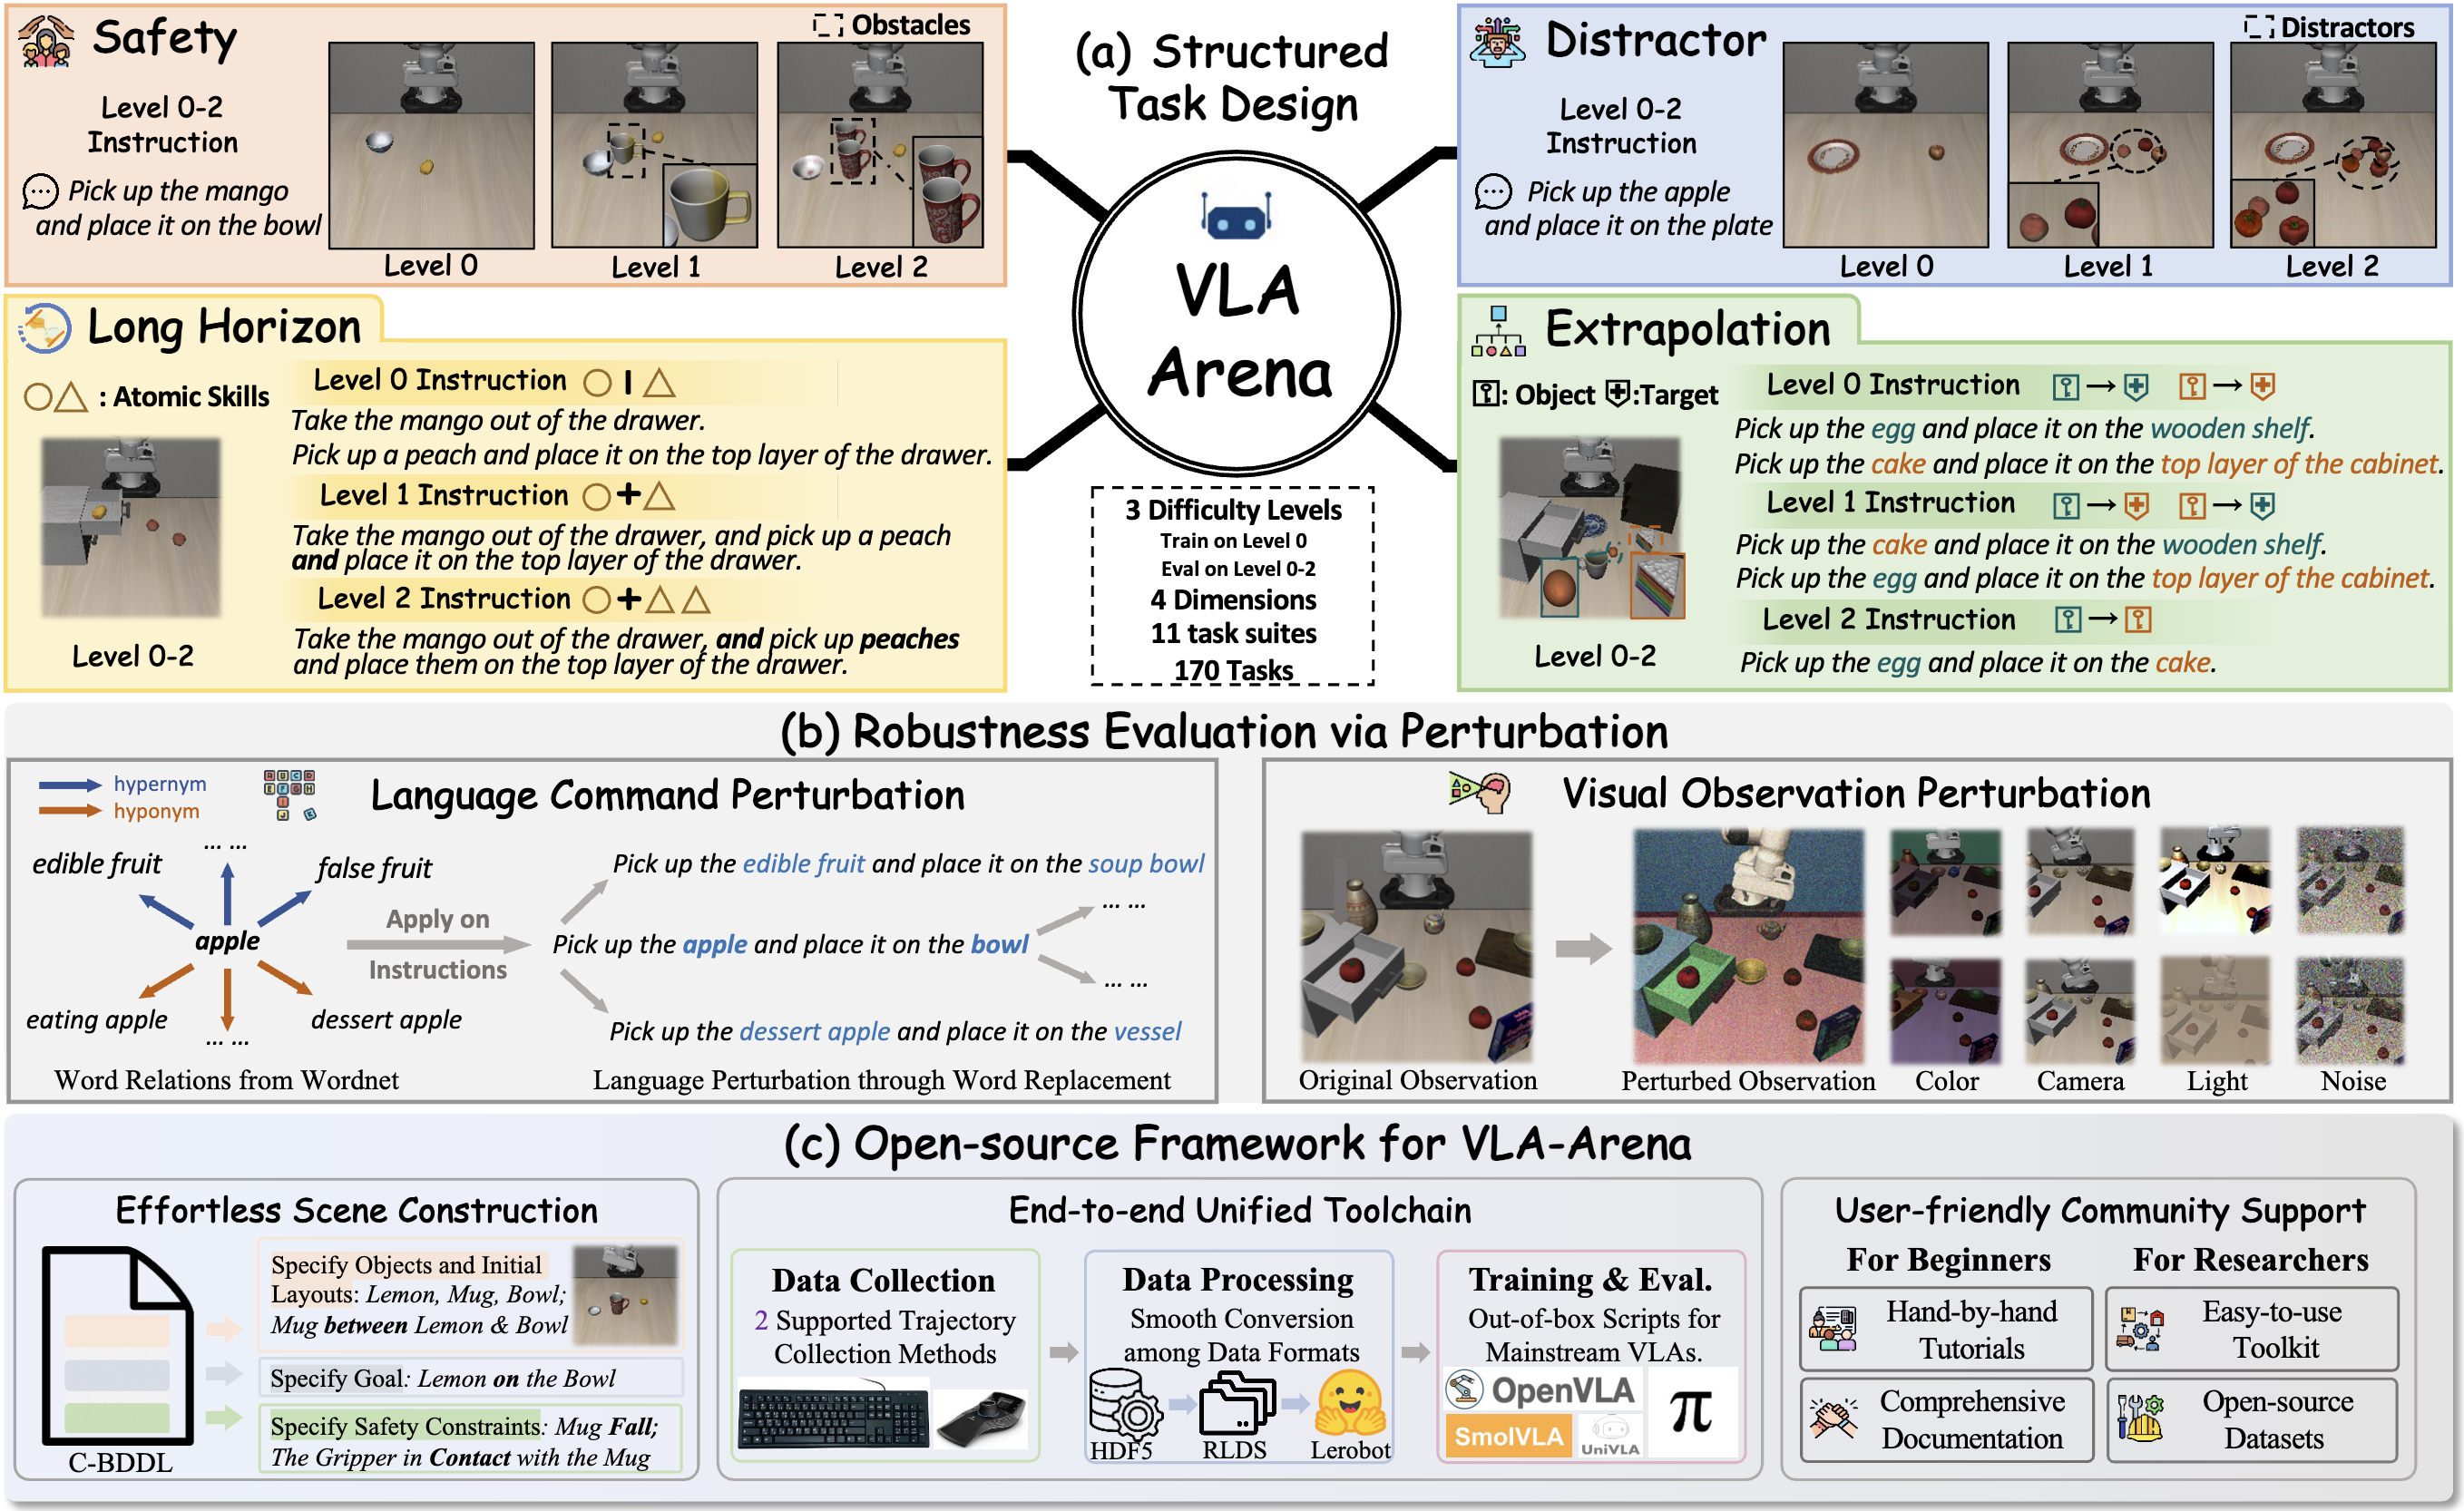

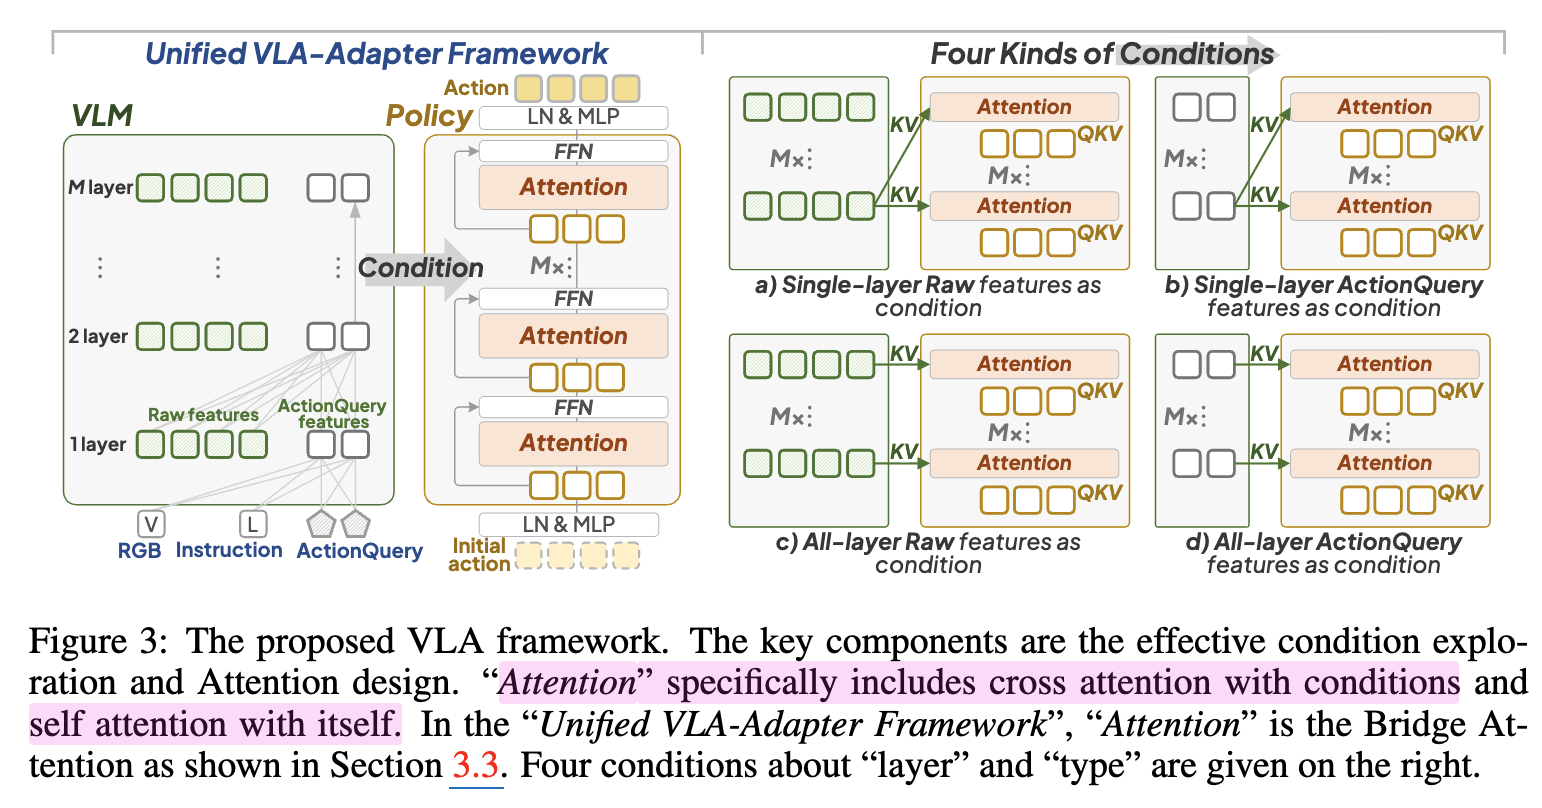
![Vla Models Example Task Input/output [VLA] VLA-Adapter: An Effective Paradigm for Tiny-Scale Vision-Language ...](https://bloomberry.github.io/images/2025-09-17/image-20250917111600164.png)


![Vla Models Example Task Input/output [PDF] Pure Vision Language Action (VLA) Models: A Comprehensive Survey ...](https://figures.semanticscholar.org/cf3e01ec29ce6d6ec3446646327bd6b54fea9d6f/1-Figure1-1.png)
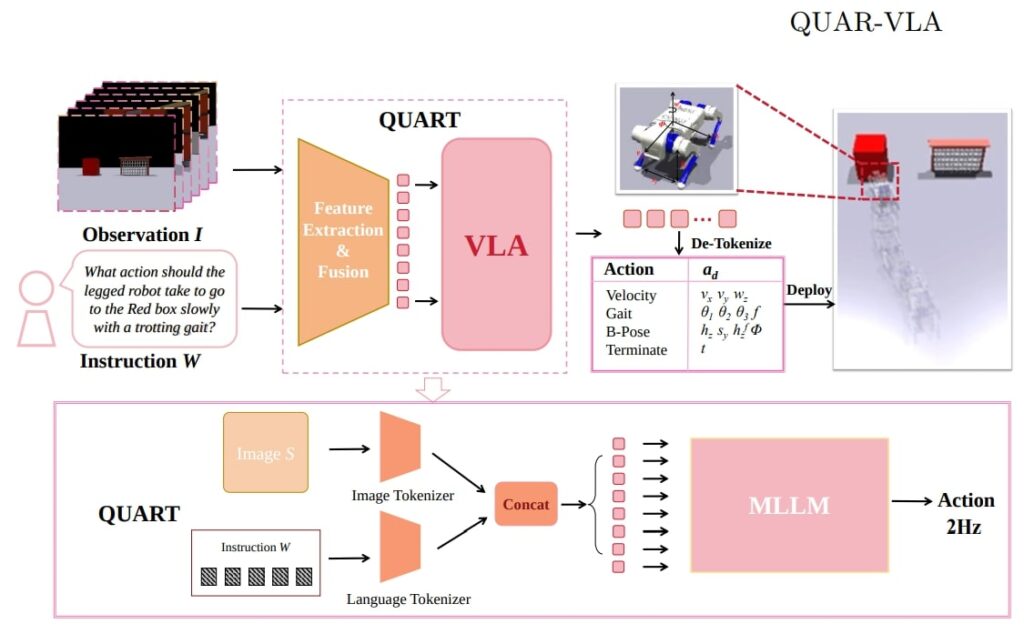
![Vla Models Example Task Input/output [논문 리뷰] OpenHelix: A Short Survey, Empirical Analysis, and Open-Source ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/openhelix-a-short-survey-empirical-analysis-and-open-source-dual-system-vla-model-for-robotic-manipulation-2.png)
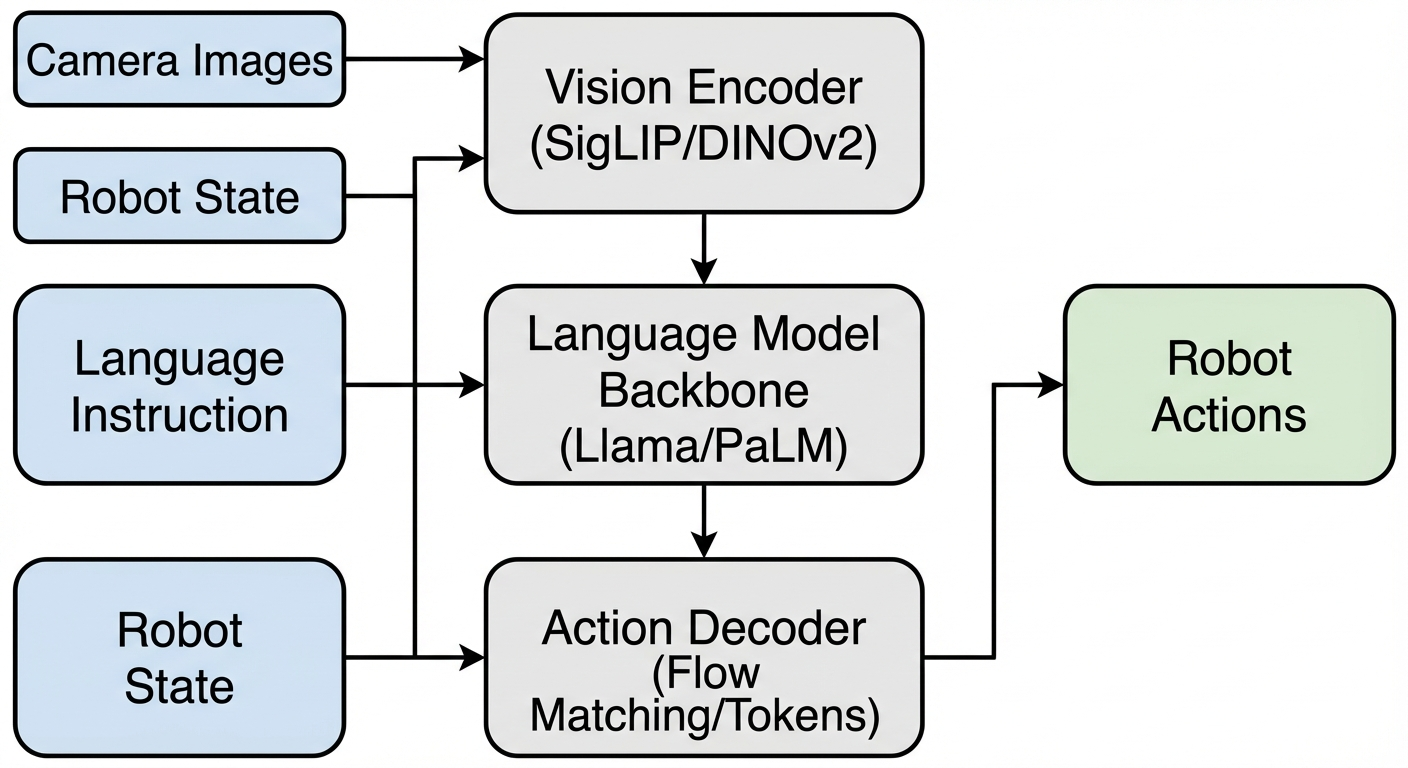


![Vla Models Example Task Input/output GitHub - Li-XD-Pro/SS-VLA: [TCSVT 2026] This repository serves as the ...](https://github.com/Li-XD-Pro/SS-VLA/raw/main/.asert/model.png)

![Vla Models Example Task Input/output [2511.17502] RynnVLA-002: A Unified Vision-Language-Action and World Model](https://ar5iv.labs.arxiv.org/html/2511.17502/assets/x1.png)
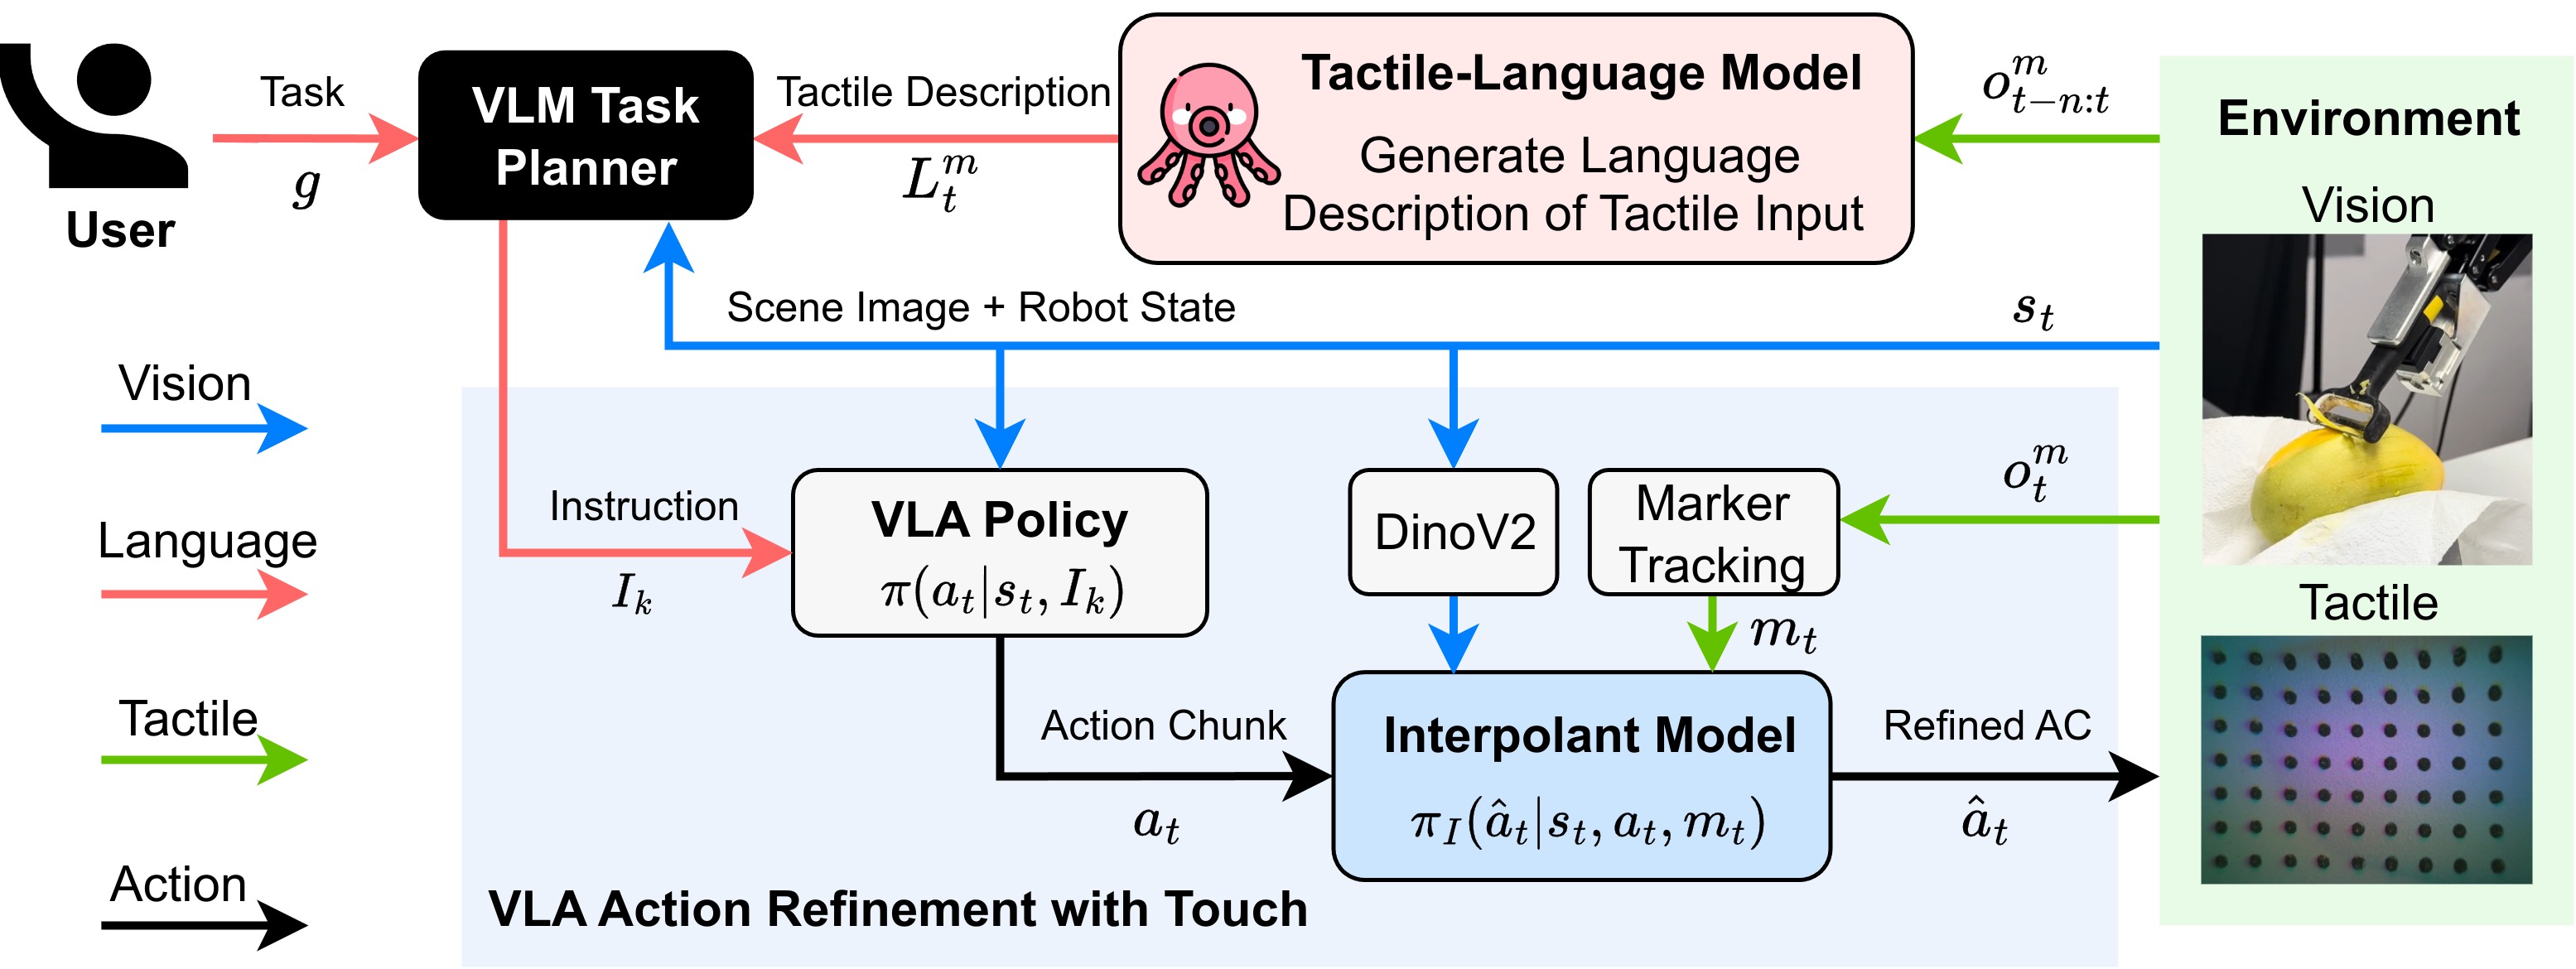


![Vla Models Example Task Input/output [2403.09631] 3D-VLA: A 3D Vision-Language-Action Generative World Model](https://ar5iv.labs.arxiv.org/html/2403.09631/assets/x2.png)
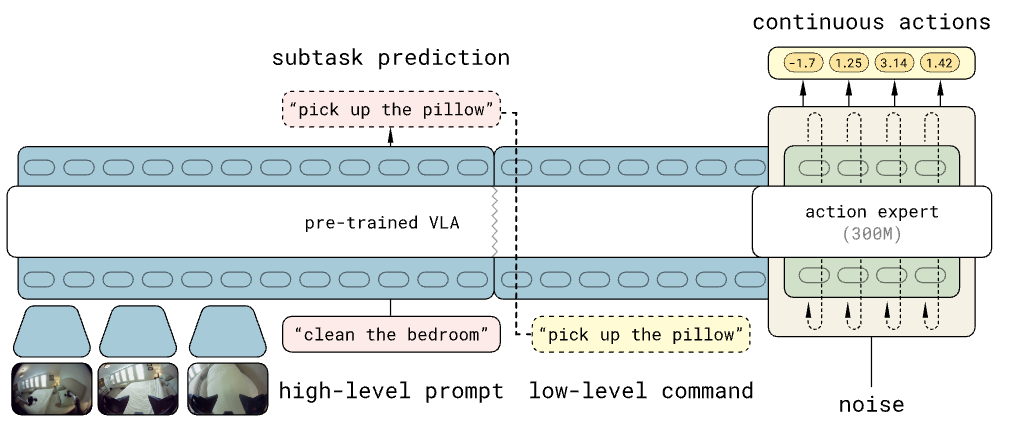


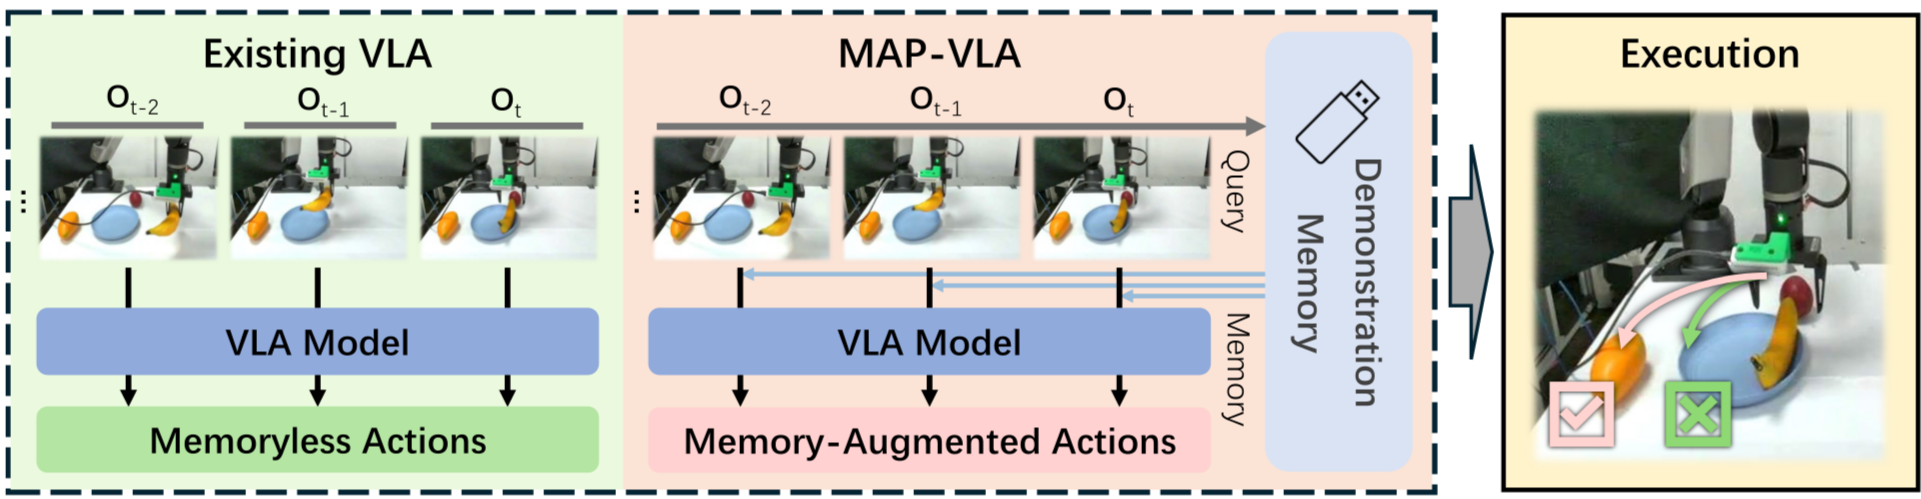
![Vla Models Example Task Input/output [논문 리뷰] MAP-VLA: Memory-Augmented Prompting for Vision-Language-Action ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/map-vla-memory-augmented-prompting-for-vision-language-action-model-in-robotic-manipulation-1.png)


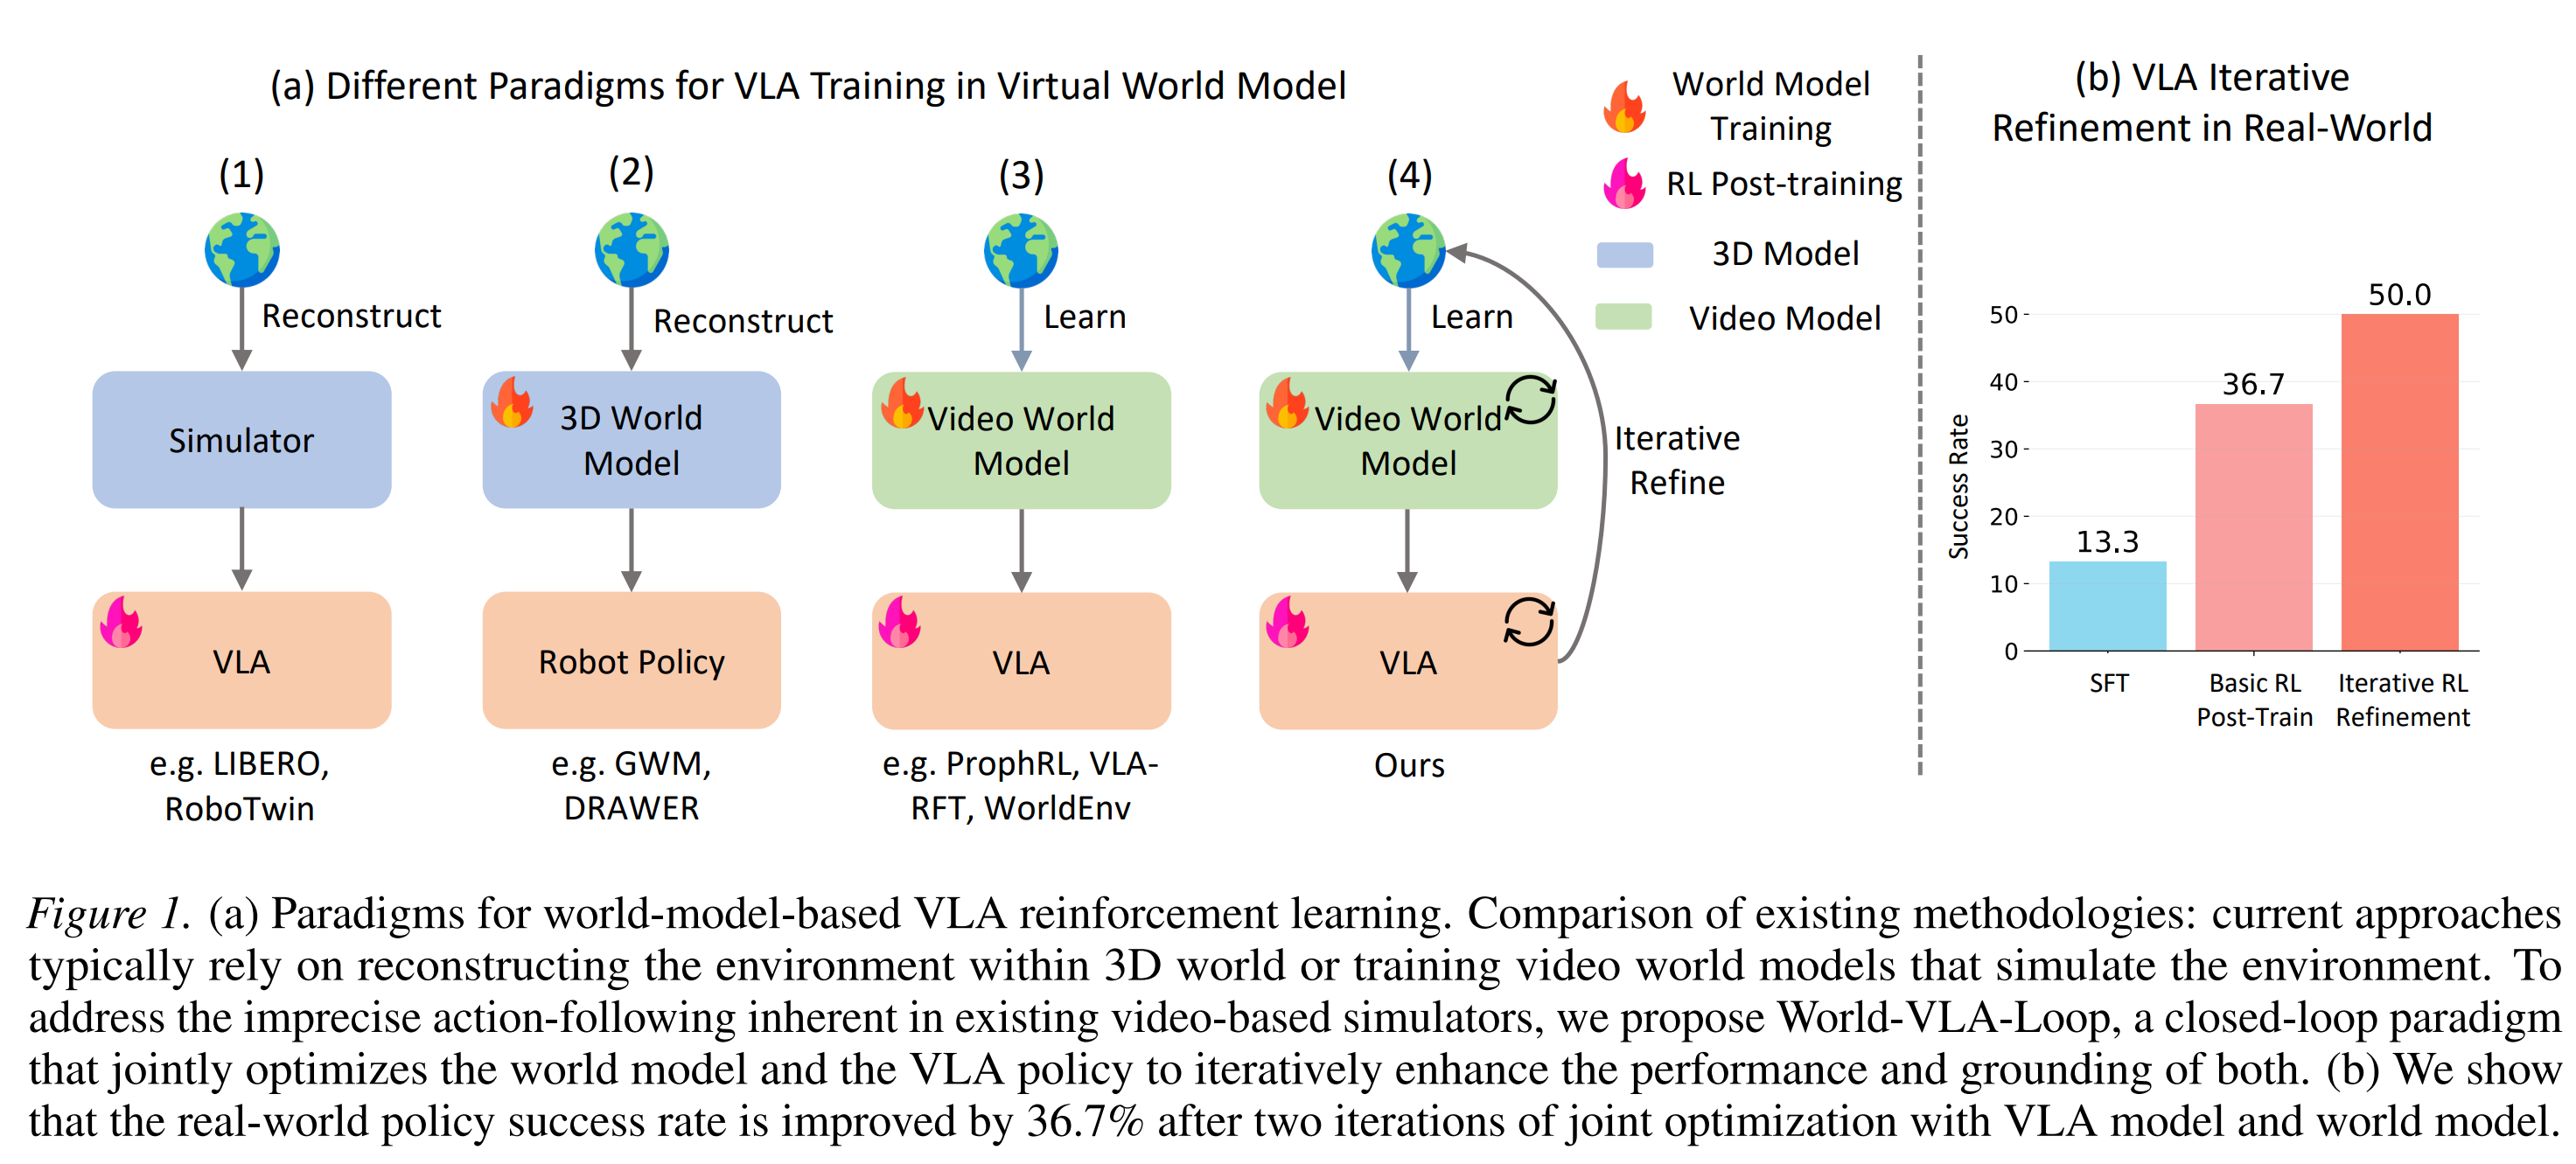
![Vla Models Example Task Input/output [논문 리뷰] World-VLA-Loop: Closed-Loop Learning of Video World Model and ...](https://velog.velcdn.com/images/wjdghks987/post/0da86ead-d739-4cba-9f71-eac36737a176/image.png)
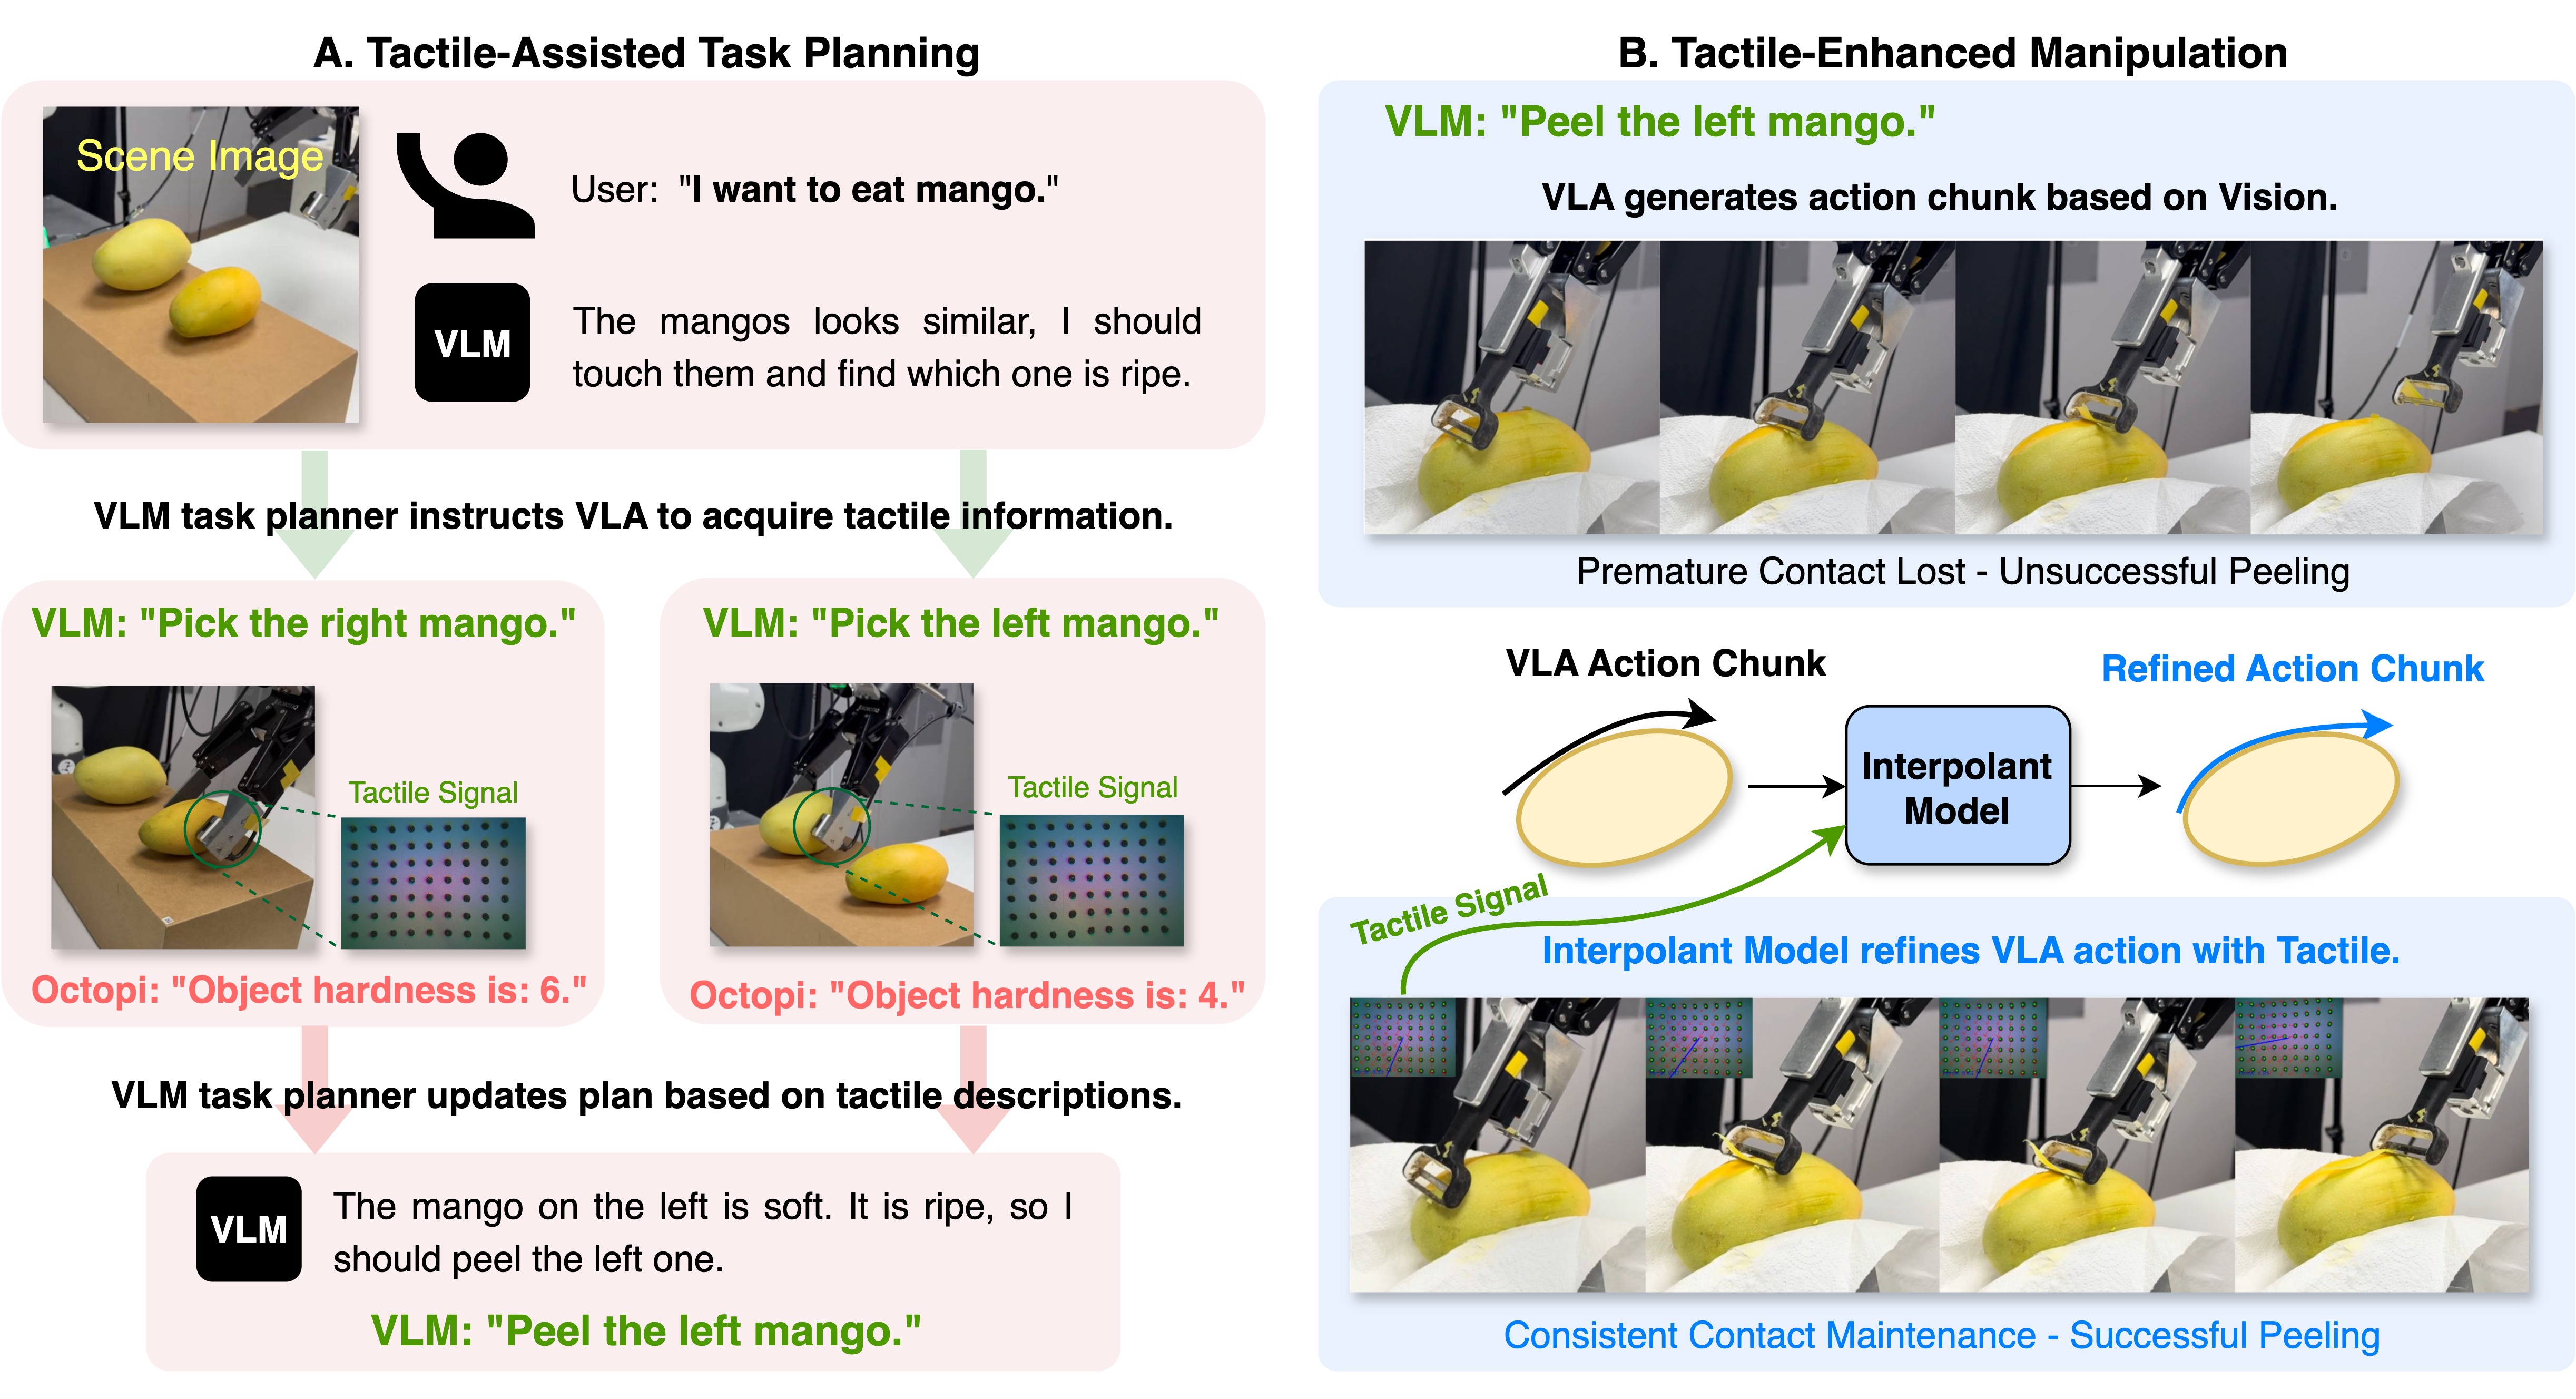


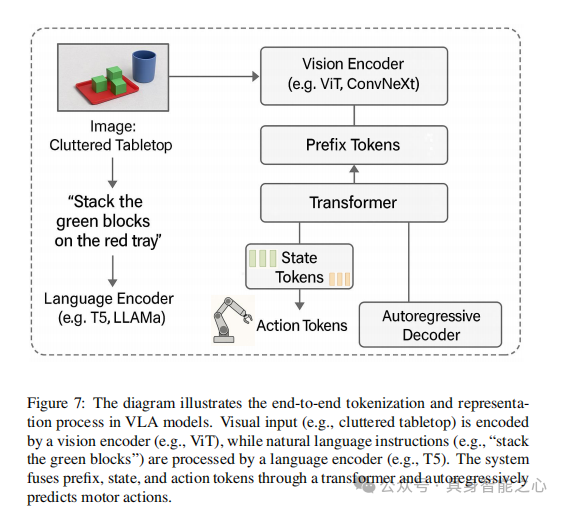
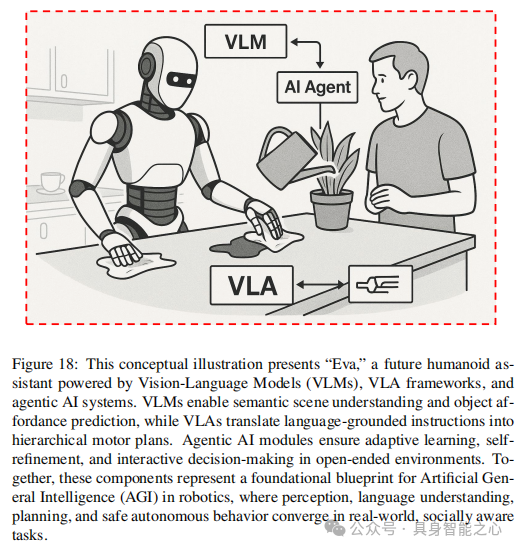
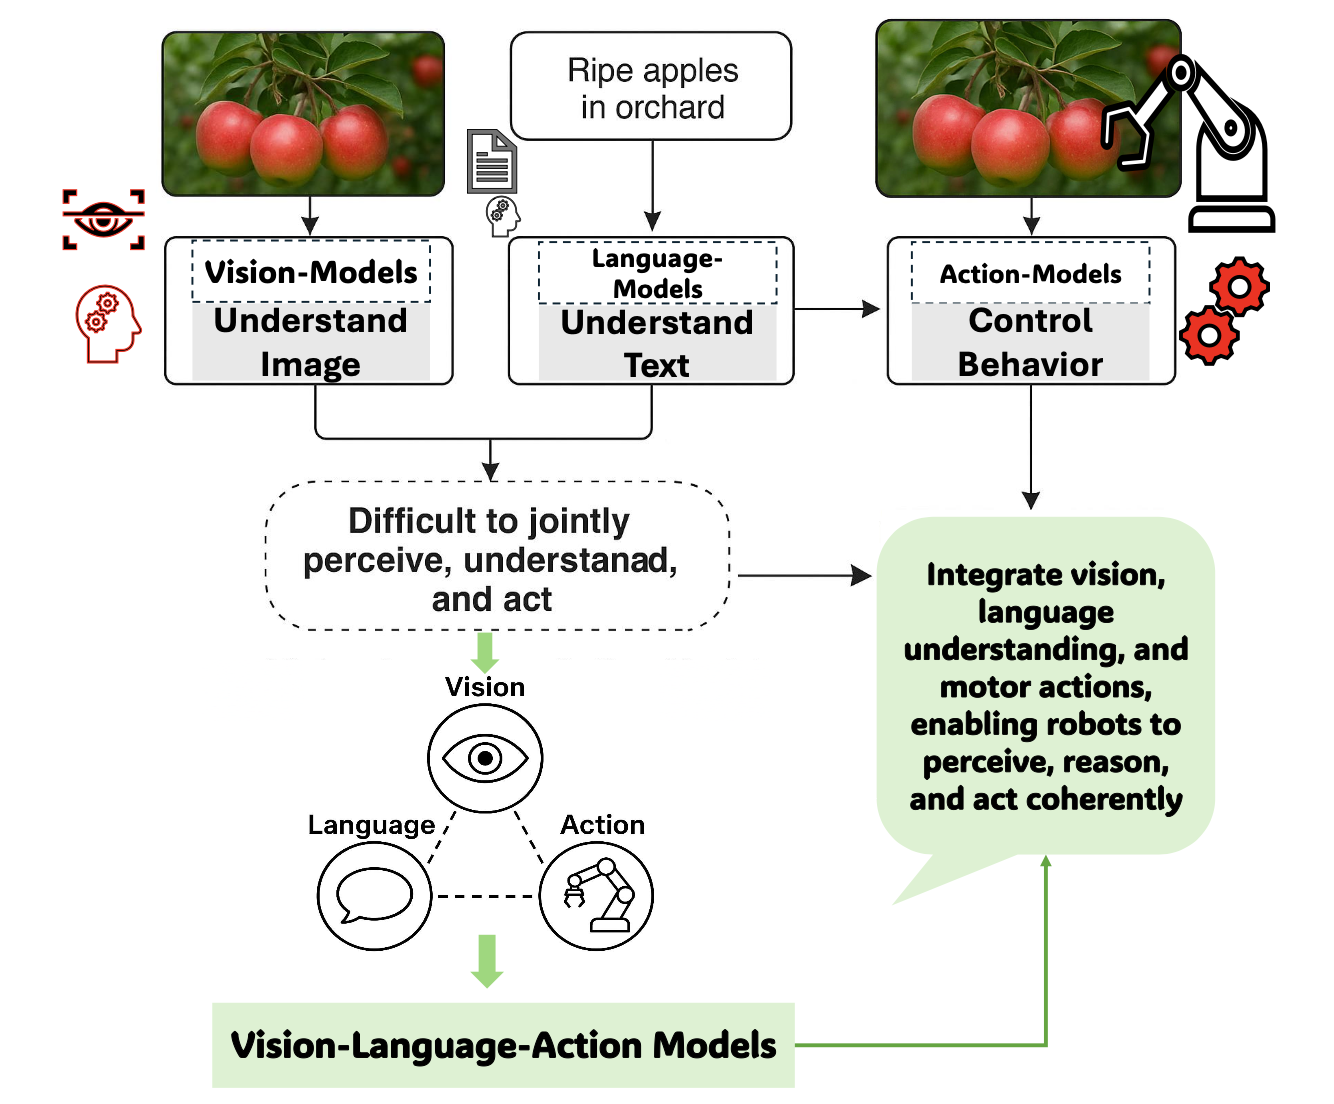
![Vla Models Example Task Input/output [2505.04769] Vision-Language-Action Models: Concepts, Progress ...](https://ar5iv.labs.arxiv.org/html/2505.04769/assets/x3.png)