Vision Tokens Grid
Advance progress through extensive collections of tech-focused Vision Tokens Grid photographs. innovatively presenting photography, images, and pictures. designed to demonstrate technological advancement. Each Vision Tokens Grid image is carefully selected for superior visual impact and professional quality. Suitable for various applications including web design, social media, personal projects, and digital content creation All Vision Tokens Grid images are available in high resolution with professional-grade quality, optimized for both digital and print applications, and include comprehensive metadata for easy organization and usage. Our Vision Tokens Grid gallery offers diverse visual resources to bring your ideas to life. Instant download capabilities enable immediate access to chosen Vision Tokens Grid images. The Vision Tokens Grid archive serves professionals, educators, and creatives across diverse industries. Regular updates keep the Vision Tokens Grid collection current with contemporary trends and styles. Professional licensing options accommodate both commercial and educational usage requirements. The Vision Tokens Grid collection represents years of careful curation and professional standards. Reliable customer support ensures smooth experience throughout the Vision Tokens Grid selection process. Whether for commercial projects or personal use, our Vision Tokens Grid collection delivers consistent excellence. Each image in our Vision Tokens Grid gallery undergoes rigorous quality assessment before inclusion.


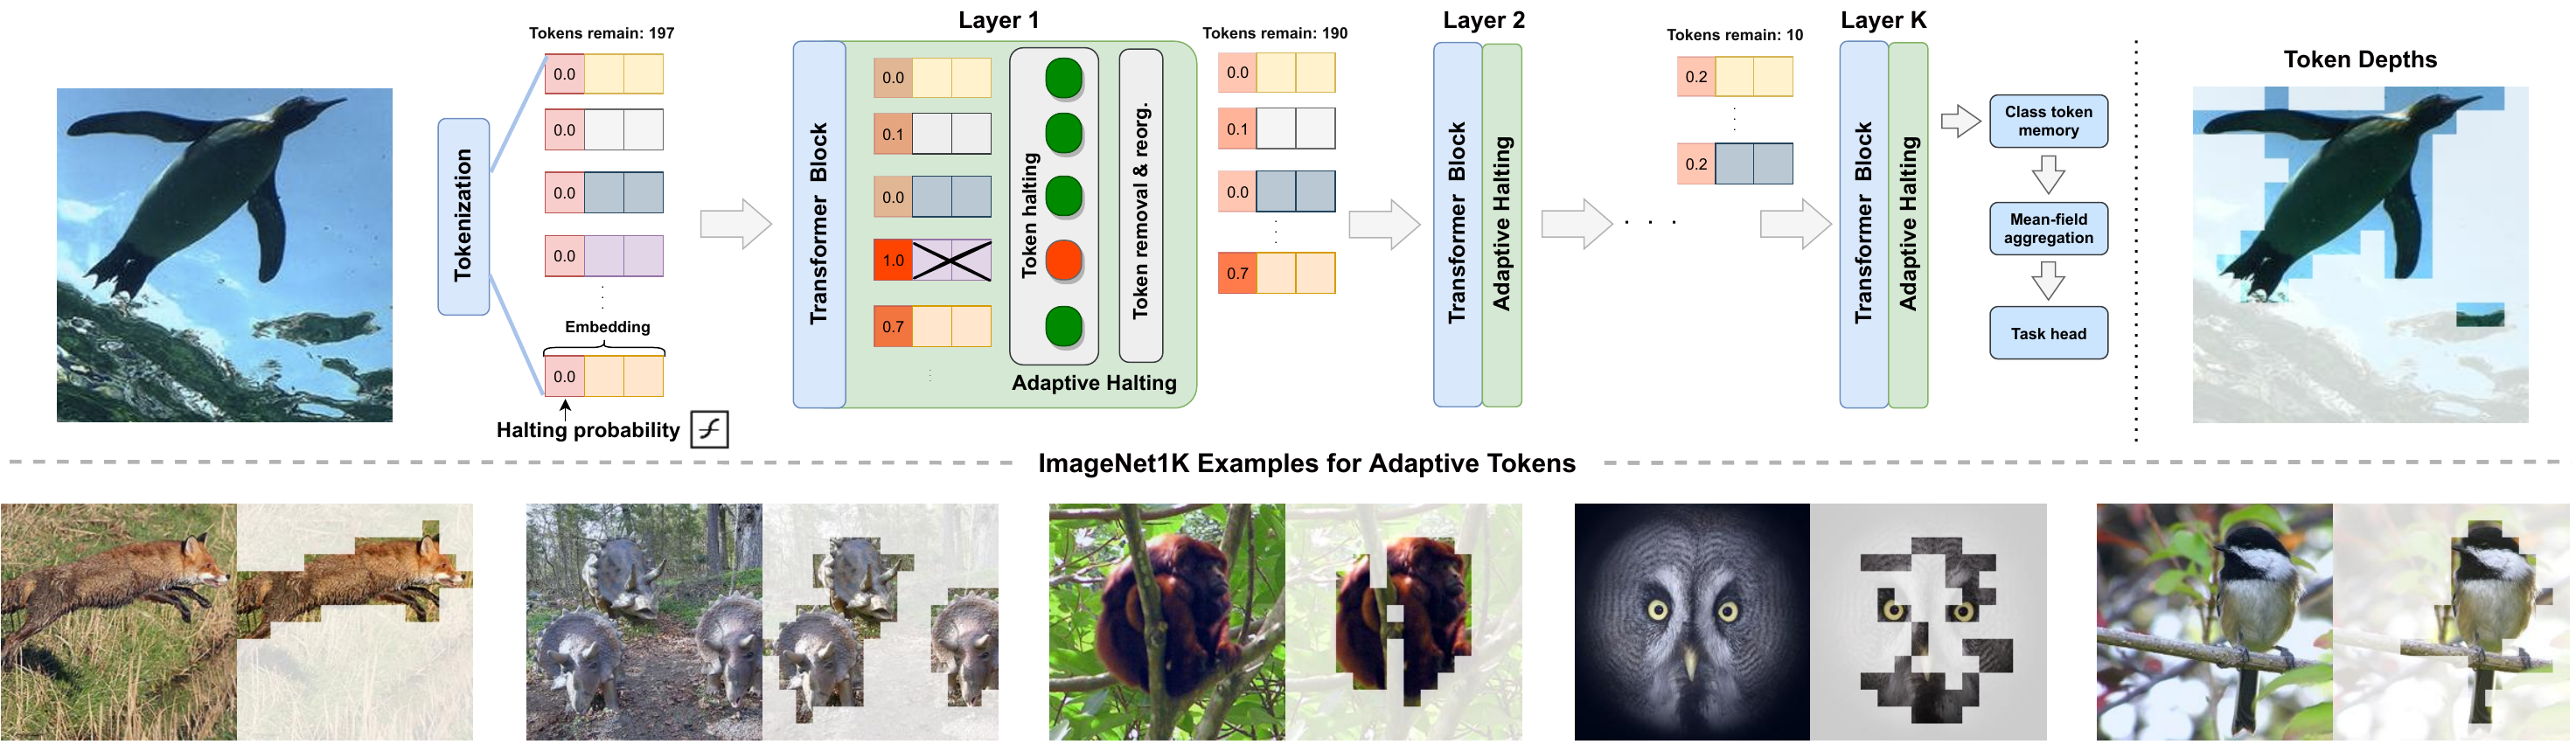
![Vision Tokens Grid [论文评述] AT-SNN: Adaptive Tokens for Vision Transformer on Spiking Neural ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/at-snn-adaptive-tokens-for-vision-transformer-on-spiking-neural-network-0.png)


![Vision Tokens Grid [论文评述] Efficient Token Compression for Vision Transformer with Spatial ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/efficient-token-compression-for-vision-transformer-with-spatial-information-preserved-0.png)


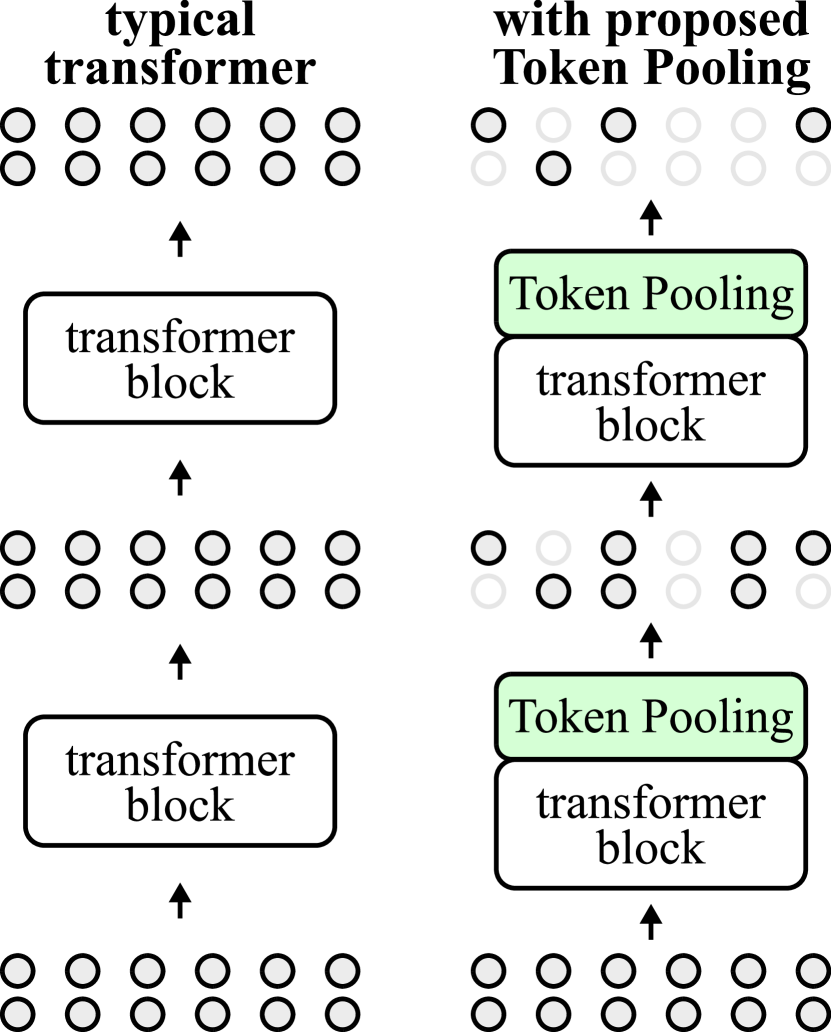
![Vision Tokens Grid [2110.03860] Token Pooling in Vision Transformers](https://ar5iv.labs.arxiv.org/html/2110.03860/assets/x1.png)


![Vision Tokens Grid [Token]Token merging for Vision Generation_token fusion: bridging the ...](https://i-blog.csdnimg.cn/direct/a12da379531d48a8b67c96d187532903.png)


![Vision Tokens Grid [论文评述] Lossless Token Merging Even Without Fine-Tuning in Vision ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/lossless-token-merging-even-without-fine-tuning-in-vision-transformers-0.png)


![Vision Tokens Grid [논문 리뷰] TAP into the Patch Tokens: Leveraging Vision Foundation Model ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/tap-into-the-patch-tokens-leveraging-vision-foundation-model-features-for-ai-generated-image-detection-0.png)


![Vision Tokens Grid [CVPR‘22-Oral] Not All Tokens Are Equal Human-centric Visual Analysis ...](https://img-blog.csdnimg.cn/97e571331eb64f1a95a272dc5b2a638f.png)


![Vision Tokens Grid [CVPR‘22-Oral] Not All Tokens Are Equal Human-centric Visual Analysis ...](https://img-blog.csdnimg.cn/06b35982723a4748bcbb2b09ec761bca.png)


![Vision Tokens Grid [2512.08923] Same Content, Different Answers: Cross-Modal Inconsistency ...](https://ar5iv.labs.arxiv.org/html/2512.08923/assets/figures/rest_plus_vision_tokens_consistency.png)


![Vision Tokens Grid [论文评述] HERO: Rethinking Visual Token Early Dropping in High-Resolution ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/hero-rethinking-visual-token-early-dropping-in-high-resolution-large-vision-language-models-2.png)

![Vision Tokens Grid [2211.11315] Beyond Attentive Tokens: Incorporating Token Importance ...](https://ar5iv.labs.arxiv.org/html/2211.11315/assets/x3.png)


![Vision Tokens Grid [Revisión de artículo] Token Expand-Merge: Training-Free Token ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/token-expand-merge-training-free-token-compression-for-vision-language-action-models-0.png)


