Clip Text Supervised Vision Model
Promote sustainability through countless eco-focused Clip Text Supervised Vision Model photographs. environmentally documenting photography, images, and pictures. perfect for environmental campaigns and education. The Clip Text Supervised Vision Model collection maintains consistent quality standards across all images. Suitable for various applications including web design, social media, personal projects, and digital content creation All Clip Text Supervised Vision Model images are available in high resolution with professional-grade quality, optimized for both digital and print applications, and include comprehensive metadata for easy organization and usage. Our Clip Text Supervised Vision Model gallery offers diverse visual resources to bring your ideas to life. Instant download capabilities enable immediate access to chosen Clip Text Supervised Vision Model images. Reliable customer support ensures smooth experience throughout the Clip Text Supervised Vision Model selection process. Cost-effective licensing makes professional Clip Text Supervised Vision Model photography accessible to all budgets. Whether for commercial projects or personal use, our Clip Text Supervised Vision Model collection delivers consistent excellence. Each image in our Clip Text Supervised Vision Model gallery undergoes rigorous quality assessment before inclusion. Our Clip Text Supervised Vision Model database continuously expands with fresh, relevant content from skilled photographers. Comprehensive tagging systems facilitate quick discovery of relevant Clip Text Supervised Vision Model content.
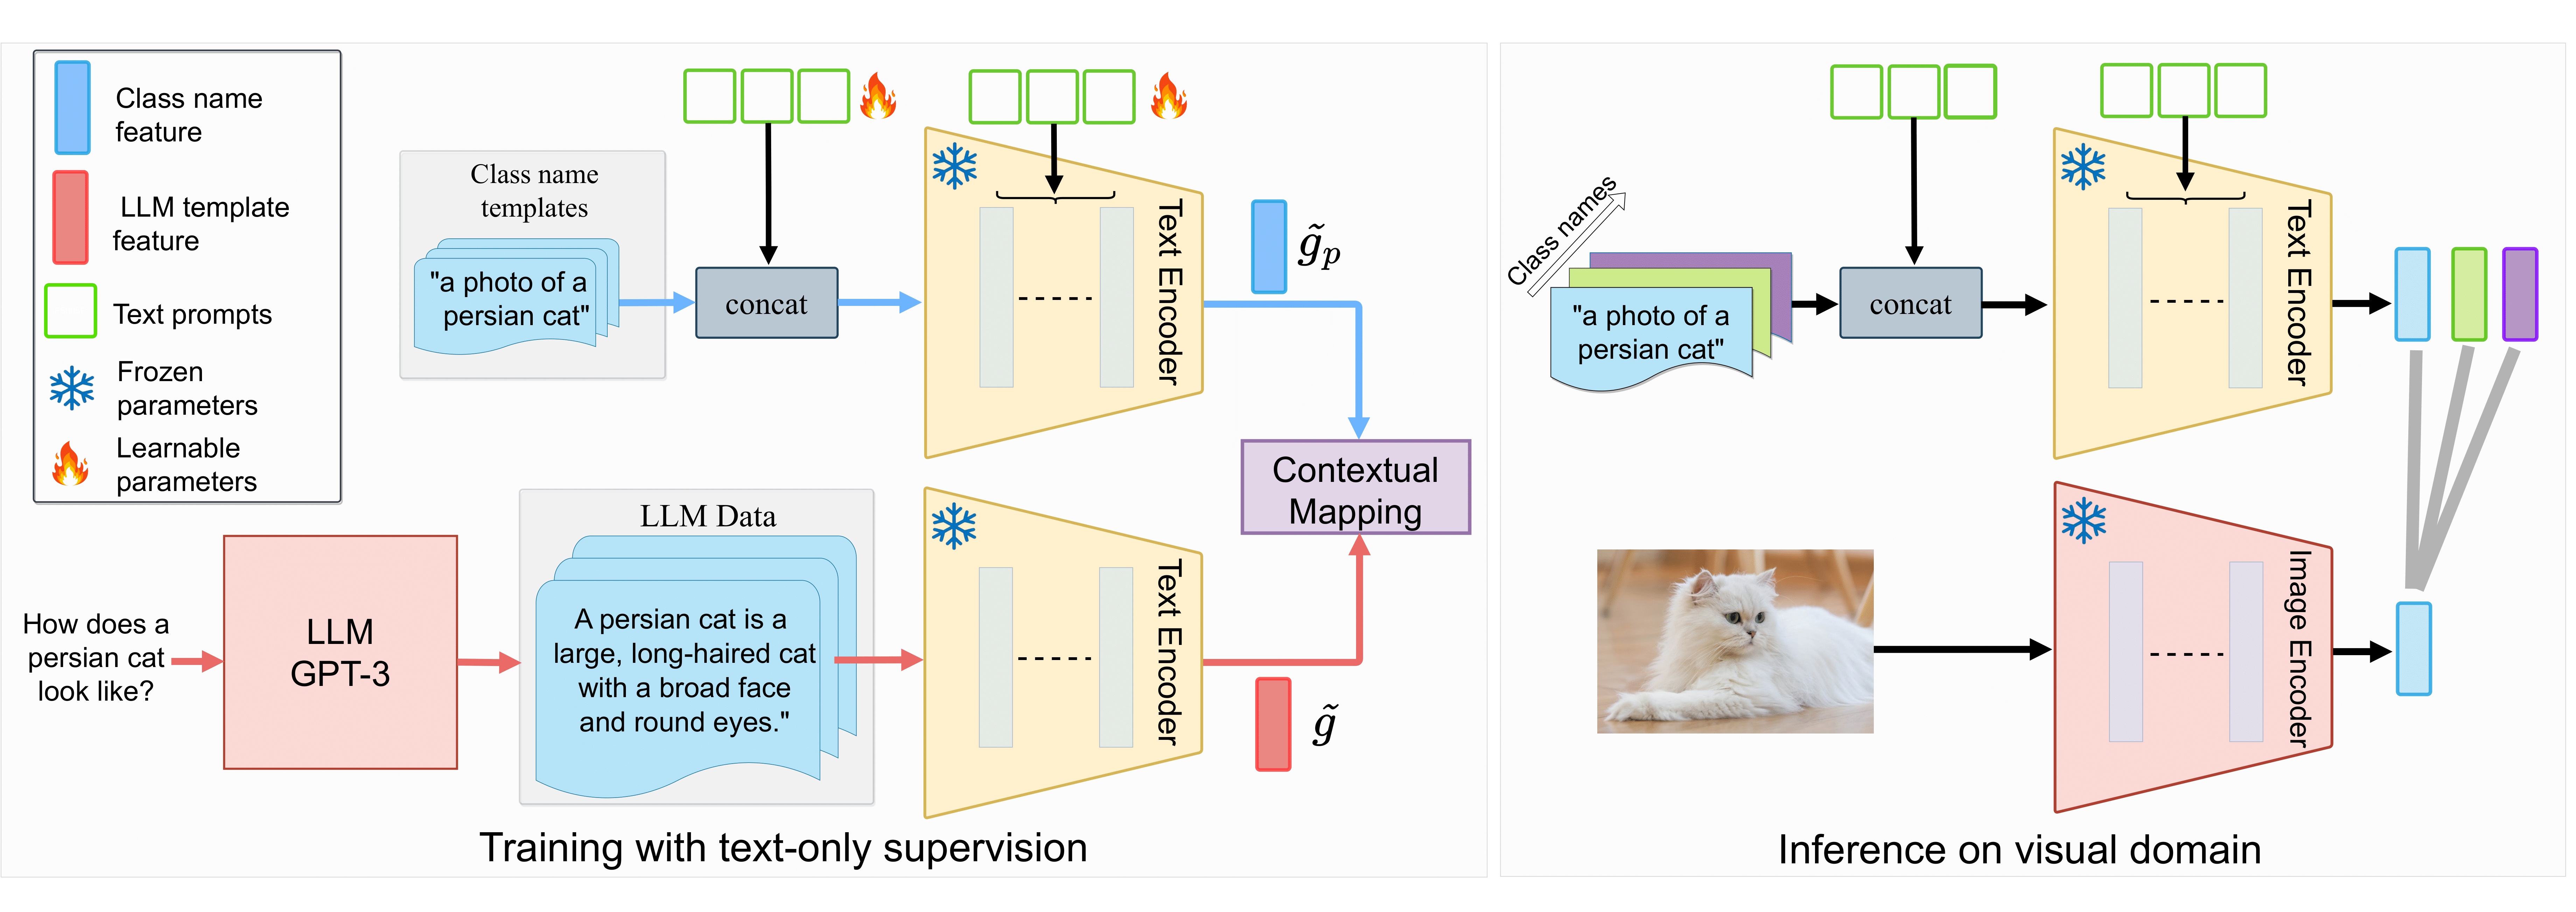


![Clip Text Supervised Vision Model [Feature Request]: CLIP Driven Universal Model · Issue #5800 · Project ...](https://user-images.githubusercontent.com/58751975/210440462-4607db99-72a3-4908-ad8e-68e7186282d2.png)


![Clip Text Supervised Vision Model [2410.00982] ScVLM: Enhancing Vision-Language Model for Safety-Critical ...](https://ar5iv.labs.arxiv.org/html/2410.00982/assets/pics/CLIP_supervised_learning.png)
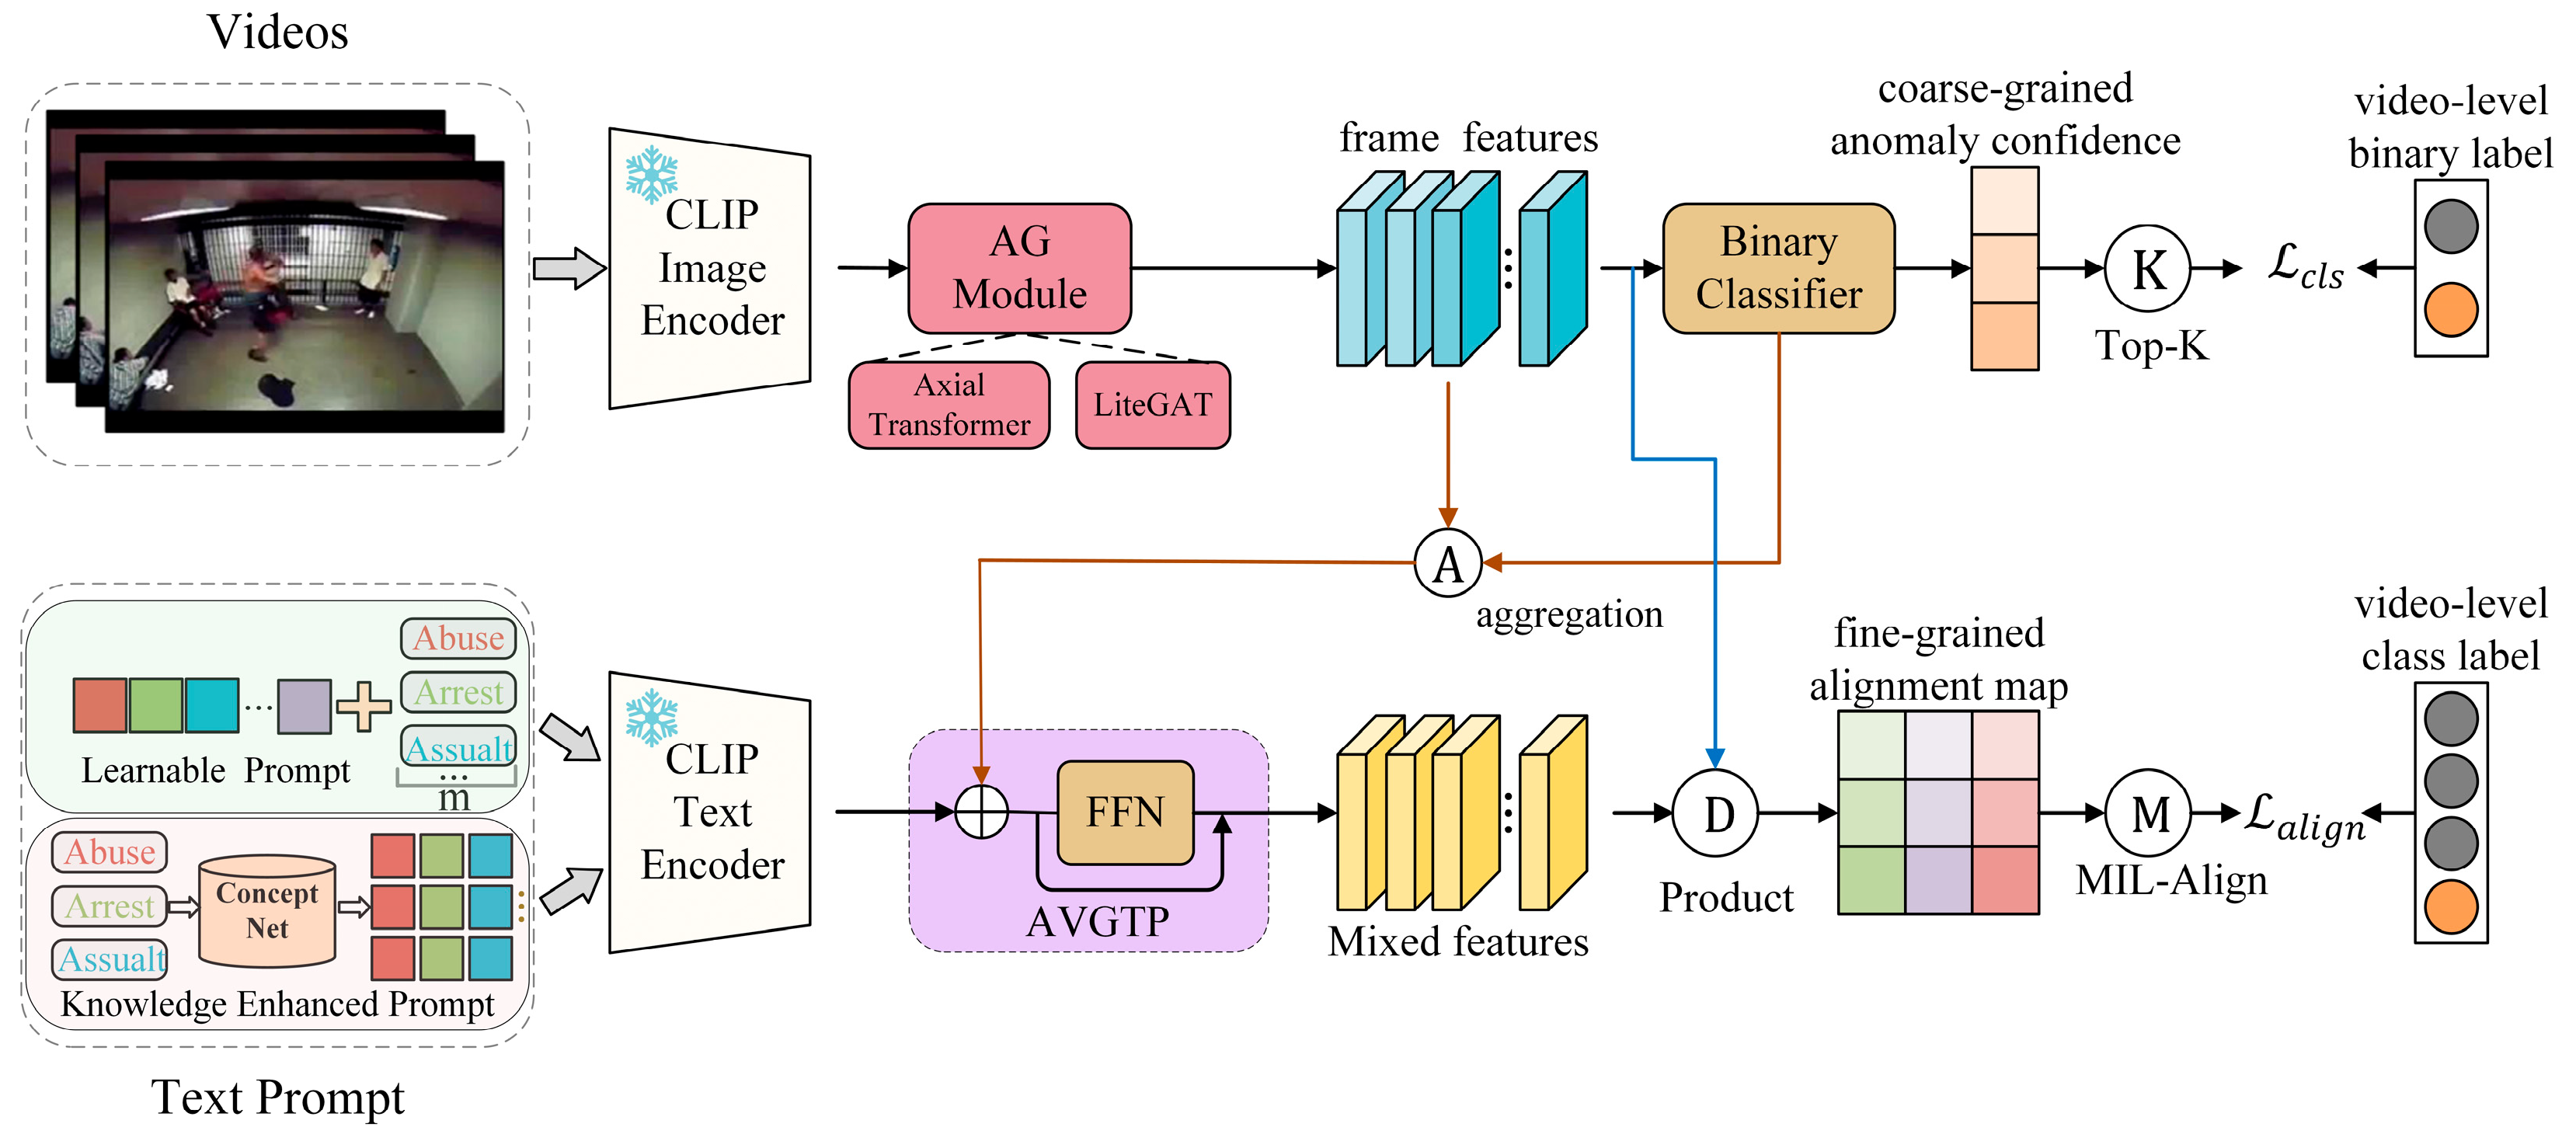


![Clip Text Supervised Vision Model [논문 리뷰] Toward Modality Gap: Vision Prototype Learning for Weakly ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/toward-modality-gap-vision-prototype-learning-for-weakly-supervised-semantic-segmentation-with-clip-0.png)
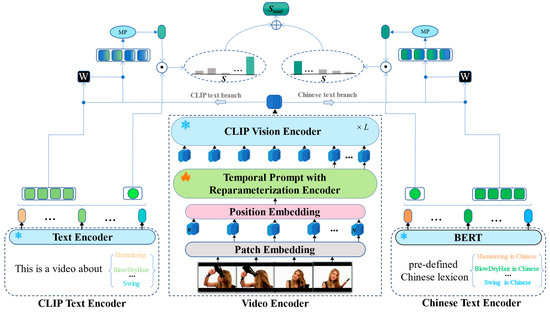
![Clip Text Supervised Vision Model [2304.00685] Vision-Language Models for Vision Tasks: A Survey](https://ar5iv.labs.arxiv.org/html/2304.00685/assets/x7.png)


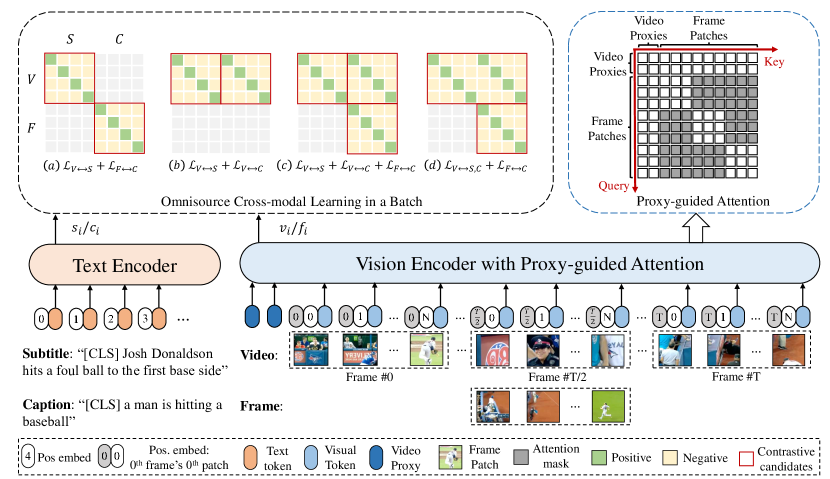
![Clip Text Supervised Vision Model [2209.06430] CLIP-ViP: Adapting Pre-trained Image-Text Model to Video ...](https://ar5iv.labs.arxiv.org/html/2209.06430/assets/x2.png)
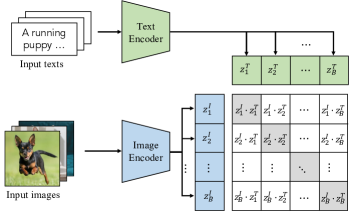


.png)


![Clip Text Supervised Vision Model [2203.03911] Language Matters: A Weakly Supervised Vision-Language Pre ...](https://ar5iv.labs.arxiv.org/html/2203.03911/assets/x2.png)
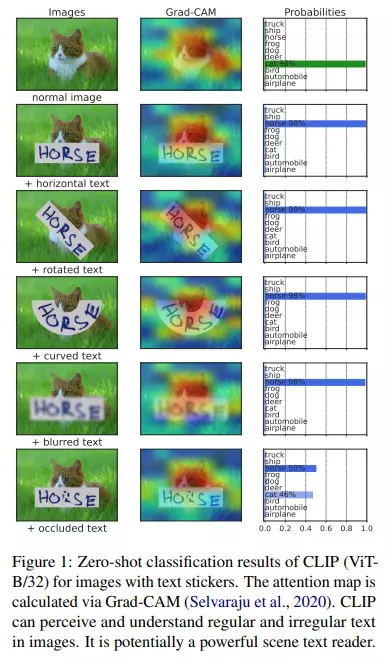
![Clip Text Supervised Vision Model [논문 리뷰] CLIP (Learning Transferable Visual Models From Natural Language ...](https://velog.velcdn.com/images/tony3ynot/post/0a6036be-1c5b-4c52-acb0-c0ec6b9d8ad0/image.png)
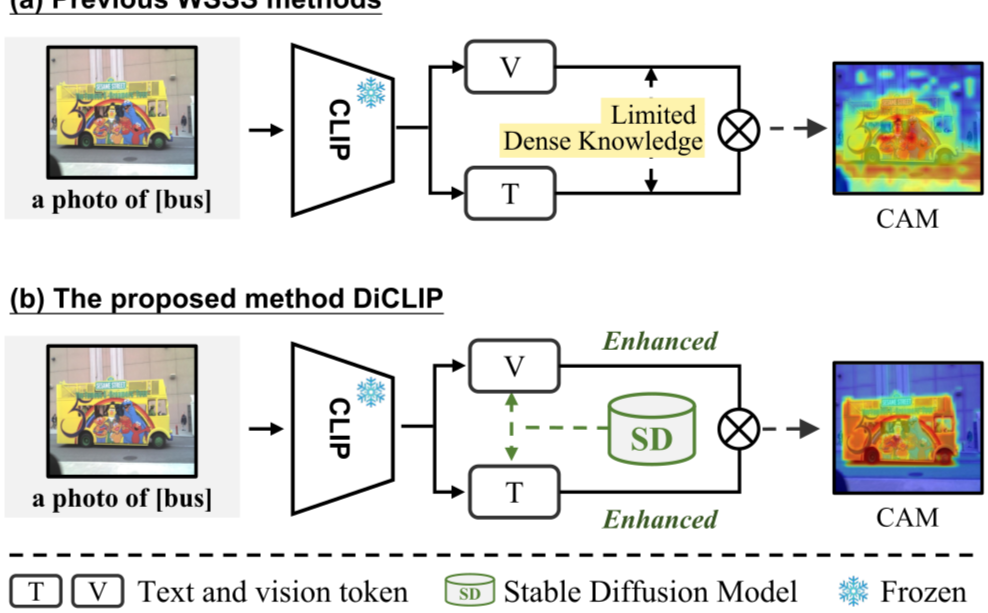
![Clip Text Supervised Vision Model [논문 리뷰] DiCLIP: Diffusion Model Enhances CLIP's Dense Knowledge for ...](https://moonlight-paper-snapshot.s3.ap-northeast-2.amazonaws.com/arxiv/diclip-diffusion-model-enhances-clips-dense-knowledge-for-weakly-supervised-semantic-segmentation-0.png)
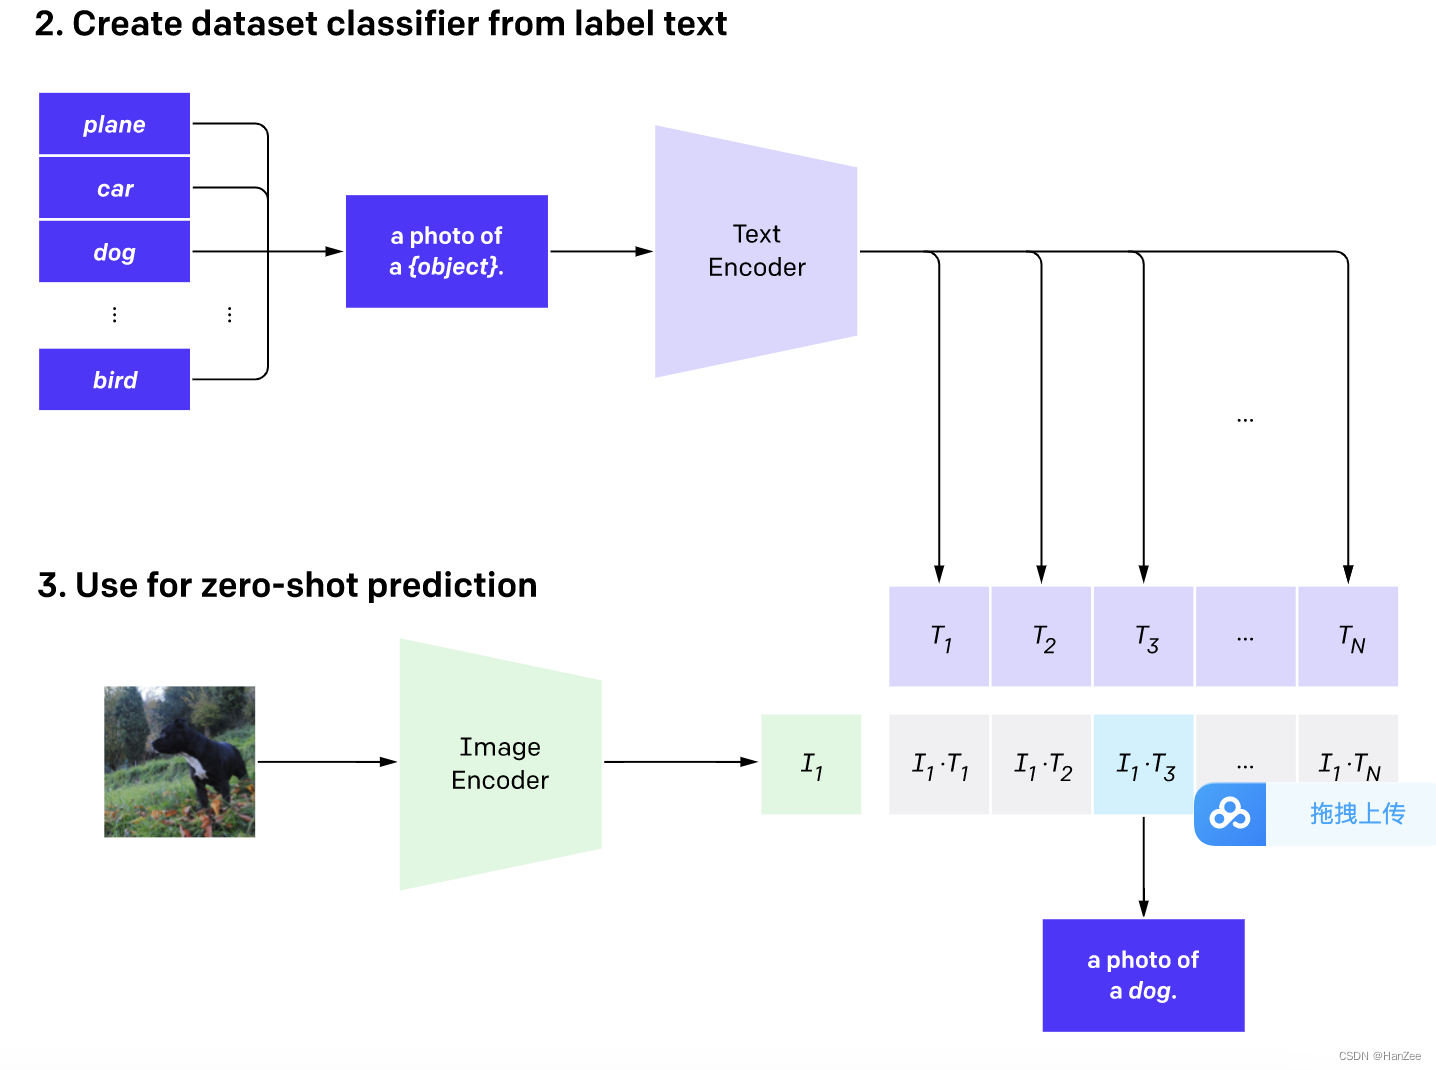


![Clip Text Supervised Vision Model [2410.00982] ScVLM: Enhancing Vision-Language Model for Safety-Critical ...](https://ar5iv.labs.arxiv.org/html/2410.00982/assets/pics/supervised_learning_structure.png)


![Clip Text Supervised Vision Model [2112.02399] VT-CLIP: Enhancing Vision-Language Models with Visual ...](https://ar5iv.labs.arxiv.org/html/2112.02399/assets/x1.png)


![Clip Text Supervised Vision Model [阅读笔记6][CLIP]Learning Transferable Visual Models From Natural Language ...](https://img-blog.csdnimg.cn/direct/591d83ac98854f9586972f7317e55728.png)

![Clip Text Supervised Vision Model [Multimodal_01] Scaling Up Visual and Vision-Language Representation ...](https://velog.velcdn.com/images/gyfla1512/post/5efd3073-1912-4c08-bb3d-1fca1d84b868/image.png)
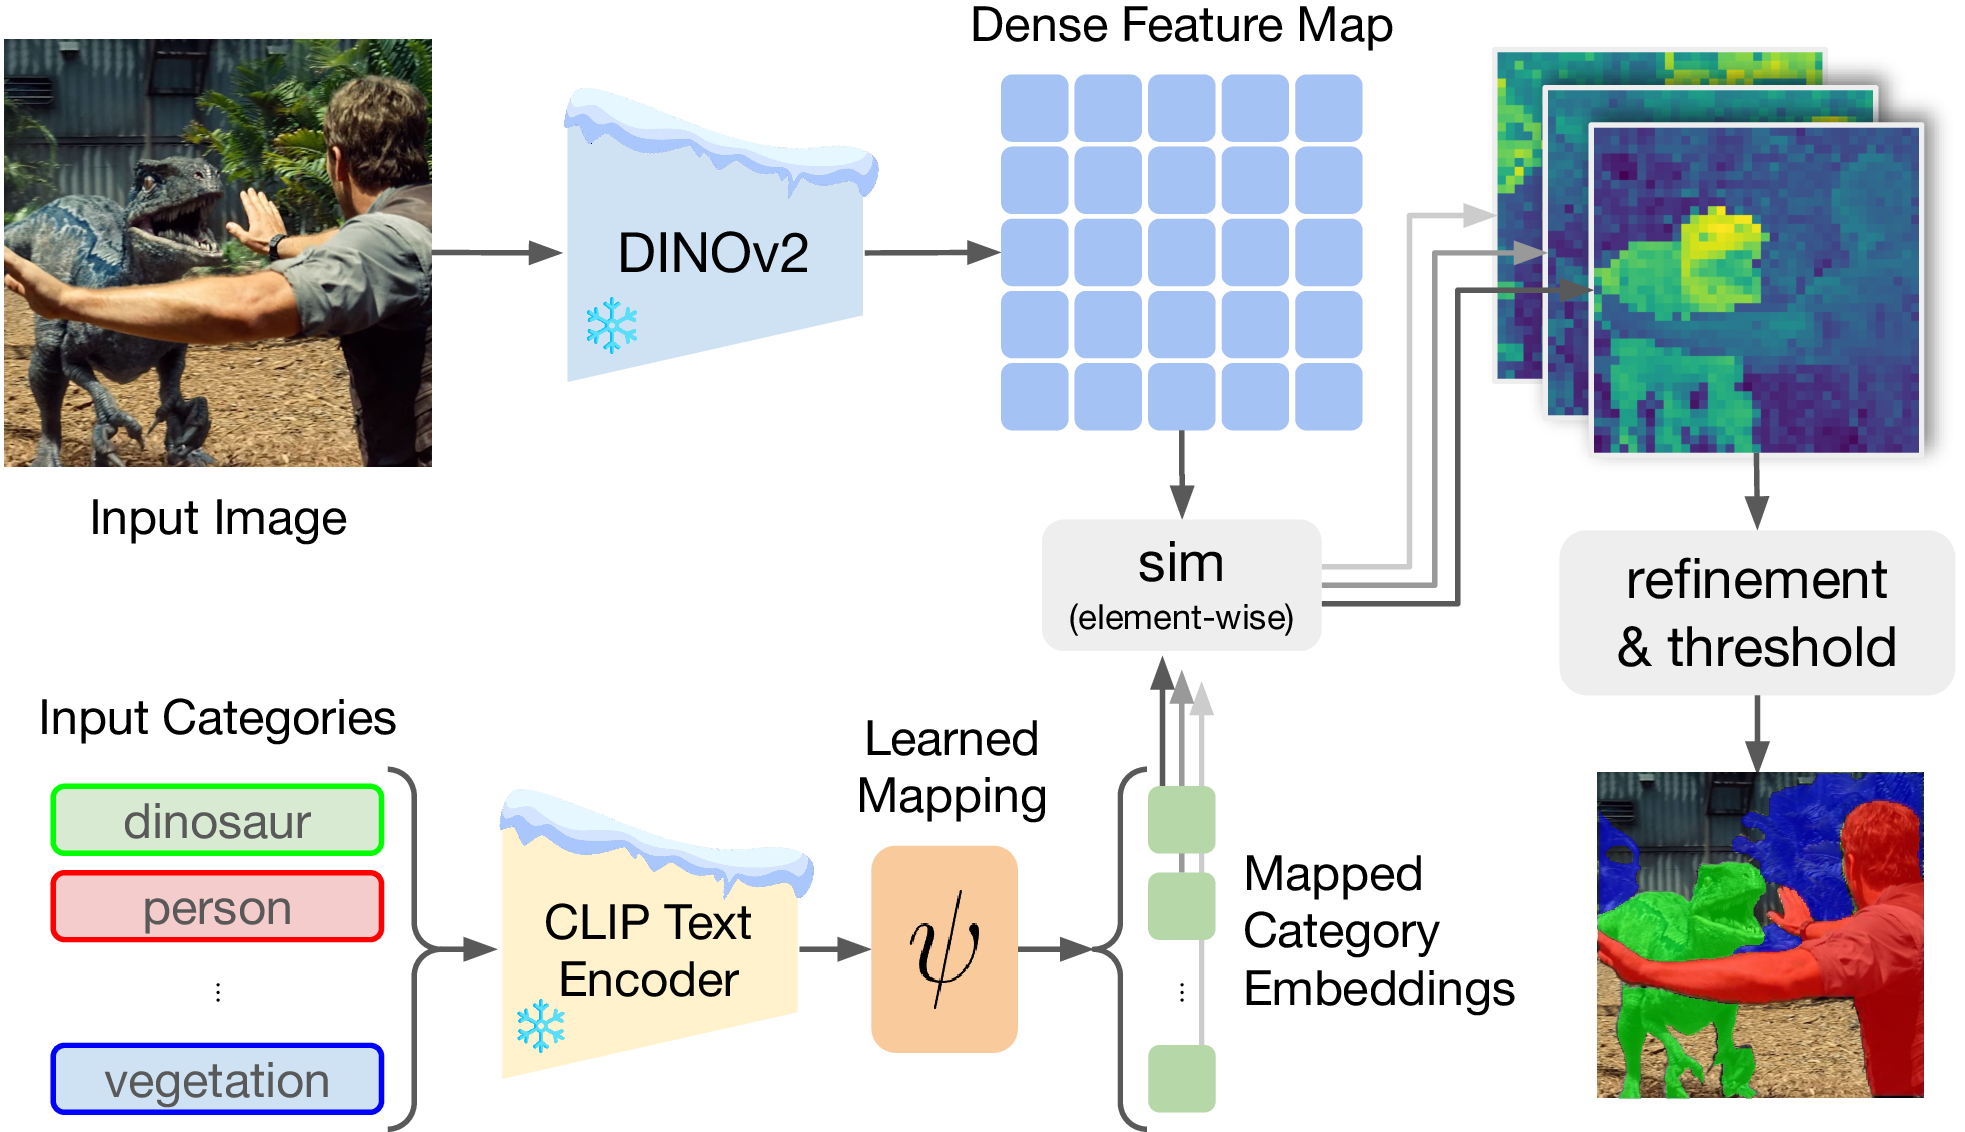
![Clip Text Supervised Vision Model [논문 리뷰] CLIP: Learning Transferable Visual Models From Natural Language ...](https://user-images.githubusercontent.com/89712324/224334264-3c15deaf-8c62-404d-8394-4e10a8797051.png)
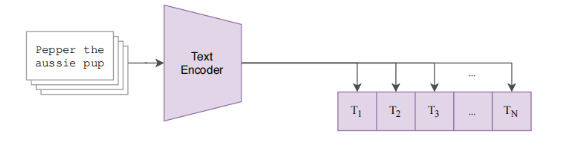


![Clip Text Supervised Vision Model [논문 리뷰] CLIP: Learning Transferable Visual Models From Natural Language ...](https://user-images.githubusercontent.com/89712324/224334488-395fdc70-0970-4887-9a1a-3b2c328b9fb5.png)


![Clip Text Supervised Vision Model [论文笔记] CLIP: Learning Transferable Visual Models From Natural Language ...](https://pic4.zhimg.com/v2-ffb36c1f6a7a18c6d770b52c55c4cfc5_r.jpg)


![Clip Text Supervised Vision Model [2412.00134] PP-SSL: Priority-Perception Self-Supervised Learning for ...](https://ar5iv.labs.arxiv.org/html/2412.00134/assets/sec/Clip_distill.jpg)